
Confidentialité des données IA : qui voit vos prompts ?
43 % des entreprises françaises qui utilisent déjà l'intelligence artificielle se disent freinées par la protection des données. Le chiffre vient de l'INSEE et il explique à lui seul pourquoi OpenAI a consacré une partie de son DevDay du 29 septembre 2026 à un sujet peu spectaculaire : la confidentialité des données IA. Sous le nom de Private Intelligence, l'éditeur promet que ses propres équipes ne pourront plus lire ce que vous lui envoyez. Derrière l'annonce se cache une technologie précise, l'inférence confidentielle, qui déplace la question du terrain juridique vers le terrain matériel. Jusqu'ici, la confidentialité reposait sur une promesse contractuelle. Elle commence à reposer sur une preuve vérifiable. Voici ce que cela change pour une PME, et surtout ce que cela ne change pas.
-

- Dernière modification
30 septembre 2026 - 9 minutes de lecture
Que voit vraiment un fournisseur d'IA quand vous envoyez un prompt ?
Un fournisseur d'IA voit votre prompt en clair, au moins pendant quelques millisecondes. C'est la réponse courte, et elle surprend souvent les dirigeants que nous accompagnons. Votre message voyage bien chiffré jusqu'au serveur, et il est bien chiffré quand il dort dans une base de données. Mais entre les deux, il doit être déchiffré pour être calculé. Un modèle de langage ne sait pas travailler sur du texte chiffré.
Ce moment de calcul porte un nom : l'inférence, c'est-à-dire la phase où le modèle lit votre demande et produit sa réponse, par opposition à l'entraînement où il apprend. C'est le seul instant où vos données existent en clair dans la mémoire d'une machine qui ne vous appartient pas. Tout le débat de 2026 tient dans cette fenêtre.
Il faut donc distinguer trois engagements que les fournisseurs présentent souvent en bloc, alors qu'ils sont indépendants :
- L'entraînement : vos données servent-elles à améliorer le modèle ? Sur les offres professionnelles d'OpenAI, d'Anthropic et de Google, la réponse est non, contractuellement, depuis mars 2023 pour l'API d'OpenAI.
- La rétention : combien de temps vos échanges sont-ils stockés ? Environ 30 jours par défaut pour l'API d'OpenAI comme pour celle d'Anthropic, au titre de la lutte contre les abus.
- La confidentialité pendant le calcul : un salarié du fournisseur, ou un attaquant qui aurait pris la main sur le serveur, peut-il lire votre prompt à l'instant où il est traité ? C'est le seul point sur lequel presque personne ne garantissait quoi que ce soit avant 2026.
Cette confusion a un coût très concret. Beaucoup d'entreprises croient avoir réglé la question parce qu'elles ont signé un avenant interdisant l'entraînement sur leurs données. Elles ont réglé un tiers du problème.
Private Intelligence : ce qu'OpenAI a annoncé le 29 septembre 2026
Private Intelligence est le nom que donne OpenAI à un ensemble de deux briques présentées au DevDay du 29 septembre 2026 : l'une est disponible, l'autre ne l'est pas encore. La distinction est essentielle avant de prendre une décision d'achat.
La première brique s'appelle ZDR with Private Safety Processing. Elle est disponible aujourd'hui. Le principe : votre contenu est chiffré et déposé dans un stockage que vous contrôlez, chez AWS S3, Azure Blob ou Google Cloud Storage. OpenAI ne garde qu'un index et des métadonnées, pas de copie lisible. Le contrôle de sécurité, celui qui vérifie qu'on n'utilise pas le modèle pour fabriquer une arme, s'exécute dans un environnement d'exécution attesté par le matériel. Seuls des signaux de sécurité prédéfinis en ressortent en clair. Les enregistrements protégés restent tout de même conservés 30 jours pour examen automatisé, et c'est à vous de gérer ce stockage et les autorisations de clés.
La seconde brique, Private Inference, est annoncée en aperçu pour l'automne 2026. C'est la plus ambitieuse : elle promet de faire tourner le modèle lui-même dans un environnement où personne, pas même OpenAI, ne peut lire les données en cours de traitement. OpenAI a donné très peu de détails. On ne sait ni quels modèles seront concernés, ni à quel prix, ni ce que le client pourra vérifier lui-même. Sur ce point précis, l'annonce reste une intention.
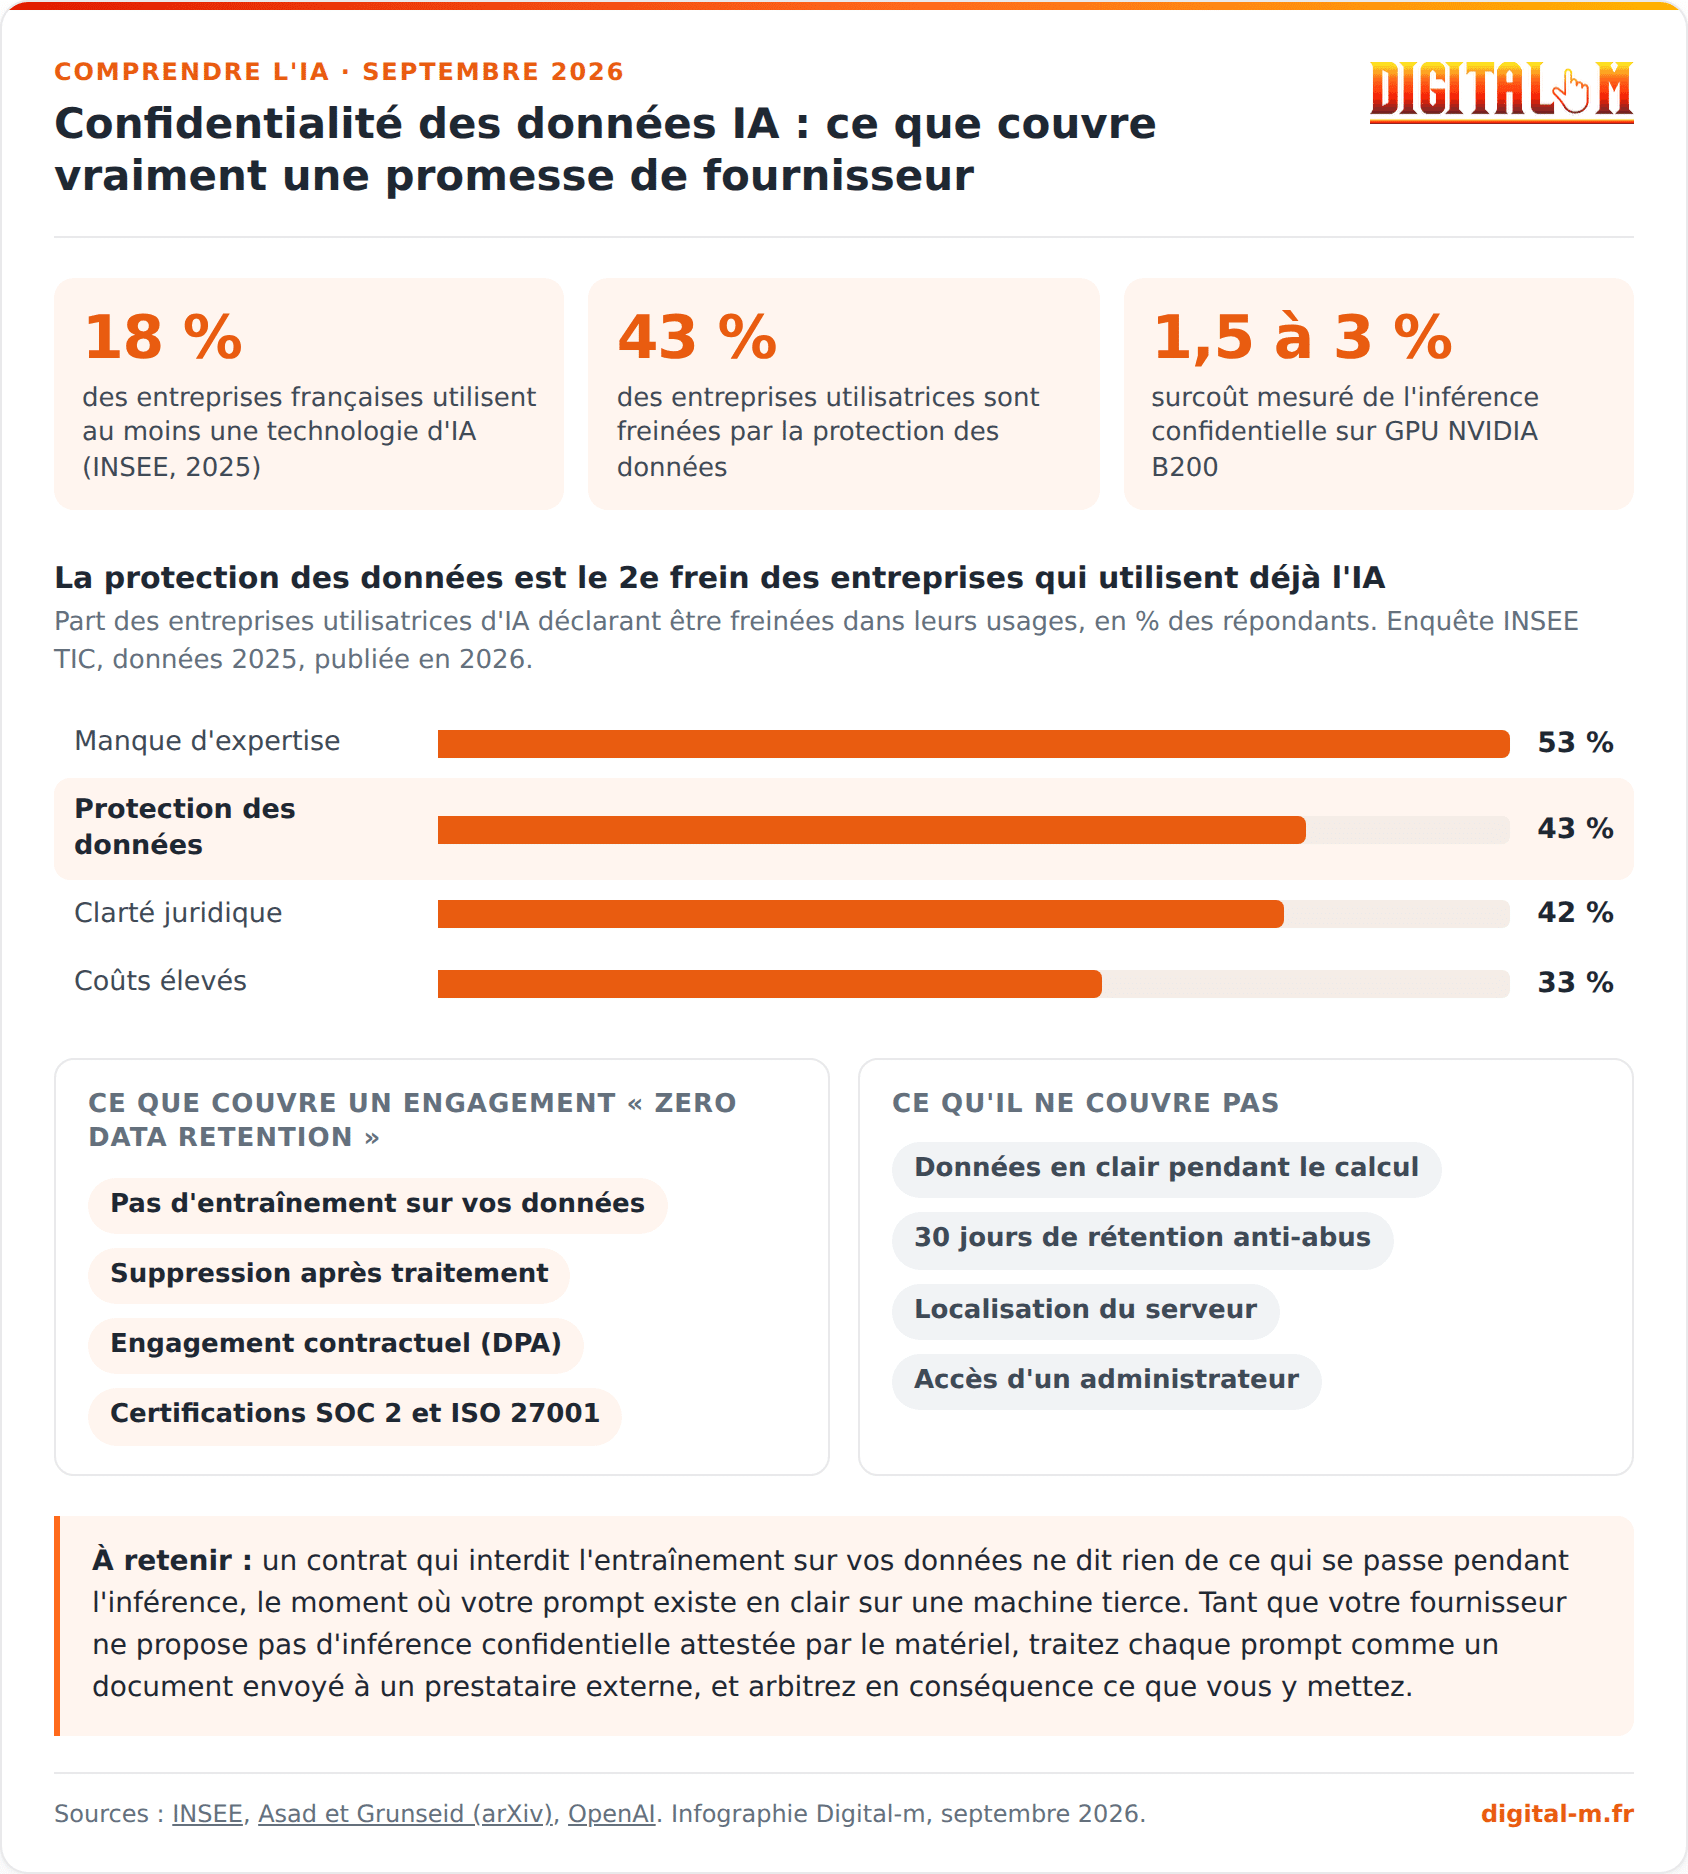
Confidentialité des données IA : ce que couvre vraiment une promesse de fournisseur

- 18 % des entreprises françaises utilisent au moins une technologie d'IA (INSEE, 2025)
- 43 % des entreprises utilisatrices sont freinées par la protection des données
- 1,5 à 3 % surcoût mesuré de l'inférence confidentielle sur GPU NVIDIA B200
La protection des données est le 2e frein des entreprises qui utilisent déjà l'IA
Part des entreprises utilisatrices d'IA déclarant être freinées dans leurs usages, en % des répondants. Enquête INSEE TIC, données 2025, publiée en 2026.
Ce que couvre un engagement « zero data retention »
Ce qu'il ne couvre pas
À retenir : un contrat qui interdit l'entraînement sur vos données ne dit rien de ce qui se passe pendant l'inférence, le moment où votre prompt existe en clair sur une machine tierce. Tant que votre fournisseur ne propose pas d'inférence confidentielle attestée par le matériel, traitez chaque prompt comme un document envoyé à un prestataire externe, et arbitrez en conséquence ce que vous y mettez.
Télécharger l'infographie (PNG)
Chiffrement, zero data retention, inférence confidentielle : ne confondez plus
Ces trois expressions désignent trois protections qui ne se remplacent pas. Un fournisseur peut cocher la première et la deuxième tout en laissant la troisième complètement ouverte, et c'est précisément la situation de la plupart des offres du marché en septembre 2026.
- Le chiffrement en transit et au repos : votre prompt est illisible pendant qu'il voyage et pendant qu'il est stocké. C'est la base, généralisée en AES-256, et cela ne protège pas le moment du calcul.
- Le zero data retention (ZDR) : rien n'est conservé après traitement. Chez Anthropic, cette option existe sur les API éligibles avec une clé commerciale, mais pas sur les modèles les plus récents. Chez OpenAI, elle se demande et concerne les points d'entrée entreprise.
- L'inférence confidentielle : le calcul lui-même se déroule dans une zone que l'hébergeur ne peut pas inspecter. Aucun des trois grands ne la proposait en standard au premier semestre 2026.
Il existe une quatrième dimension que les fournisseurs mettent rarement en avant : la localisation. L'offre ChatGPT Business héberge par exemple vos données aux États-Unis, sous clauses contractuelles types, et la résidence des données en Union européenne est réservée au palier Enterprise. Pour une entreprise qui traite des dossiers médicaux, des données RH ou des pièces juridiques, ce détail décide souvent du projet.
Le confidential computing, expliqué sans jargon
Le confidential computing, littéralement l'informatique confidentielle, consiste à isoler un calcul dans une zone du processeur que personne ne peut ouvrir de l'extérieur, pas même l'administrateur de la machine. Appliqué à l'IA, il ferme enfin la fenêtre de l'inférence. Deux mécanismes le rendent possible.
L'enclave, un coffre à l'intérieur de la puce
Une enclave, aussi appelée TEE pour Trusted Execution Environment (environnement d'exécution de confiance), est une zone mémoire chiffrée par le processeur lui-même. Le système d'exploitation voit qu'un calcul tourne, mais il ne peut pas lire son contenu. Côté processeur central, Intel TDX joue ce rôle. Côté carte graphique, NVIDIA a étendu la fonction à ses GPU Hopper puis Blackwell, avec une mémoire vidéo chiffrée et des liens NVLink protégés entre les puces.
L'attestation, la preuve que le coffre est bien fermé
L'attestation distante est le second pilier, et le plus intéressant pour un client. Avant d'envoyer vos données, votre logiciel demande au serveur une preuve cryptographique signée par le matériel : quel code tourne, dans quelle version, dans quel état de sécurité. Si la preuve ne correspond pas à ce qui était attendu, les données ne partent pas. On passe d'une promesse écrite à une vérification automatique, et c'est exactement ce qui manque encore à la plupart des offres d'IA.
Apple a été le premier acteur grand public à industrialiser cette approche avec Private Cloud Compute. À la WWDC 2026, la firme a annoncé étendre ce dispositif à Google Cloud, sur des GPU NVIDIA Blackwell, pour faire tourner ses modèles de fondation appuyés sur la technologie Gemini. Un fabricant de téléphones qui publie l'architecture de sécurité de ses serveurs et la fait auditer, c'était inédit. Cela a posé un standard auquel les autres sont désormais comparés.
Où en sont OpenAI, Anthropic, Google, Mistral et les modèles ouverts ?
Aucun fournisseur ne propose aujourd'hui l'inférence confidentielle par défaut sur ses modèles les plus puissants. Voici l'état réel du marché fin septembre 2026, à vérifier auprès de chaque éditeur avant tout engagement, car les conditions évoluent vite.
| Acteur | Entraînement sur vos données | Rétention par défaut (API) | Inférence confidentielle |
|---|---|---|---|
| OpenAI (GPT-6.1 Sol) | Non, exclu depuis mars 2023 | Environ 30 jours | Private Inference en aperçu, automne 2026 |
| Anthropic (Claude) | Non sur les conditions commerciales | Environ 30 jours | Design publié, disponibilité commerciale non confirmée |
| Google (Gemini, Vertex AI) | Non sur l'API payante et Vertex | Rétention limitée | Confidential computing disponible sur l'infrastructure, pas sur les modèles gérés |
| Mistral AI | Non, avec option de déploiement dédié | Selon le contrat | Déploiement sur site, la question ne se pose plus de la même façon |
| Modèles ouverts (Llama, Qwen, DeepSeek, GLM) | Sans objet | Aucune, vous hébergez | Vous maîtrisez toute la chaîne |
Côté grand public, la vigilance vaut aussi pour Perplexity et Grok : leurs conditions gratuites sont systématiquement moins protectrices que leurs offres professionnelles, et les paramètres de confidentialité méritent une lecture avant d'y déposer un document client. La règle est constante chez tous les éditeurs, y compris Anthropic, dont l'application grand public active l'amélioration du modèle par défaut depuis août 2025 et demande une désactivation manuelle.
Le cas Mistral AI mérite une lecture à part. Après une levée de 3 milliards d'euros en septembre 2026, l'éditeur français défend une définition très pragmatique de la souveraineté : non pas l'autarcie technologique, mais la capacité à ne pas dépendre d'un fournisseur unique. Son offre Forge permet d'adapter les modèles aux données propriétaires d'une entreprise, et ses modèles en poids ouverts peuvent tourner entièrement sur votre infrastructure. Quand le modèle ne quitte pas vos murs, la question de l'inférence confidentielle disparaît par construction.
C'est aussi ce qui explique le regain d'intérêt pour les modèles en poids ouverts de Meta, Alibaba ou DeepSeek. Chez Digital-m, nous auditons régulièrement des stacks IA de PME, et le schéma revient souvent : les données les plus sensibles partent vers un petit modèle auto-hébergé, le reste vers GPT, Gemini ou Claude selon la tâche. Notre article sur l'IA en local et le matériel nécessaire pour faire tourner un modèle sur son propre poste détaille cette bascule.
Combien coûte vraiment l'inférence confidentielle ?
Le surcoût de performance de l'inférence confidentielle se situe entre 1,5 % et 3 % dans une configuration optimisée, et descend sous 1 % sur un seul GPU avec des graphes CUDA complets. Ces chiffres viennent d'une étude publiée en juin 2026 par Amean Asad et Ansgar Grunseid, mesurée sur huit GPU NVIDIA B200 associés à un processeur Intel Xeon 6767P en mode Intel TDX, avec des modèles comme MiniMax-M2.7, Qwen3.5-397B et Nemotron-3-Super-120B. Précision d'honnêteté : cette étude est signée par Confidential.ai, une société dont l'activité même est le calcul confidentiel. Il s'agit donc d'un test maison, non répliqué à ce jour par un tiers indépendant.
Le même travail montre l'envers du décor. Sur une configuration non optimisée, le surcoût grimpe à 35 ou 40 %. Sur des réponses courtes de 256 tokens, ces unités de texte qui servent aussi d'unité de facturation, il atteint encore 14 %. Autrement dit, la technologie est prête mais son réglage ne l'est pas partout, et un fournisseur qui vous annonce « quelques pourcents » parle d'un cas idéal.
Côté facture, l'arbitrage se joue ailleurs. Une offre ChatGPT Business coûte environ 21 € TTC par utilisateur et par mois en engagement annuel, soit près de 2 520 € TTC par an pour une équipe de dix personnes, et environ 26 € TTC en paiement mensuel. La garantie de non-entraînement y est contractuelle, pas automatique : l'avenant de traitement des données doit être signé depuis la console d'administration avant d'inviter vos collaborateurs. Beaucoup d'équipes l'ignorent et travaillent des mois sans cette signature.
Notez enfin qu'OpenAI a présenté GPT-6.1 Sol au cinquième du coût en tokens de son prédécesseur. La baisse des prix bruts continue donc, ce qui laisse de la marge budgétaire pour financer les garanties de confidentialité plutôt que pour consommer davantage.
Ce qu'une PME doit vérifier avant de brancher une IA sur ses données
La bonne question n'est pas « cet outil est-il sûr » mais « quelle catégorie de données ai-je le droit d'y mettre ». La CNIL a d'ailleurs cadré le sujet dans ses recommandations sur l'IA et le RGPD publiées le 7 février 2025, qui demandent aux organisations utilisant un modèle tiers de documenter leurs traitements et de rester capables de répondre aux demandes d'exercice des droits.
Voici la trame que nous utilisons dans nos audits, à dérouler dans cet ordre :
- Classez vos données avant de choisir l'outil : trois niveaux suffisent, données publiques, données internes, données sensibles ou personnelles. Chaque niveau reçoit un outil autorisé et un seul.
- Vérifiez la localisation, pas seulement le contrat : demandez la région d'hébergement par écrit et le mécanisme de transfert hors Union européenne le cas échéant.
- Signez l'avenant de traitement des données : chez la plupart des éditeurs, la protection ne s'active qu'à cette signature, souvent accessible en un clic depuis la console d'administration.
- Demandez la durée de rétention réelle : y compris pour les contenus signalés par les filtres de sécurité, qui peuvent être conservés bien au-delà de 30 jours.
- Formez vos équipes au risque d'exfiltration : un collaborateur qui colle un contrat client dans une interface gratuite annule tous vos efforts contractuels. Le sujet rejoint celui de la prompt injection, cette technique qui détourne une IA par de simples instructions cachées.
- Tracez les usages : un registre simple, qui utilise quoi et pour quel type de données, suffit à passer un contrôle et à repérer les dérives.
Ce travail n'exige pas un budget de grand groupe. Il exige de la méthode, et il se fait en quelques jours. C'est typiquement ce que nous intégrons dans nos formations certifiées Qualiopi sur l'IA et le GEO, parce qu'un salarié formé protège mieux vos données qu'une charte affichée au mur. La menace côté attaquant progresse en parallèle, comme le montre notre point sur l'état des cyberattaques assistées par IA en 2026.
Ce qu'il faut retenir
La confidentialité des données IA se joue sur quatre plans indépendants : l'entraînement, la rétention, la localisation et le calcul lui-même. Les trois premiers sont couverts par contrat chez les grands fournisseurs. Le quatrième, l'inférence, restait ouvert jusqu'aux annonces de 2026.
Private Intelligence, présenté par OpenAI le 29 septembre 2026, apporte une brique immédiatement disponible, le contrôle de sécurité en environnement attesté, et une promesse pour l'automne, Private Inference, encore peu documentée. Apple a montré la voie avec Private Cloud Compute, désormais étendu à Google Cloud sur GPU NVIDIA Blackwell. Mistral AI et les modèles en poids ouverts offrent une autre réponse, plus radicale : ne jamais laisser sortir les données. Et le surcoût technique, mesuré entre 1,5 % et 3 % dans le meilleur des cas, n'est plus l'obstacle qu'il était.
Pour une PME, la décision utile aujourd'hui est simple : classer ses données, associer un outil à chaque niveau, signer les avenants et former les équipes. Vous voulez savoir où votre entreprise en est réellement ? Demandez-nous un audit de votre usage de l'IA et de votre visibilité dans les moteurs génératifs, nous cartographions vos flux de données et vos risques avant de toucher à quoi que ce soit.
Et vous, savez-vous exactement quelles données de votre entreprise partent aujourd'hui vers un LLM ? Dites-le nous en commentaire !Sources et références
- OpenAI - DevDay 2026 Recap (29 septembre 2026)
- VentureBeat - OpenAI's new Private Intelligence targets a growing enterprise concern (septembre 2026)
- INSEE - Les technologies de l'information et de la communication dans les entreprises (2026)
- Amean Asad et Ansgar Grunseid, Confidential.ai - Benchmarking Confidential Computing Performance on NVIDIA Blackwell (juin 2026)
- NVIDIA - NVIDIA Confidential Computing to Help Expand Apple's Private Cloud Compute (2026)
- Apple Security Research - Expanding Private Cloud Compute (2026)
- CNIL - IA et RGPD, nouvelles recommandations (7 février 2025)
- Axoflow - A 2026 privacy map for Claude, GPT and Gemini
- Anthropic - API and data retention
- Bertrand Duperrin - Stratégie de Mistral AI, le pari au-delà des modèles (24 septembre 2026)
- Google Cloud - Powering the next era of Confidential AI
Questions fréquentes sur la confidentialité des données IA
Mes prompts sont-ils lus par des humains chez OpenAI ou Anthropic ?
Sur les offres professionnelles, l'examen est en principe automatisé et limité aux contenus signalés par les filtres de sécurité. Un examen humain reste possible dans ce cadre. Sur les versions gratuites, les règles sont moins favorables : les chats de l'application Gemini examinés par un humain peuvent par exemple être conservés jusqu'à trois ans. La brique ZDR with Private Safety Processing d'OpenAI vise justement à supprimer cette possibilité en confinant le contrôle dans un environnement attesté par le matériel.
Le RGPD interdit-il d'utiliser ChatGPT ou Gemini dans une entreprise française ?
Non, le RGPD n'interdit aucun outil en particulier. Il impose une base légale, une information des personnes, une durée de conservation justifiée et un encadrement des transferts hors Union européenne. La CNIL, dans ses recommandations du 7 février 2025, demande notamment aux entreprises utilisant un modèle tiers de documenter leurs traitements et de rester capables de répondre aux demandes d'accès ou de suppression. C'est un travail de cadrage, pas une interdiction.
Faut-il préférer un modèle auto-hébergé pour protéger ses données ?
C'est la solution la plus étanche, puisque les données ne quittent jamais votre infrastructure. Les modèles en poids ouverts de Mistral, Meta, Alibaba ou DeepSeek le permettent, et un petit modèle suffit pour beaucoup de tâches internes. Le prix à payer est ailleurs : matériel, compétences, mises à jour et qualité de réponse en général inférieure aux meilleurs modèles propriétaires. L'approche mixte, un modèle local pour le sensible et une API pour le reste, donne souvent le meilleur compromis.
Qu'est-ce qu'une enclave, ou TEE, en une phrase ?
Une enclave, ou TEE pour Trusted Execution Environment, est une zone mémoire chiffrée par le processeur lui-même, dans laquelle un calcul s'exécute sans que le système d'exploitation ni l'administrateur de la machine puissent en lire le contenu. Intel TDX assure cette fonction côté processeur central, NVIDIA l'assure sur ses GPU Hopper et Blackwell. Couplée à l'attestation distante, elle permet de vérifier par cryptographie l'état du serveur avant de lui envoyer quoi que ce soit.
Combien de temps faut-il pour sécuriser l'usage de l'IA dans une PME ?
Sur nos missions, le cadrage initial demande généralement de deux à cinq jours : classification des données en trois niveaux, choix d'un outil autorisé par niveau, signature des avenants de traitement, registre des usages et session de sensibilisation des équipes. Le point le plus long n'est jamais technique, c'est l'inventaire des outils déjà utilisés sans validation, souvent deux à trois fois plus nombreux que ce que la direction imagine.