
Modèles IA : quatre sorties en 48 h, que retenir ?
Le 21 septembre 2026, xAI publie Grok 4.7. Le lendemain, trois annonces tombent dans la même journée : Claude Opus 5.5 chez Anthropic, GPT-6 Sol et GPT-6 Luna chez OpenAI, et la famille MiMo-V2.6 chez Xiaomi, en poids ouverts sous licence MIT. Quatre éditeurs, deux jours, un seul message adressé au marché. Cette concentration n'est pas un hasard de calendrier, elle raconte une bascule : le prix du token de sortie s'étale désormais de 0,44 € à 43,94 € le million selon le modèle choisi, pour des écarts de performance bien plus faibles que ces écarts de prix. Voici ce que cette semaine dit vraiment de l'état du marché des LLM.
-
- Dernière modification
26 septembre 2026 - 10 minutes de lecture
Quatre sorties en 48 heures : le récapitulatif
Entre le 21 et le 22 septembre 2026, quatre éditeurs ont publié six modèles. Voici le tableau de bord complet, avec les tarifs convertis en euros au cours du 24 septembre 2026 (1 € = 1,138 $, source Trading Economics).
| Modèle | Éditeur | Date | Entrée (€/M tokens) | Sortie (€/M tokens) | Contexte |
|---|---|---|---|---|---|
| Grok 4.7 | xAI | 21 sept. | 1,76 € | 5,27 € | 500 000 tokens |
| Claude Opus 5.5 | Anthropic | 22 sept. | 3,51 € | 17,57 € | 1 million |
| GPT-6 Sol | OpenAI | 22 sept. | 1,76 € | 8,79 € | non communiqué |
| GPT-6 Luna | OpenAI | 22 sept. | 0,09 € | 0,44 € | non communiqué |
| MiMo-V2.6-Pro | Xiaomi | 22 sept. | 0,38 € | 0,76 € | 1 million |
| MiMo-V2.6-Flash | Xiaomi | 22 sept. | 0,12 € | 0,25 € | 1 million |
Trois faits sautent aux yeux. Le premier : le rapport entre le modèle le plus cher et le moins cher de la semaine atteint 100 pour 1 sur le token de sortie. Le deuxième : Xiaomi, fabricant de smartphones, publie des poids ouverts sous licence MIT qui se classent au même niveau que Grok 4.7 dans l'index indépendant Artificial Analysis. Le troisième : personne n'a baissé le prix d'un modèle existant, tout le monde a sorti un modèle neuf moins cher. La nuance compte, nous y revenons plus bas.
Pourquoi tout le monde publie la même semaine
La simultanéité des annonces est une stratégie défensive, pas une coïncidence. Dans un marché où l'attention des développeurs et des acheteurs se concentre sur quelques jours après chaque sortie majeure, laisser un concurrent occuper seul la scène pendant une semaine coûte des parts d'usage difficiles à reprendre.
Trois mécanismes expliquent cet alignement.
- La fuite de calendrier : les dates de sortie circulent entre laboratoires bien avant l'annonce publique, via les partenaires cloud et les testeurs sous accord de confidentialité. Un éditeur qui apprend la date d'un concurrent avance ou retarde la sienne de quelques jours.
- Le cycle des conférences : la rentrée de septembre concentre les événements développeurs et les renouvellements de contrats annuels. Sortir après octobre, c'est rater une saison d'achats.
- La pression des benchmarks : un classement public comme Artificial Analysis se met à jour en continu. Rester une semaine derrière un concurrent dans un tableau que tout le monde consulte pèse sur les décisions d'intégration.
Ce rythme interroge une partie du secteur. Le 16 septembre 2026, MacGeneration rapportait que Meta et Mistral refusaient de s'associer aux appels au ralentissement portés par OpenAI, Anthropic et Google. Mark Zuckerberg estime que « chaque entreprise porte la responsabilité individuelle d'avancer au rythme adéquat », tandis que Mistral, qui a levé 3 milliards d'euros, accuse ses concurrents américains d'instrumentaliser les incidents de sécurité pour figer le marché à leur avantage. Une semaine plus tard, quatre modèles sortaient en 48 heures.
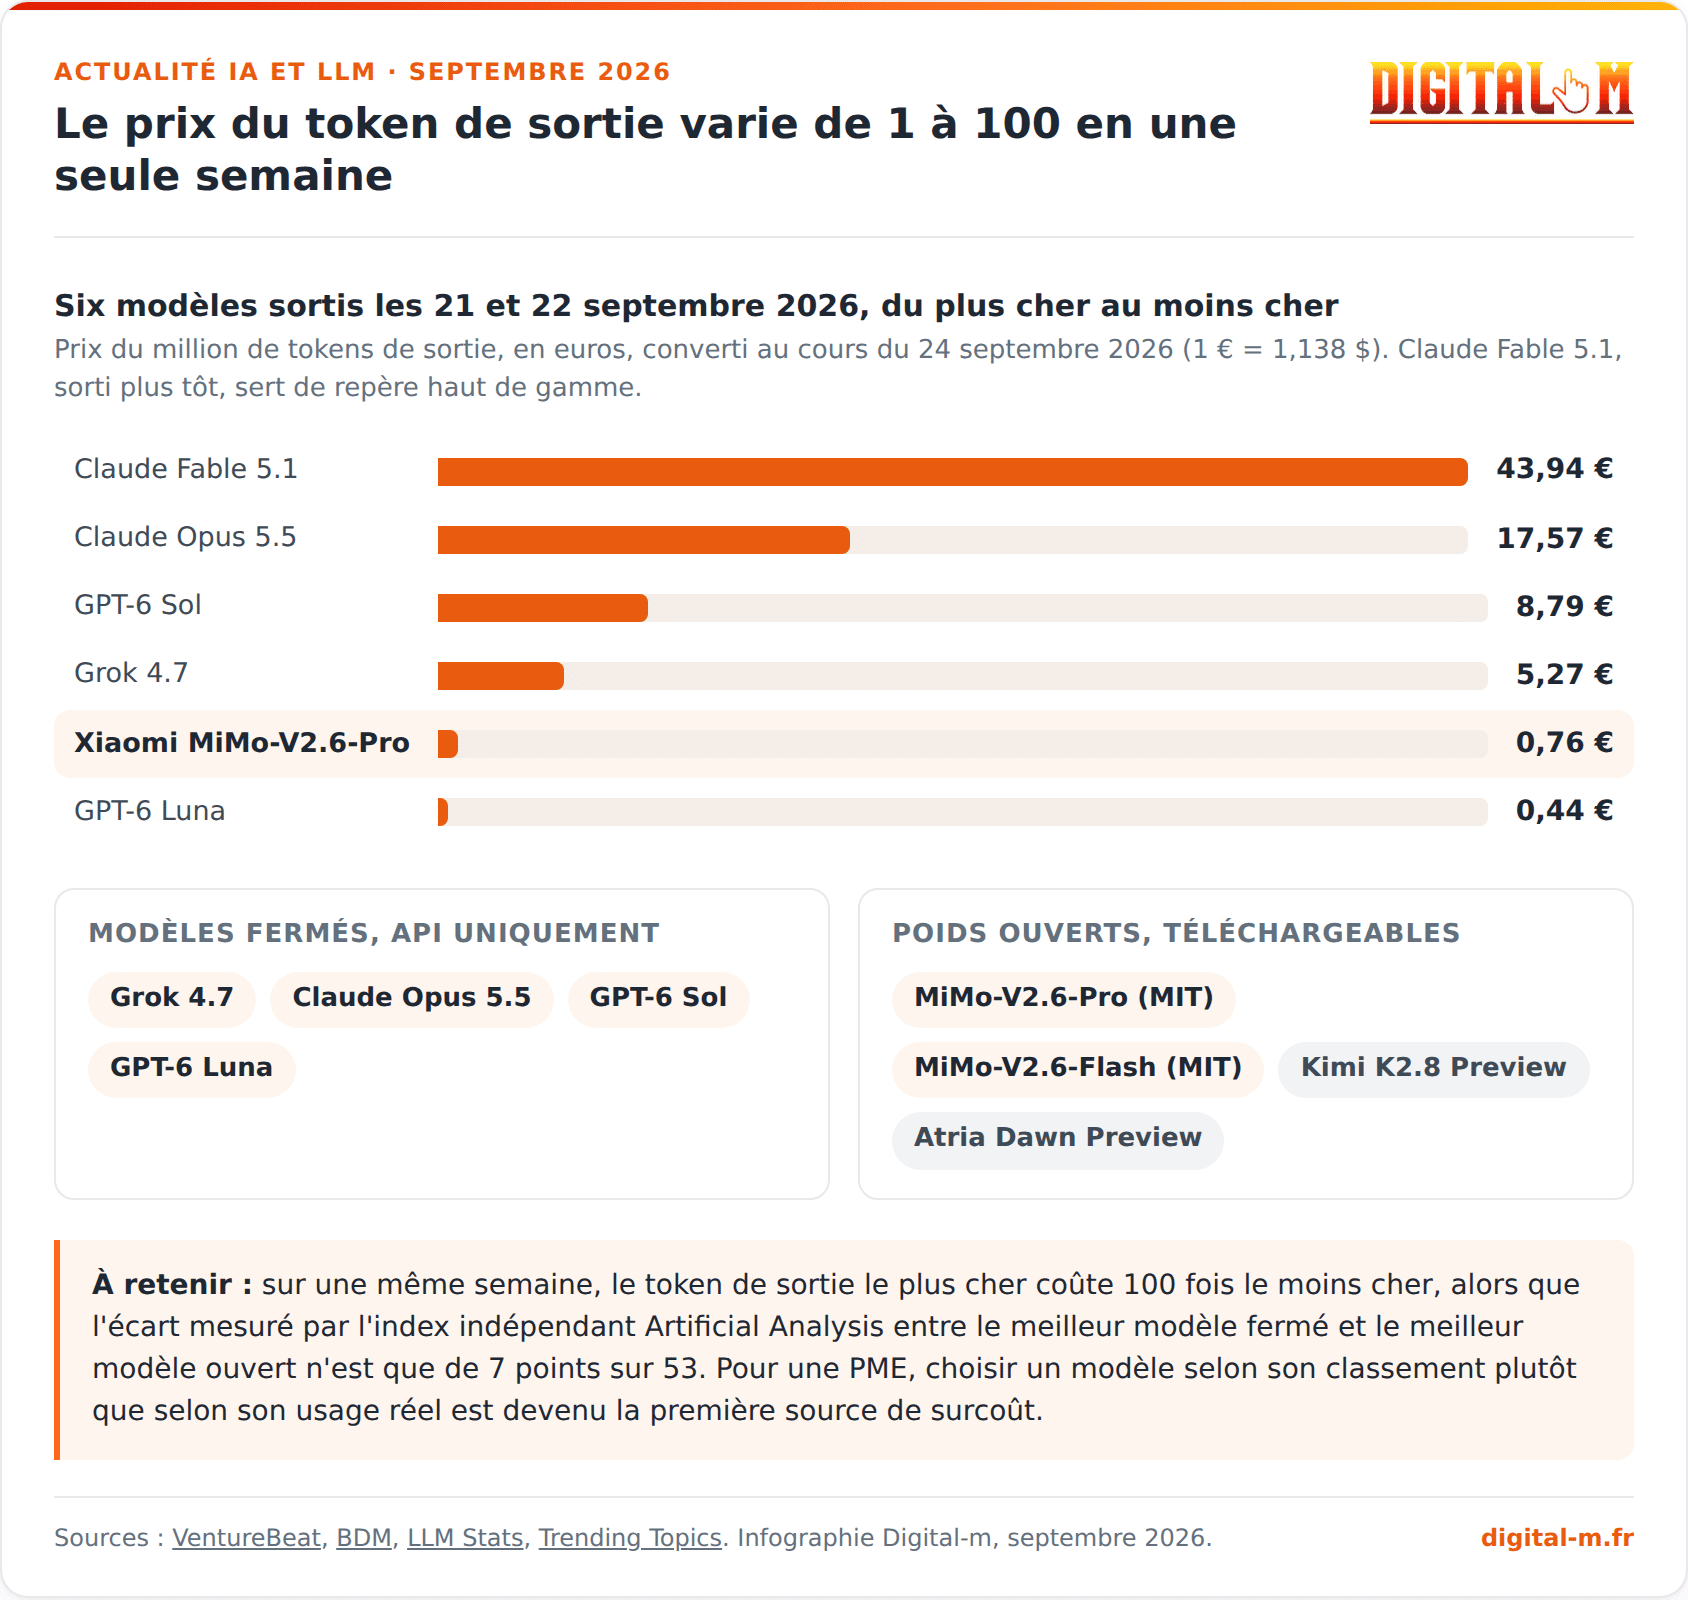
Le prix du token de sortie varie de 1 à 100 en une seule semaine

Six modèles sortis les 21 et 22 septembre 2026, du plus cher au moins cher
Prix du million de tokens de sortie, en euros, converti au cours du 24 septembre 2026 (1 € = 1,138 $). Claude Fable 5.1, sorti plus tôt, sert de repère haut de gamme.
Modèles fermés, API uniquement
Poids ouverts, téléchargeables
À retenir : sur une même semaine, le token de sortie le plus cher coûte 100 fois le moins cher, alors que l'écart mesuré par l'index indépendant Artificial Analysis entre le meilleur modèle fermé et le meilleur modèle ouvert n'est que de 7 points sur 53. Pour une PME, choisir un modèle selon son classement plutôt que selon son usage réel est devenu la première source de surcoût.
Télécharger l'infographie (PNG)
La baisse des prix reprend, mais pas là où on l'attend
Aucun des quatre éditeurs n'a baissé le tarif d'un modèle déjà en production : tous ont publié un modèle neuf, moins cher que le précédent. La distinction est capitale pour qui pilote un budget. OpenAI annonce des tarifs API divisés par deux par rapport à GPT-5.6, mais ces tarifs s'appliquent à GPT-6 Sol et Luna, pas à vos appels existants. Anthropic affiche Claude Opus 5.5 à 20 % sous le prix d'Opus 5, mais il faut migrer pour en profiter.
Nous avions analysé ce mécanisme en détail dans notre article sur l'arrêt de la baisse des prix des LLM en 2026 : le coût affiché au million de tokens baisse, mais le coût réel par tâche baisse beaucoup moins, parce que les modèles récents produisent davantage de tokens de raisonnement avant de répondre. Un modèle deux fois moins cher qui consomme deux fois plus de tokens ne fait économiser strictement rien.
Le bon indicateur n'est donc pas le prix du million de tokens, c'est le coût par tâche accomplie. OpenAI le reconnaît implicitement en communiquant sur un « coût par tâche 11,1 fois inférieur » à celui de Claude Opus 5 sur AutomationBench. Précisons tout de suite que ce chiffre provient d'un test maison d'OpenAI, non vérifié par un tiers indépendant, exactement comme les comparatifs publiés par Anthropic sur ses propres pages.
- À faire : mesurer le coût moyen d'une tâche type sur votre propre corpus, avec votre propre prompt, avant et après migration.
- À éviter : migrer sur la seule foi d'un tarif affiché au million de tokens.
- À surveiller : le volume de tokens de sortie, qui grimpe avec les modèles dits « de raisonnement ». Le sujet est décortiqué dans notre article sur la façon dont les LLM découpent et facturent le texte.
L'open weight n'est plus un lot de consolation
L'annonce la plus significative de la semaine ne vient ni d'OpenAI ni d'Anthropic, mais de Xiaomi. MiMo-V2.6-Pro compte 1 020 milliards de paramètres au total, dont 42 milliards activés à chaque inférence, une architecture de type mixture of experts. Ses poids sont publiés sur Hugging Face sous licence MIT, la plus permissive qui soit : usage commercial autorisé, modification autorisée, aucune obligation de partage.
Dans le classement composite d'Artificial Analysis, organisme indépendant des éditeurs, MiMo-V2.6-Pro obtient 46 points. Le podium est occupé par Claude Fable 5.1 et GPT-6 Astra à 53 points, suivis de Claude Opus 5 à 51, Muse Spark 1.3 à 48 et GPT-5.6 Sol à 47. Grok 4.7 se situe à 46 points, à égalité avec le modèle ouvert de Xiaomi.
Autrement dit, l'écart entre le meilleur modèle fermé du monde et le meilleur modèle ouvert téléchargeable gratuitement s'établit à 7 points sur 53, soit environ 13 %. Il y a dix-huit mois, cet écart se comptait en dizaines de points. Nous avions posé les bases du sujet dans notre article sur les LLM en open weights, et la tendance s'y confirme trimestre après trimestre.
Xiaomi annonce par ailleurs des coûts d'entraînement de l'ordre de 740 000 € pour la version Flash et 2,28 millions d'euros pour la version Pro, sur six jours. Ces montants sont communiqués par l'éditeur lui-même et n'ont pas été audités par un tiers : ils sont à prendre comme un ordre de grandeur revendiqué, pas comme un fait établi. S'ils se confirmaient, ils signifieraient que le ticket d'entrée pour produire un modèle de rang mondial a chuté d'un ou deux ordres de grandeur.
Les benchmarks ont changé de nature
Les classements de septembre 2026 ne mesurent plus la culture générale des modèles mais leur capacité à mener une tâche longue jusqu'au bout. Terminal-Bench, CursorBench, DeepSWE, OSWorld, AutomationBench : tous évaluent un agent qui manipule des fichiers, exécute des commandes et corrige ses propres erreurs.
Sur Terminal-Bench 4.0, Anthropic revendique 66,4 % pour Claude Opus 5.5, contre 55,8 % pour Claude Fable 5.1 et 52,3 % pour Claude Opus 5. Sur CyberGym, Xiaomi revendique 95,1 % pour MiMo-V2.6-Flash. Ces scores sont publiés par les éditeurs eux-mêmes et doivent être lus comme tels : ils ne sont pas issus d'une évaluation indépendante.
Ce glissement a une conséquence directe pour les entreprises. Un score élevé sur un benchmark agentique ne dit rien de la qualité rédactionnelle, de la fiabilité factuelle en français ou de la pertinence sur un corpus métier. Pour comprendre comment lire ces classements sans se faire piéger, nous avons publié un guide complet sur la mesure de l'intelligence d'une IA en 2026.
Ce que cette semaine change concrètement pour une PME
Pour une PME française, l'effet immédiat de ces quatre sorties est nul, et c'est une bonne nouvelle. Aucun outil du quotidien ne change de comportement du jour au lendemain, les intégrations existantes continuent de fonctionner, et les abonnements grand public suivent avec plusieurs semaines de décalage.
L'effet à trois mois, lui, est réel. Voici les trois points à mettre à l'ordre du jour de votre prochaine revue d'outils.
- Le rapport qualité-prix de votre modèle actuel : si vous appelez une API depuis un an sans avoir rouvert le dossier, vous payez probablement deux à cinq fois le tarif d'un modèle équivalent sorti depuis.
- La possibilité d'un modèle ouvert : pour des tâches répétitives et internes (reformulation, classification, extraction), un modèle sous licence MIT hébergé en Europe devient une option crédible, y compris pour des raisons de confidentialité des données clients.
- La dépendance à un éditeur unique : concentrer tous ses usages sur une seule API expose aux suspensions d'offres et aux changements de conditions, deux événements devenus courants en 2026.
Chez Digital-m, nous voyons passer beaucoup de projets où l'outil a été choisi en janvier et jamais réévalué depuis. Le rituel qui fonctionne le mieux chez nos clients est simple : une revue trimestrielle d'une heure, trois questions (coût réel, qualité perçue, alternative moins chère), et une décision écrite. Rien de plus.
Ce qu'il faut surveiller dans les prochaines semaines
Trois signaux permettront de savoir si la semaine du 21 septembre marque un tournant ou un simple embouteillage calendaire.
- La répercussion sur les offres grand public : les tarifs API ont baissé, reste à voir si les abonnements chat et les quotas gratuits suivent. Historiquement, le décalage est de six à dix semaines.
- La réponse de Google et de Mistral : ni Gemini ni Mistral n'ont publié de modèle majeur pendant cette fenêtre. Leur calendrier d'automne dira si l'alignement de septembre devient la norme.
- L'adoption réelle des poids ouverts : un bon score sur Artificial Analysis ne garantit pas l'adoption. Le signal à suivre est le nombre de téléchargements et de dérivés (« forks », c'est-à-dire de versions modifiées reprises par d'autres équipes) sur Hugging Face dans les trois mois.
Un point d'honnêteté : les chiffres de performance cités dans cet article proviennent majoritairement des éditeurs. Seul l'index Artificial Analysis constitue une mesure tierce. Toute comparaison entre modèles reste donc à prendre avec prudence tant que des évaluations indépendantes n'ont pas confirmé les annonces.
Ce qu'il faut retenir
La semaine du 21 septembre 2026 a vu sortir six modèles IA en 48 heures chez quatre éditeurs. Le prix du million de tokens de sortie s'étale de 0,44 € pour GPT-6 Luna à 43,94 € pour Claude Fable 5.1, soit un rapport de 100 pour 1, alors que l'écart de performance mesuré par un tiers indépendant plafonne à 13 % entre le meilleur modèle fermé et le meilleur modèle ouvert. Aucun éditeur n'a baissé le prix d'un modèle existant : tous ont sorti un modèle neuf moins cher, ce qui impose une migration pour en bénéficier.
Pour une entreprise, la bonne unité de mesure reste le coût par tâche accomplie, jamais le prix affiché au million de tokens. Vous voulez savoir si vos outils IA sont bien dimensionnés et si votre contenu est visible dans les réponses génératives ? Notre agence GEO réalise des audits qui croisent les deux sujets, et nos formations certifiées Qualiopi vous permettent de reprendre la main en interne.
Et vous, avez-vous rouvert le dossier de vos outils IA depuis le début de l'année ? Dites-le nous en commentaire !Sources et références
- VentureBeat - Anthropic releases Claude Opus 5.5, beating Fable 5.1 on key agentic benchmarks at 60% cheaper API price (22 septembre 2026)
- Blog du Modérateur - OpenAI lance GPT-6 Sol et Luna, avec des tarifs API divisés par deux (22 septembre 2026)
- LLM Stats - Grok 4.7 Benchmarks, Pricing & Context Window (21 septembre 2026)
- Trending Topics - Xiaomi's MiMo-V2.6-Pro Is Now the Strongest Open-Weight AI Model (septembre 2026)
- MacGeneration - Pause de l'IA : Meta et Mistral refusent de jouer le jeu d'OpenAI et d'Anthropic (16 septembre 2026)
- LLM Stats - AI Updates Today, calendrier des sorties de modèles (septembre 2026)
- Trading Economics - Taux de change EUR/USD au 24 septembre 2026 (1,138)
Questions fréquentes sur les sorties de modèles IA de septembre 2026
Quel modèle est le moins cher en septembre 2026 ?
Parmi les modèles sortis les 21 et 22 septembre 2026, GPT-6 Luna d'OpenAI affiche le tarif le plus bas avec 0,09 € le million de tokens en entrée et 0,44 € en sortie. Côté poids ouverts, MiMo-V2.6-Flash de Xiaomi descend à 0,12 € et 0,25 € via son API, avec en plus la possibilité de l'héberger soi-même. Ces tarifs sont convertis du dollar au cours du 24 septembre 2026.
Un modèle en poids ouverts vaut-il vraiment un modèle fermé ?
Dans l'index indépendant Artificial Analysis de septembre 2026, le meilleur modèle ouvert (MiMo-V2.6-Pro de Xiaomi, 46 points) se situe à 7 points du meilleur modèle fermé (53 points), soit environ 13 % d'écart. Pour des tâches internes répétitives comme la classification, l'extraction ou la reformulation, cet écart est rarement perceptible. Pour du raisonnement long ou du code complexe, il compte encore.
Faut-il migrer immédiatement vers GPT-6 ou Claude Opus 5.5 ?
Pas sans mesure préalable. Les tarifs annoncés concernent les nouveaux modèles, pas vos appels existants, et les modèles récents produisent davantage de tokens de raisonnement, ce qui peut annuler l'économie affichée. La méthode fiable consiste à faire tourner vos dix tâches les plus fréquentes sur l'ancien et le nouveau modèle, puis à comparer le coût total par tâche accomplie, pas le prix au million de tokens.
Pourquoi les éditeurs sortent-ils leurs modèles la même semaine ?
Trois raisons se combinent : les dates de sortie circulent entre laboratoires via les partenaires cloud avant l'annonce publique, la rentrée de septembre concentre les renouvellements de contrats annuels, et les classements publics se mettant à jour en continu, rester une semaine derrière un concurrent pèse sur les décisions d'intégration. Aucun éditeur ne veut laisser un rival occuper seul la scène.
Peut-on faire confiance aux benchmarks publiés par les éditeurs ?
Avec prudence. Les scores publiés sur Terminal-Bench, AutomationBench ou CyberGym proviennent le plus souvent de tests réalisés par l'éditeur du modèle, sans vérification par un tiers indépendant. Les index comparatifs comme Artificial Analysis, qui appliquent le même protocole à tous les modèles, offrent une base plus fiable. Le meilleur juge reste votre propre corpus, testé sur vos cas d'usage réels.