
Filigrane texte IA : ChatGPT marque désormais ses réponses
Depuis le 5 octobre 2026, chaque réponse produite par ChatGPT dans l'Union européenne porte une signature invisible. OpenAI a dévoilé textGrain, un filigrane statistique glissé directement dans le choix des mots du modèle. L'éditeur annonce 95 % de détection sur un passage de 400 tokens, pour 1 % de faux positifs. Google marque déjà le texte de Gemini avec SynthID-Text, Anthropic a suivi en septembre pour Claude. Derrière cette vague, une seule cause : l'article 50 de l'AI Act, contraignant depuis le 2 août 2026, qui impose de rendre les contenus générés identifiables par une machine. Reste la question qui intéresse votre entreprise : vos contenus rédigés avec l'IA deviennent-ils repérables, et faut-il s'en inquiéter pour votre référencement ?
-
- Dernière modification
6 octobre 2026 - 11 minutes de lecture
textGrain : ce qu'OpenAI a annoncé le 5 octobre 2026
textGrain est le système de filigrane de texte d'OpenAI, présenté le 5 octobre 2026. Il insère un signal statistique invisible dans le choix des mots du modèle, puis permet à un détecteur muni d'une clé secrète de dire si un passage provient bien d'un modèle OpenAI. Le lecteur, lui, ne voit strictement rien : ni caractère spécial, ni métadonnée, ni mention en bas de page.
Le dispositif a été construit avec des chercheurs de l'université de Pennsylvanie et de Yale. Il ne concerne pas les images, déjà couvertes depuis plus longtemps par les métadonnées C2PA, mais bien le texte brut, le format le plus difficile à marquer.
- Ce qui est marqué : les sorties de ChatGPT et de Codex pour les utilisateurs situés dans l'Union européenne, automatiquement, dans les semaines qui suivent l'annonce.
- Ce qui reste optionnel : l'API, disponible partout dans le monde, où le filigrane est désactivé par défaut et doit être activé par le client.
- Qui peut vérifier : personne pour l'instant, hors chercheurs et organisations expertes approuvées par OpenAI. L'accès au détecteur se fait sur candidature.
- La suite annoncée : une publication en open source de la technologie, sans date précisée à ce jour.
- La performance affichée : 80 % de détection sur 200 tokens, 95 % sur 400 tokens, à un taux de faux positifs de 1 %, sur des contenus rédactionnels classiques.
Précision utile pour la lecture de ces chiffres : il s'agit de mesures publiées par OpenAI, donc d'un test maison, non vérifié à ce stade par un tiers indépendant. Le détecteur n'étant pas public, personne hors du cercle agréé ne peut encore les reproduire.
Comment un filigrane se cache dans le choix des mots
Un filigrane de texte fonctionne en biaisant le hasard. À chaque étape, un modèle de langage choisit le mot suivant parmi plusieurs candidats probables, et ce choix comporte une part d'aléatoire. Le filigrane utilise une clé secrète pour orienter très légèrement cette sélection, de façon imperceptible phrase par phrase mais mesurable sur plusieurs centaines de mots.
Si ce mécanisme de sélection vous intrigue, nous l'avons détaillé dans notre article sur la température d'un LLM et la manière dont l'IA choisit ses mots. Le filigrane ne fait qu'ajouter une couche par-dessus ce tirage au sort interne.
Le texte est mesuré en tokens, ces fragments de mots qui servent d'unité de base aux modèles de langage : 400 tokens correspondent environ à 300 mots en français, soit deux paragraphes nourris. En dessous de ce volume, le signal devient trop ténu pour ressortir du bruit statistique. Notre guide sur la façon dont l'IA découpe et facture le texte explique cette unité en détail.
Conséquence directe : un titre, une méta description ou une réponse de chatbot de deux lignes ne sont pratiquement pas détectables. Un article de blog de 1 500 mots sorti tel quel de ChatGPT, si.
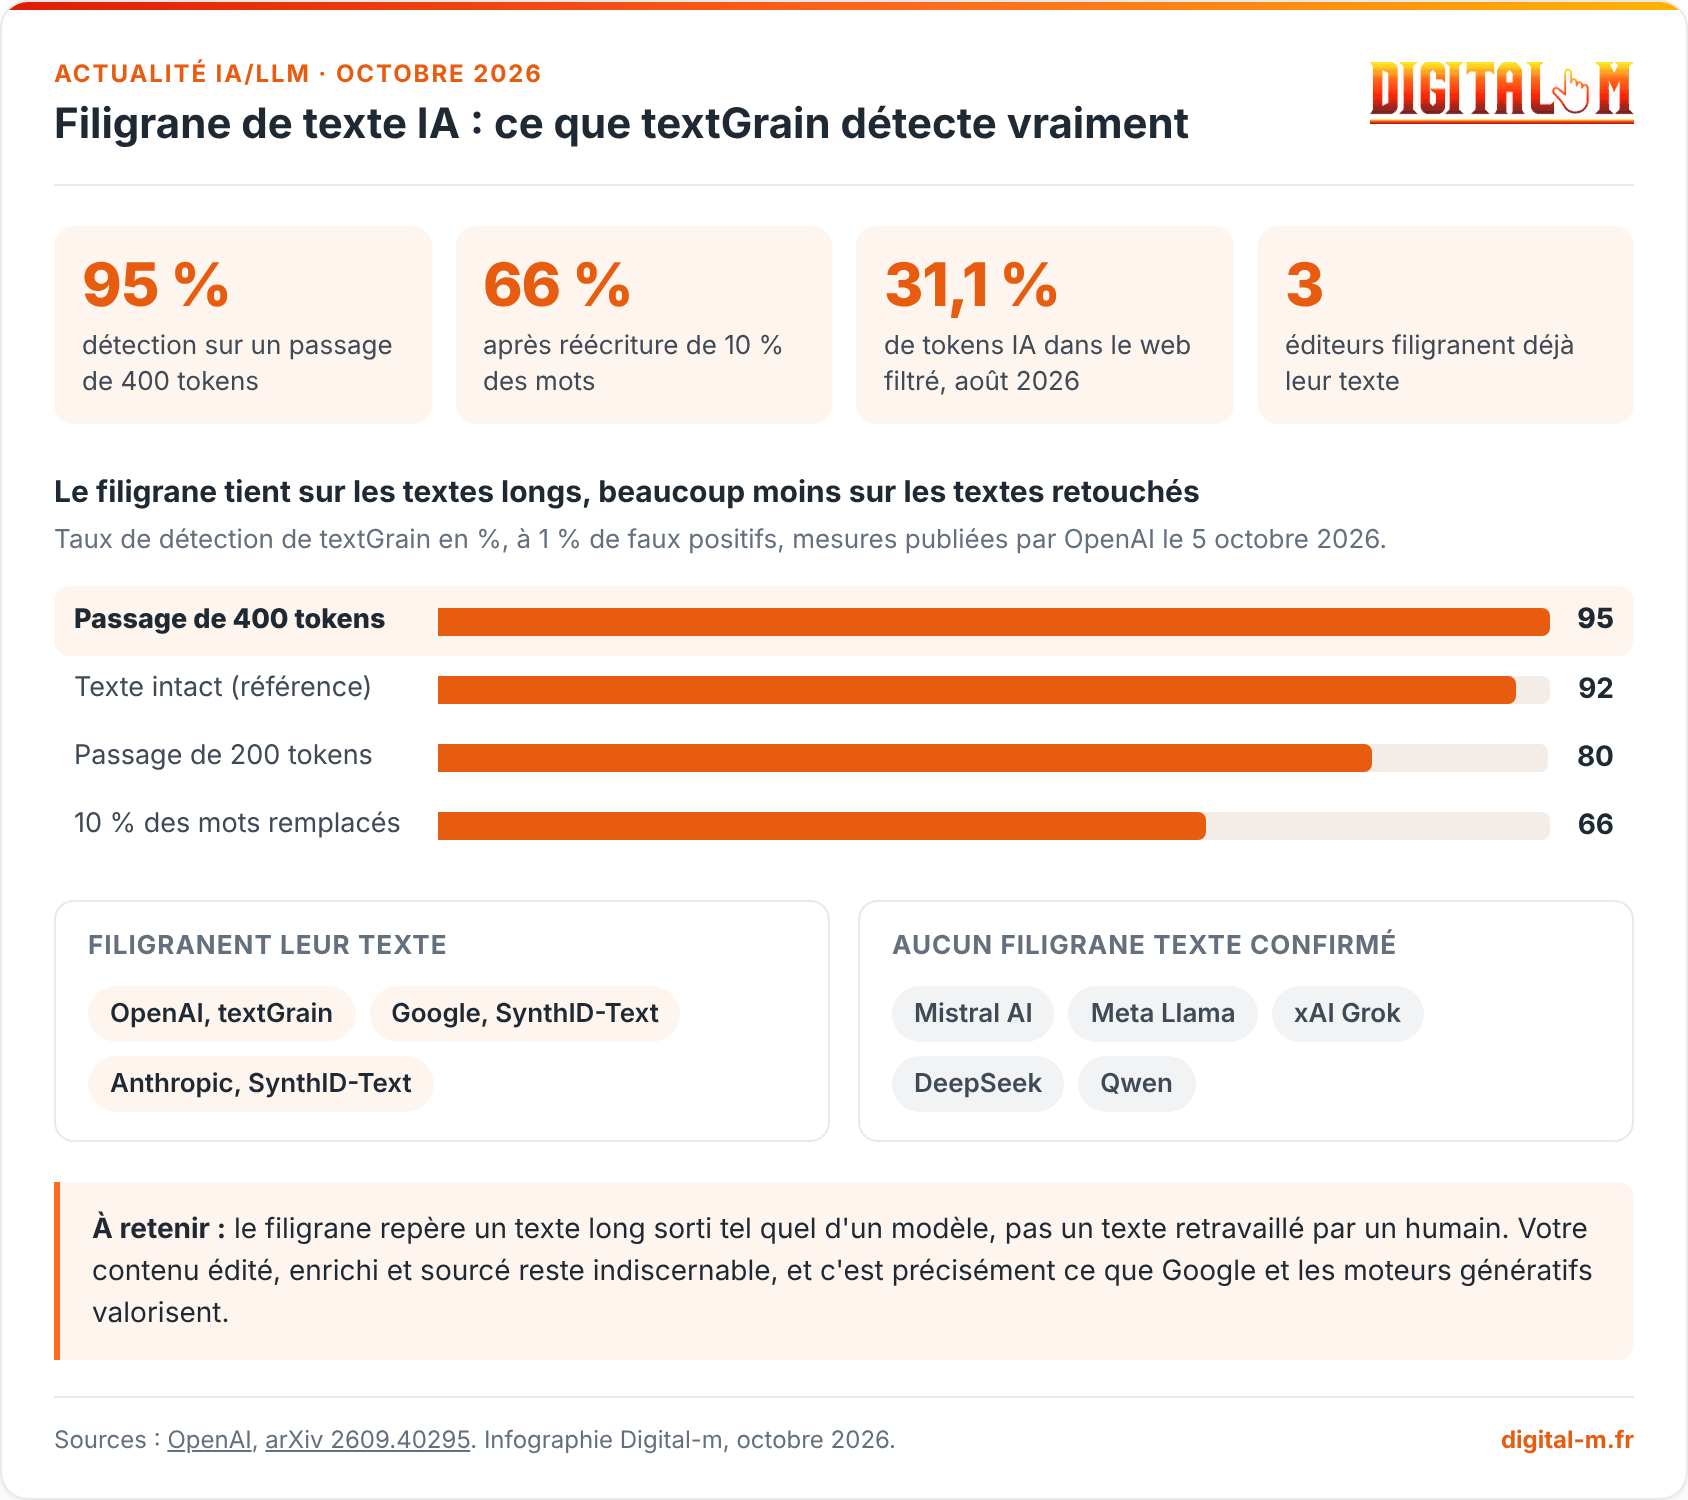
Filigrane de texte IA : ce que textGrain détecte vraiment

- 95 % détection sur un passage de 400 tokens
- 66 % après réécriture de 10 % des mots
- 31,1 % de tokens IA dans le web filtré, août 2026
- 3 éditeurs filigranent déjà leur texte
Le filigrane tient sur les textes longs, beaucoup moins sur les textes retouchés
Taux de détection de textGrain en %, à 1 % de faux positifs, mesures publiées par OpenAI le 5 octobre 2026.
Filigranent leur texte
Aucun filigrane texte confirmé
À retenir : le filigrane repère un texte long sorti tel quel d'un modèle, pas un texte retravaillé par un humain. Votre contenu édité, enrichi et sourcé reste indiscernable, et c'est précisément ce que Google et les moteurs génératifs valorisent.
Télécharger l'infographie (PNG)
Qui filigrane son texte en octobre 2026 ?
Trois éditeurs marquent aujourd'hui leur texte : OpenAI, Google et Anthropic. Les autres grands modèles, Mistral, Llama, Grok, DeepSeek ou Qwen, n'ont annoncé aucun filigrane de texte à ce jour. Le tableau ci-dessous résume la situation au 6 octobre 2026.
| Éditeur | Technologie | Périmètre | Détecteur public |
|---|---|---|---|
| OpenAI (ChatGPT, Codex) | textGrain | UE automatique, API en opt-in mondial | Non, chercheurs agréés |
| Google (Gemini) | SynthID-Text | Texte, image, audio, vidéo | Partiel selon le format |
| Anthropic (Claude) | SynthID-Text | Mondial, modèles postérieurs au 2 août 2026 | API de détection annoncée |
| Mistral AI | Aucune annonce | Non concerné à ce jour | Non |
| Meta (Llama) | Aucune annonce | Non concerné à ce jour | Non |
| xAI (Grok), DeepSeek, Qwen | Aucune annonce | Non concerné à ce jour | Non |
Anthropic a pris les devants : l'éditeur a annoncé le 17 septembre 2026 l'adoption de SynthID-Text, la technologie ouverte de Google DeepMind, pour tous ses nouveaux modèles Claude publiés depuis le 2 août 2026, avec une mise à niveau des modèles plus anciens prévue avant le 2 décembre 2026. Contrairement à OpenAI, le marquage s'applique partout, pas seulement en Europe.
L'article 50 de l'AI Act, le vrai déclencheur
Ces annonces ne relèvent pas d'un élan de transparence spontané. Elles répondent à l'article 50 de l'AI Act, contraignant depuis le 2 août 2026, qui oblige les fournisseurs d'IA générative à rendre leurs contenus identifiables dans un format lisible par une machine. Nous avons décortiqué ce texte dans notre analyse de ce que l'article 50 de l'AI Act change depuis le 2 août 2026.
L'obligation pèse sur l'éditeur du modèle, pas sur vous. Une PME française qui publie un article rédigé avec ChatGPT n'a aucune déclaration technique à produire au titre de l'article 50. L'obligation d'information existe en revanche pour les chatbots exposés au public et les contenus manifestement trompeurs, deux cas bien distincts du simple usage rédactionnel.
Le périmètre géographique explique aussi pourquoi OpenAI active le filigrane en Europe et le laisse optionnel ailleurs. Un utilisateur français de ChatGPT sera marqué, un utilisateur américain non. Cette asymétrie risque de durer tant que les autres juridictions n'imposent rien d'équivalent.
Ce qu'un filigrane ne prouve pas
OpenAI le dit noir sur blanc : son filigrane ne mesure pas la contribution humaine, n'établit ni propriété ni responsabilité, ne vérifie pas l'exactitude d'un texte et n'identifie pas l'utilisateur. Surtout, l'absence de filigrane ne prouve en rien qu'un texte a été écrit par un humain.
Réécrire 10 % des mots suffit à brouiller le signal
C'est la limite la plus parlante du dispositif. Dans les tests publiés par OpenAI, le remplacement de 10 % des mots par des synonymes fait chuter la détection de 92 % à 66 %. Autrement dit, une relecture éditoriale ordinaire, celle que tout rédacteur sérieux applique de toute façon, dégrade déjà fortement la signature. Le filigrane repère les copier-coller bruts, pas le travail éditorial.
Le signal faiblit aussi nettement sur les contenus où le vocabulaire est contraint : textes mathématiques, listes de spécifications techniques, énumérations de chiffres. Moins le modèle a de liberté dans le choix des mots, moins il peut y dissimuler de signal.
Les modèles ouverts échappent au dispositif
Un modèle en poids ouverts exécuté sur une machine locale ne filigrane rien, puisque l'utilisateur contrôle le code d'inférence et peut simplement désactiver la fonction. Mistral, Llama, Qwen ou DeepSeek installés en local produisent donc du texte parfaitement anonyme. Tant que ces modèles restent accessibles, le filigrane relève d'une mesure d'hygiène collective, pas d'un verrou.
Google va-t-il déclasser vos contenus marqués ?
Non, et aucun signal ne va dans ce sens aujourd'hui. Google n'utilise pas les filigranes des éditeurs d'IA comme critère de classement, et sa position officielle reste inchangée depuis 2023 : c'est la qualité du contenu qui compte, pas la façon dont il a été produit.
Les données confirment cette neutralité, avec une nuance. Une étude Ahrefs publiée le 27 juillet 2026, portant sur environ 150 000 pages du top 10 issues de 100 000 recherches de juin 2026, montre que les pages fortement signalées comme générées par IA occupent toutes les positions du top 10, y compris la première. Le score IA moyen passe simplement de 27,1 % en position 1 à 30,9 % en position 10. La corrélation existe, elle reste faible.
Le vrai sujet est ailleurs : le web se remplit de texte synthétique. Une étude parue sur arXiv le 30 septembre 2026 mesure que 31,1 % des tokens du corpus web filtré FineWeb d'août 2026 sont identifiés comme générés par IA par l'outil Pangram, contre 27,5 % en juin 2026 et environ 10 % en juin 2024. Plus la moyenne monte, plus un contenu réellement original se détache.
Chez Digital-m, nous auditons chaque mois des sites de PME dont le trafic s'effondre après une campagne de production massive à l'IA. Le problème n'est jamais le filigrane, toujours la redondance : dix articles qui disent la même chose que dix mille autres pages, sans donnée propre ni expérience vécue. C'est exactement ce que décrit notre méthode sur les données originales comme levier de citation par l'IA.
Ce que vous devez faire de votre côté
Rien d'urgent sur le plan réglementaire, beaucoup sur le plan éditorial. Voici la liste de contrôle que nous appliquons chez nos clients depuis l'annonce.
- Ne changez pas d'outil dans la panique : le filigrane ne pénalise rien. Changer de modèle pour y échapper serait une décision guidée par une peur sans fondement SEO.
- Éditez systématiquement : relire, couper, reformuler, ajouter un exemple de terrain. C'est bon pour le lecteur, bon pour Google, et accessoirement cela dilue la signature statistique.
- Ajoutez ce que l'IA n'a pas : vos chiffres, vos photos, vos cas clients, vos tarifs réels. Un modèle ne peut pas inventer votre retour d'expérience.
- Soignez l'attribution : auteur identifié, fonction, date de mise à jour. Ces signaux comptent pour l'EEAT et pour la citation par les moteurs génératifs.
- Vérifiez vos obligations réelles : si vous exploitez un chatbot public ou publiez des visuels générés, l'article 50 vous concerne bel et bien, contrairement à un simple article de blog assisté par IA.
- Méfiez-vous des détecteurs du commerce : ils ne lisent pas le filigrane d'OpenAI, qui reste fermé. Ils estiment, avec des faux positifs documentés sur des textes humains.
Ce dernier point mérite un avertissement. Aucun outil grand public ne peut aujourd'hui lire textGrain : le détecteur est réservé à des chercheurs agréés. Un service qui prétendrait le contraire vend une estimation statistique, pas une lecture de filigrane. La question du statut juridique des contenus produits par IA est traitée à part dans notre dossier sur l'IA générative et le droit d'auteur en France.
Ce qu'il faut retenir
OpenAI a activé le 5 octobre 2026 textGrain, un filigrane invisible appliqué automatiquement aux textes de ChatGPT et Codex dans l'Union européenne, et proposé en option sur l'API ailleurs. La détection atteint 95 % sur 400 tokens mais tombe à 66 % dès que 10 % des mots sont remplacés. Google et Anthropic marquent déjà leur texte, Mistral, Meta, xAI et les modèles chinois non.
Pour une PME française, l'obligation pèse sur l'éditeur du modèle, pas sur vous, et Google ne déclasse pas les contenus marqués. Le vrai risque reste celui qu'on connaissait : publier du contenu interchangeable dans un web où près d'un token sur trois est déjà synthétique. La réponse n'est pas de masquer l'IA, c'est d'ajouter ce qu'elle ne peut pas produire.
Vous voulez savoir si vos contenus tiennent la route face à cette inflation ? Notre agence GEO réalise un audit de visibilité générative page par page, et notre formation GEO certifiée Qualiopi forme vos équipes à produire du contenu que les moteurs citent. Parlons de votre cas.
Et vous, allez-vous continuer à rédiger avec l'IA maintenant que vos textes sont marqués ? Dites-le nous en commentaire !Sources et références
- OpenAI - Our approach to EU text provenance (5 octobre 2026)
- 9to5Mac - OpenAI details new text watermarking system for ChatGPT, Codex and the API (5 octobre 2026)
- Unite.AI - OpenAI Begins Phased Text Watermarking Under EU AI Act Rules (octobre 2026)
- Crypto Briefing - Anthropic adopts Google's SynthID-Text watermarking for all Claude models (17 septembre 2026)
- arXiv - How Much Is an AI Token Worth? Scaling Laws for Wild AI-Generated Web Text (30 septembre 2026)
- Search Engine Journal - Google Search Results Still Rank Heavily AI-Flagged Pages (27 juillet 2026)
- Google Search Central - Google Search's guidance about AI-generated content
- EU Artificial Intelligence Act - Article 50, Transparency Obligations
Questions fréquentes sur le filigrane de texte IA
Comment savoir si un texte a été écrit par ChatGPT ?
Avec certitude, vous ne le pouvez pas aujourd'hui. Le détecteur de filigrane textGrain d'OpenAI est réservé aux chercheurs et organisations expertes agréés depuis le 5 octobre 2026. Les détecteurs grand public du marché produisent une estimation statistique, avec des faux positifs documentés sur des textes écrits par des humains.
Le filigrane de ChatGPT est-il visible dans le texte ?
Non. textGrain n'ajoute aucun caractère spécial, aucune mention et aucune métadonnée apparente. Il biaise très légèrement le choix des mots du modèle à l'aide d'une clé secrète. Le résultat est strictement illisible à l'oeil et ne se révèle qu'à l'analyse statistique d'un passage suffisamment long, à partir d'environ 200 tokens.
Puis-je désactiver le filigrane dans ChatGPT en France ?
Non. Pour les utilisateurs de ChatGPT et de Codex situés dans l'Union européenne, le marquage est automatique et ne comporte pas d'option de désactivation. Seuls les clients de l'API OpenAI décident, puisque le filigrane y est désactivé par défaut et doit être activé volontairement.
Un contenu filigrané est-il pénalisé par Google ?
Non. Google n'exploite pas les filigranes des éditeurs d'IA comme signal de classement et juge le contenu sur sa qualité, pas sur son mode de production. L'étude Ahrefs du 27 juillet 2026, menée sur environ 150 000 pages du top 10, montre que des pages fortement signalées comme IA occupent toutes les positions, première incluse.
Mistral, Grok ou Llama filigranent-ils aussi leurs textes ?
Non, aucun filigrane de texte n'a été annoncé par Mistral AI, Meta pour Llama, xAI pour Grok, ni par DeepSeek ou Qwen au 6 octobre 2026. Seuls OpenAI avec textGrain, Google et Anthropic avec SynthID-Text marquent leurs sorties texte. Un modèle en poids ouverts exécuté en local ne peut de toute façon pas être marqué.