
Page non indexée : pourquoi Google ignore votre contenu ?
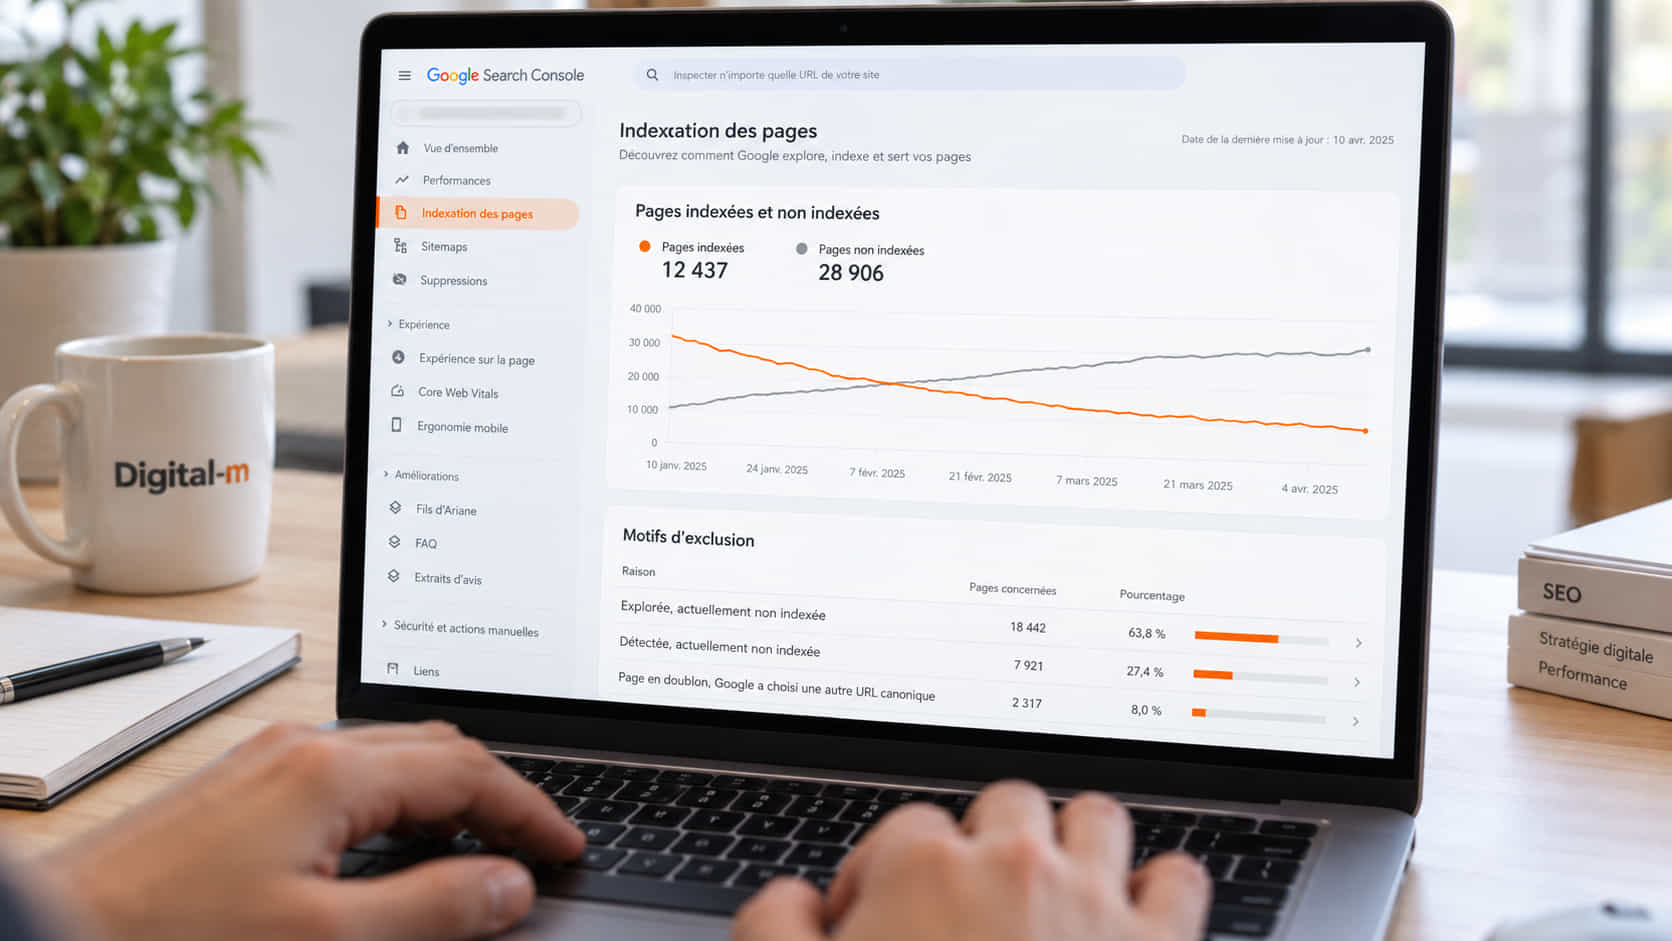
Sur 1,7 million de pages auditées par Indexing Insight, 88 % des URL absentes de l'index de Google le sont pour une raison de qualité, pas pour un problème technique. La nuance change tout : vous pouvez soumettre un sitemap irréprochable, corriger chaque erreur 404 et rester parfaitement invisible. Une page non indexée ne remonte sur aucune requête, et Google le confirme noir sur blanc dans sa documentation : sans indexation, aucune chance d'apparaître comme source dans les AI Overviews ou dans AI Mode. Cet article décode les quinze statuts « Non indexée » de la Search Console, explique pourquoi Google refuse parfois d'indexer un contenu pourtant accessible, et donne une méthode en six étapes pour débloquer les pages qui résistent.
-
- Dernière modification
23 septembre 2026 - 10 minutes de lecture
Une page non indexée n'existe ni pour Google ni pour l'IA
Une page non indexée est une URL que Google connaît mais qu'il a choisi de ne pas ranger dans son index. Concrètement, elle ne peut ressortir sur aucune requête, même en tapant son titre exact entre guillemets. Ce n'est pas une pénalité, c'est une décision de tri.
La conséquence a changé de dimension en 2026. La documentation officielle de Google est explicite : pour être éligible en tant que lien source dans les AI Overviews (les réponses générées affichées en haut des résultats) ou dans AI Mode, une page doit être indexée et éligible à l'affichage d'un extrait. Search Engine Land relayait déjà cette exigence le 4 juin 2025. Autrement dit, l'indexation n'est plus seulement la porte d'entrée du référencement classique, c'est aussi celle de la visibilité dans les réponses génératives.
Le raisonnement vaut au pluriel. ChatGPT et Copilot s'appuient largement sur l'index de Bing pour leurs réponses sourcées, Perplexity fait tourner son propre robot d'exploration, Gemini puise dans l'index de Google. Une page absente de tous ces index ne sera citée par aucun de ces moteurs, quelle que soit la qualité de sa rédaction.
Détectée, explorée, indexée : trois étapes à ne pas confondre
Google traite chaque URL en quatre temps : il la découvre, il l'explore, il décide de l'indexer, puis il la classe. Confondre ces étapes est l'erreur de diagnostic la plus fréquente, parce que chacune se corrige avec des leviers totalement différents.
- Découverte : Google apprend que l'URL existe, via un lien interne, un lien externe ou votre fichier sitemap XML. À ce stade, rien n'a encore été téléchargé.
- Exploration (crawl) : Googlebot télécharge réellement la page. Cette étape dépend de votre budget de crawl et des directives de votre fichier robots.txt.
- Indexation : Google analyse le contenu, le compare à ce qu'il possède déjà, et décide de le stocker ou non. C'est ici que se joue la question de la qualité.
- Classement : l'URL indexée entre en concurrence avec les autres sur chaque requête. Une page peut être indexée et ne jamais recevoir la moindre impression.
Retenez la règle simple : être exploré ne garantit jamais d'être indexé. C'est même la source principale de frustration des propriétaires de sites, qui voient Googlebot passer dans leurs logs serveur tous les jours sans que la page apparaisse jamais dans les résultats.
Pourquoi vos pages ne sont pas indexées

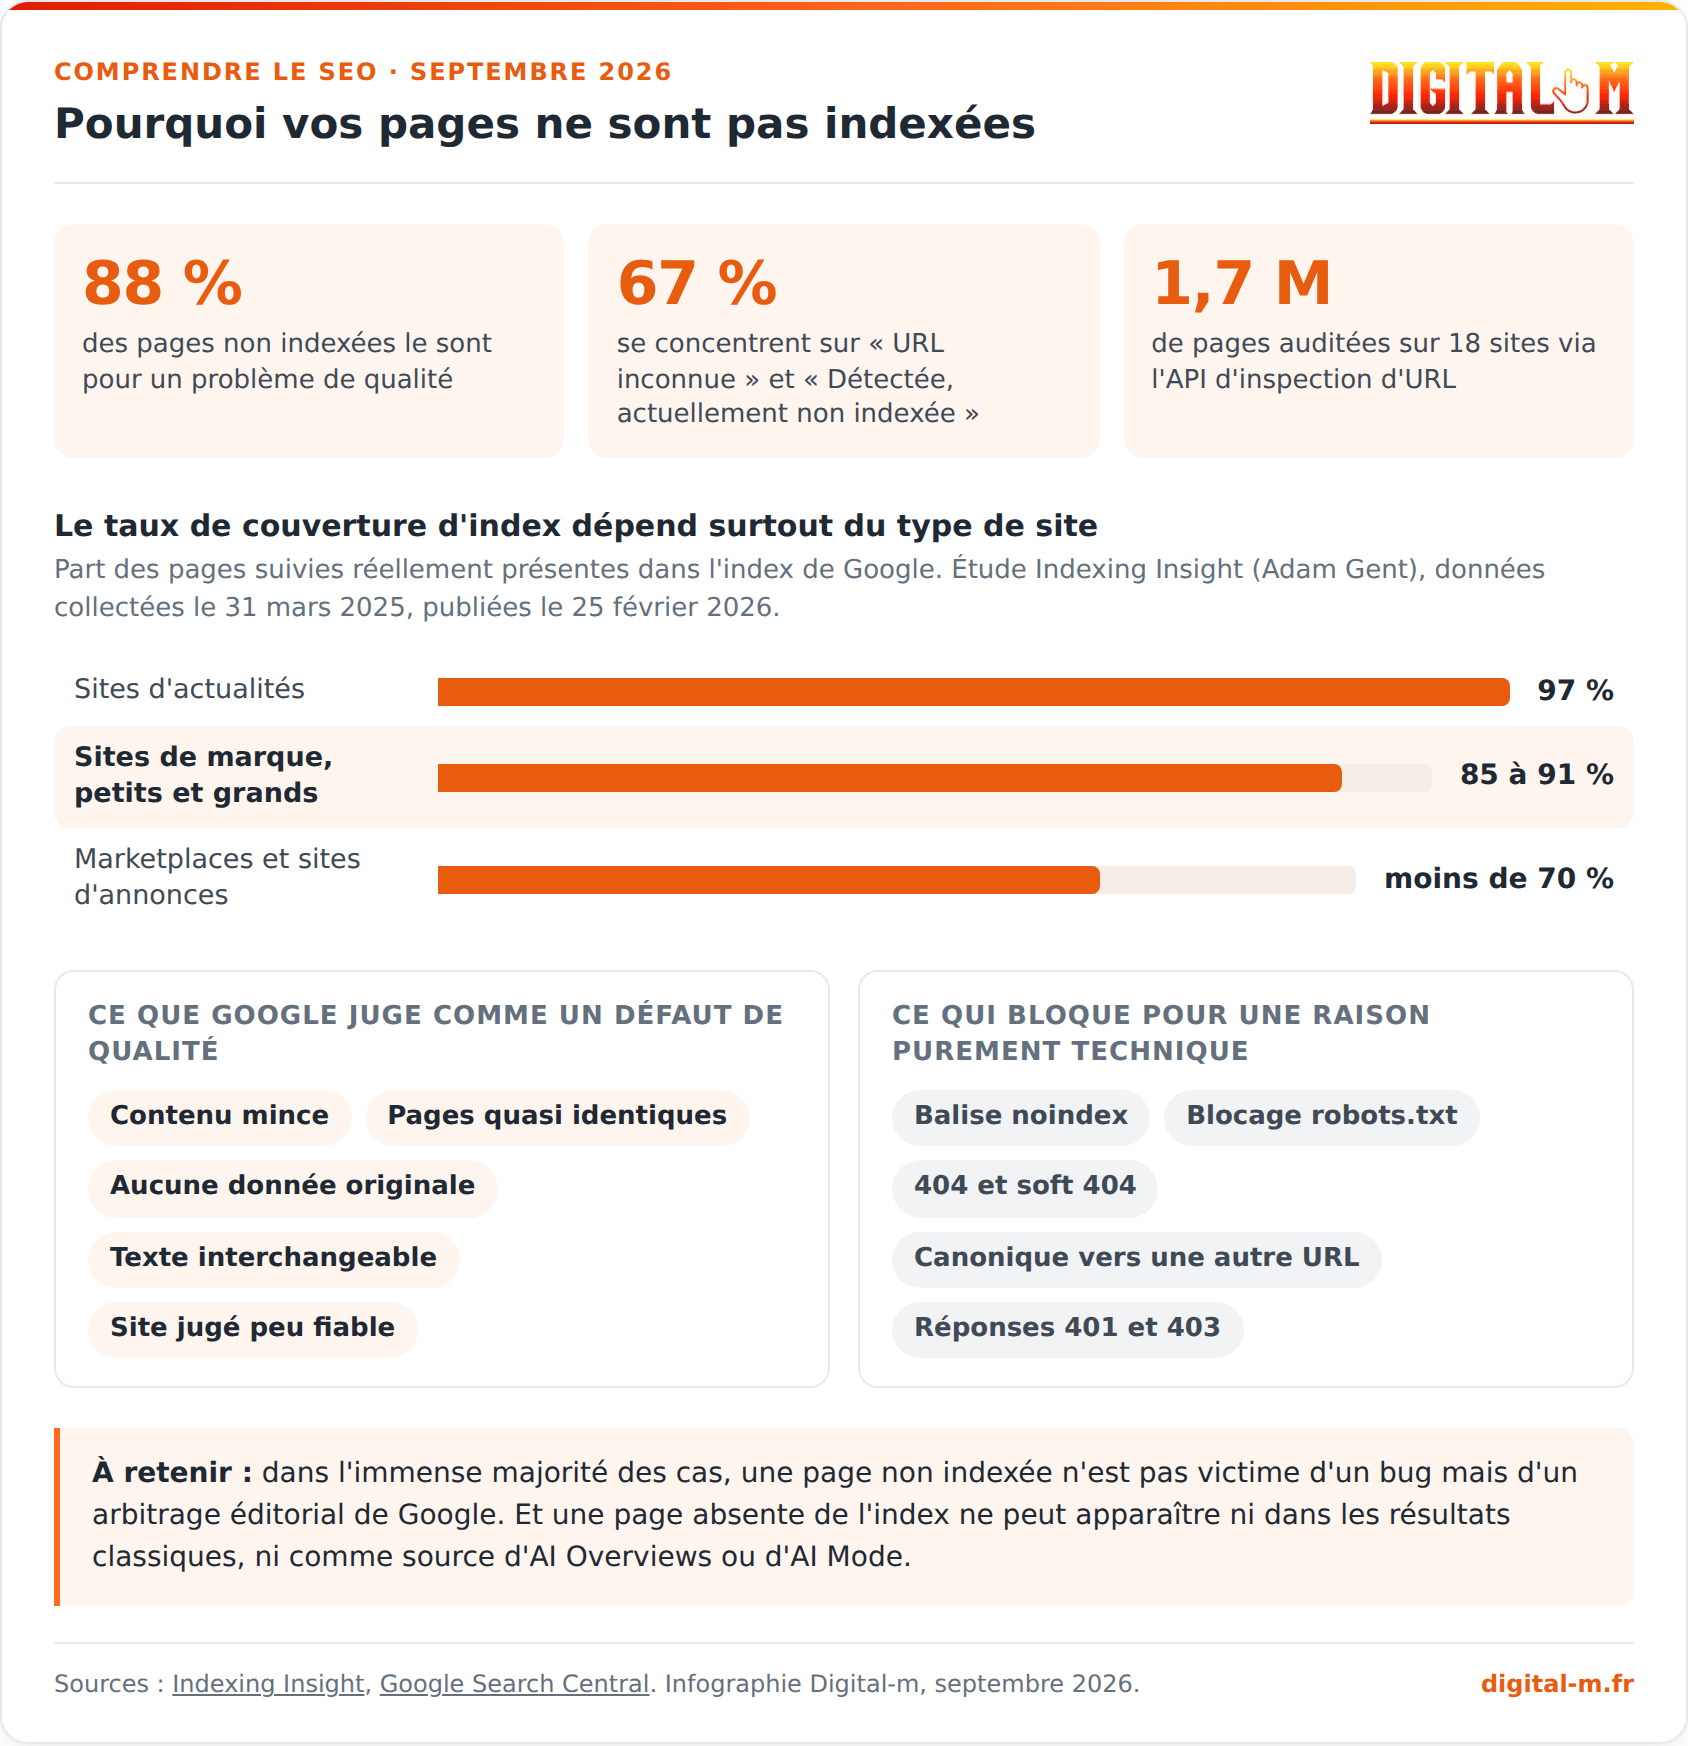
- 88 % des pages non indexées le sont pour un problème de qualité
- 67 % se concentrent sur « URL inconnue » et « Détectée, actuellement non indexée »
- 1,7 M de pages auditées sur 18 sites via l'API d'inspection d'URL
Le taux de couverture d'index dépend surtout du type de site
Part des pages suivies réellement présentes dans l'index de Google. Étude Indexing Insight (Adam Gent), données collectées le 31 mars 2025, publiées le 25 février 2026.
Ce que Google juge comme un défaut de qualité
Ce qui bloque pour une raison purement technique
À retenir : dans l'immense majorité des cas, une page non indexée n'est pas victime d'un bug mais d'un arbitrage éditorial de Google. Et une page absente de l'index ne peut apparaître ni dans les résultats classiques, ni comme source d'AI Overviews ou d'AI Mode.
Télécharger l'infographie (PNG)
Les 15 statuts « Non indexée » de la Search Console, décodés
Le rapport « Indexation des pages » de la Google Search Console classe chaque page non indexée dans l'un des quinze motifs officiels. Les lire correctement vous fait gagner des semaines, parce que trois familles de statuts appellent trois réactions opposées.
Les blocages techniques que vous avez vous-même déclenchés
Ces statuts signalent une instruction que votre site envoie à Google. « URL marquée "noindex" », « URL bloquée par le fichier robots.txt », « Bloquée en raison d'une demande non autorisée (401) », « Bloquée en raison d'une interdiction d'accès (403) », « Introuvable (404) », « Erreur "soft 404" », « Erreur serveur (5xx) » et « Erreur liée à des redirections » entrent dans cette catégorie. Bonne nouvelle : ce sont les plus faciles à corriger, car la cause est mécanique et reproductible.
Les statuts de duplication, souvent normaux
« Autre page avec balise canonique correcte », « Page en double sans URL canonique sélectionnée par l'utilisateur », « Page en double : Google a choisi une autre URL canonique que l'utilisateur » et « Page avec redirection » ne sont pas des erreurs en soi. Sur un site e-commerce, des centaines d'URL de filtres classées ainsi sont le signe d'une architecture qui fonctionne. Le sujet devient sérieux quand Google choisit une canonique différente de la vôtre, ce qui trahit un problème de contenu dupliqué et de balise canonique mal maîtrisé.
Les deux statuts de décision, les seuls vraiment inquiétants
« Détectée, actuellement non indexée » signifie que Google connaît l'URL mais ne l'a pas encore explorée. « Explorée, actuellement non indexée » signifie qu'il l'a téléchargée et a décidé de ne pas la garder. John Mueller et Martin Splitt ont rappelé cette distinction dans l'épisode de « Search Off the Record » relayé le 16 juillet 2026 par Search Engine Roundtable. Ce sont ces deux statuts, plus celui d'URL encore inconnue de Google, qui concentrent 67 % des pages non indexées dans l'étude Indexing Insight.
| Statut Search Console | Ce que Google vous dit | Niveau d'alerte |
|---|---|---|
| URL marquée « noindex » | Vous lui avez demandé de ne pas indexer | Faible, sauf si c'est involontaire |
| URL bloquée par le fichier robots.txt | Il n'a pas le droit d'explorer l'URL | Moyen |
| Autre page avec balise canonique correcte | Il a suivi votre canonique, tout va bien | Nul |
| Google a choisi une autre URL canonique | Il n'est pas d'accord avec votre canonique | Élevé |
| Détectée, actuellement non indexée | L'URL est dans la file d'attente, sans priorité | Élevé |
| Explorée, actuellement non indexée | Il a lu la page et n'en a pas voulu | Élevé |
Pourquoi Google refuse d'indexer : la qualité avant la technique
L'étude publiée le 25 février 2026 par Adam Gent sur Indexing Insight est la donnée la plus parlante disponible aujourd'hui : sur 1,7 million de pages suivies à travers 18 sites via l'API d'inspection d'URL, 88 % des problèmes d'indexation relèvent de la qualité, et non de la technique ou du crawl. Précision utile : il s'agit d'une analyse menée par l'éditeur d'un outil de surveillance de l'indexation, sur son propre parc de sites clients, non vérifiée par un tiers indépendant.
Ce que Google appelle « qualité » n'a rien de mystérieux. John Mueller l'a formulé de façon très directe à propos des contenus fabriqués en série : « Anyone could have written this. This tells me nothing », que l'on peut traduire par « n'importe qui aurait pu écrire ça, ça ne m'apprend rien ». Il ajoute que les systèmes de Google réduisent le nombre de pages indexées quand ils doutent sérieusement de la qualité globale d'un site.
Le point à comprendre est là : la décision se prend au niveau du site, pas seulement de la page. Publier trente articles interchangeables ne rend pas le trente-et-unième plus facile à indexer, cela rend l'ensemble du domaine moins prioritaire. Chez Digital-m, nous auditons régulièrement des sites où la suppression ou la fusion de pages faibles a fait remonter l'indexation des pages restantes en quelques semaines, sans avoir touché à une seule ligne de code.
Mueller précise aussi que ce n'est pas l'usage de l'IA en soi qui pose problème, mais l'absence de valeur identifiable. Un texte rédigé avec ChatGPT, Claude ou Mistral et enrichi de données de terrain, de chiffres mesurés et d'un point de vue clair passe la barre. Un texte généré puis publié tel quel, sans rien d'unique, se retrouve très souvent en « Explorée, actuellement non indexée ».
Six étapes pour faire indexer une page qui résiste
Voici la séquence que nous appliquons face à une page non indexée qui résiste, dans cet ordre précis. L'erreur classique consiste à commencer par l'étape 6, la plus visible, alors que ce sont les étapes 3 et 4 qui débloquent réellement la situation.
- 1. Vérifier l'accès : lancez l'outil d'inspection d'URL de la Search Console. Confirmez l'absence de balise noindex, l'absence de blocage robots.txt, et un code de réponse 200. Trente secondes suffisent à écarter la moitié des faux problèmes.
- 2. Contrôler la canonique : si Google a choisi une URL canonique différente de la vôtre, la page ne sera jamais indexée séparément. Rendez les deux pages réellement différentes, ou assumez la fusion.
- 3. Renforcer le maillage interne : une page orpheline, atteignable seulement depuis le sitemap, envoie le signal qu'elle n'a aucune importance. Trois à cinq liens internes contextuels depuis des pages déjà indexées changent la donne.
- 4. Augmenter la valeur unique : ajoutez ce que personne d'autre n'a, un chiffre issu de vos propres données, une photo de votre chantier, un tarif réel, un cas client. C'est le levier le plus efficace sur les statuts « Explorée, actuellement non indexée ».
- 5. Nettoyer autour : supprimez, fusionnez ou passez en noindex les pages sans valeur du même site. Vous libérez de l'attention pour celles qui comptent.
- 6. Demander l'indexation : utilisez le bouton « Demander une indexation » de l'inspection d'URL, une seule fois, puis attendez. Ce bouton place l'URL dans une file prioritaire, il ne modifie jamais la décision de fond.
Comptez plusieurs jours à plusieurs semaines entre la correction et le changement de statut. Google ne communique aucun délai garanti, et le rapport d'indexation lui-même accuse un décalage de plusieurs jours sur la réalité.
Désindexations massives en 2026 : faut-il paniquer ?
Non, dans la grande majorité des cas. Entre fin avril et juin 2026, de nombreux professionnels ont signalé des vagues de pages non indexées basculant vers « Explorée, actuellement non indexée », parfois des sites entiers, dont un site indexé depuis six ans et désindexé d'un bloc. Search Engine Journal a documenté la vague le 20 juin 2026. La réponse de John Mueller a été constante : Google ne voit « rien d'exceptionnel » dans ses données.
Un épisode plus récent illustre bien le piège. Les 8 et 9 septembre 2026, la Search Console a affiché pendant environ une heure des pages pourtant indexées avec le statut « Explorée, actuellement non indexée ». Certains SEO ont relevé jusqu'à 20 % de leurs pages concernées en interrogeant l'API pendant l'incident. Mueller a confirmé le bug d'affichage et rappelé l'essentiel : l'indexation réelle n'avait pas bougé, seule la restitution était fausse.
La leçon est simple et vaut pour tous vos tableaux de bord : vérifiez toujours un signal d'alarme dans une seconde source avant d'agir. Une recherche site: sur Google, un test dans l'inspection d'URL en direct et un coup d'œil aux impressions réelles suffisent à distinguer un vrai problème d'indexation d'un caprice du rapport.
Les erreurs qui multiplient les pages non indexées sur un site de PME
Les pages non indexées des petites structures ne ressemblent pas à celles des grands sites. Ils tournent presque toujours autour de quelques schémas très reconnaissables.
- Les pages de villes clonées : quarante pages « plombier à Nantes », « plombier à Rezé », « plombier à Saint-Herblain » identiques à un nom près. Google en indexe deux ou trois et ignore le reste. C'est le cas le plus fréquent que nous rencontrons chez les artisans.
- Le site de préproduction indexé : une version de recette ou de test laissée accessible, qui duplique l'intégralité du site officiel et brouille le choix de la canonique.
- Les archives WordPress laissées ouvertes : pages d'auteur, archives de dates, pages d'étiquettes vides. Elles gonflent le nombre d'URL à traiter sans apporter la moindre valeur.
- Les fiches produits à description fournisseur : le texte du fabricant recopié sur trois cents boutiques. Google n'a aucune raison d'indexer la trois-cent-unième version.
- La migration mal redirigée : après une refonte, les anciennes URL renvoient vers la page d'accueil au lieu de leur équivalent. Google interprète ces redirections comme des soft 404 et sort les pages de l'index.
Aucun de ces cas ne se règle avec un plugin. Ils se règlent avec des choix éditoriaux : moins de pages, chacune portant une information que le visiteur ne trouve pas ailleurs.
Indexation et GEO : sans index, pas de citation
L'indexation est devenue le premier chantier GEO, avant même la structuration du contenu. La raison est mécanique : les moteurs génératifs ne vont pas chercher vos pages au hasard sur le web, ils piochent dans des index existants.
- Google, Gemini et AI Mode : ils s'appuient sur l'index de Google Search. Une page non indexée est hors jeu par construction, comme le dit la documentation officielle.
- ChatGPT et Copilot : leurs réponses sourcées reposent en grande partie sur l'index de Bing. Une page bien indexée par Google mais ignorée par Bing perd cette porte d'entrée.
- Perplexity : il fait tourner son propre robot d'exploration, ce qui ajoute une troisième condition d'accès à surveiller.
Détail que beaucoup ignorent : le protocole IndexNow (un mécanisme qui permet à un site de signaler instantanément une URL nouvelle ou modifiée) est pris en charge par Bing et Yandex, mais Google ne l'a jamais adopté au-delà de tests annoncés en 2022. Activer IndexNow accélère donc votre présence côté Bing, et indirectement côté ChatGPT et Copilot, sans effet sur Google.
Une fois l'indexation acquise, la bataille se déplace sur le terrain de la citabilité. Pour savoir quelles pages de votre site sont réellement citées par l'IA, il faut suivre les mentions modèle par modèle. C'est exactement le travail que mène notre agence GEO, et le sujet central de notre formation GEO certifiée Qualiopi.
Ce qu'il faut retenir
Une page non indexée n'est presque jamais un accident technique. Les chiffres d'Indexing Insight le disent sans détour : 88 % des cas relèvent d'un arbitrage de qualité, et 67 % des pages non indexées se concentrent sur les statuts « URL inconnue » et « Détectée, actuellement non indexée ».
Les trois réflexes qui règlent la majorité des situations : lire le statut exact dans la Search Console avant de toucher à quoi que ce soit, distinguer un blocage technique d'un refus éditorial, et renforcer la valeur unique de la page plutôt que multiplier les demandes d'indexation. Ajoutez-y une vérification en seconde source avant toute panique, les incidents de septembre 2026 ont montré à quel point le rapport peut mentir une heure durant.
Vous accumulez les pages non indexées et vous ne savez pas par quel bout attaquer ? Demandez un audit d'indexation à Digital-m : nous croisons vos statuts Search Console, vos logs serveur et votre maillage interne pour identifier ce qui bloque vraiment, et nous vous remettons un plan d'action priorisé.
Combien de pages non indexées compte votre site aujourd'hui ? Dites-le nous en commentaire !Sources et références
- Google Search Central - Rapport sur l'indexation des pages, aide Search Console (consulté en septembre 2026)
- Google Search Central - AI Features and Your Website (documentation officielle)
- Search Engine Land - To show in Google AI Mode and AI Overviews, your page must be indexed (4 juin 2025)
- Indexing Insight - Why Pages are Not Indexed in Google, étude d'Adam Gent (25 février 2026)
- Search Engine Roundtable - Google On Discovered vs Crawled Not Indexed Quality Issues and AI-Generated Content (16 juillet 2026)
- Search Engine Journal - Deindexing Reports Keep Coming, Google Sees Nothing Unusual (20 juin 2026)
- Search Engine Roundtable - Google Confirmed Indexing Reporting Bug (9 septembre 2026)
- Ahrefs Blog - Crawled, currently not indexed (mis à jour le 15 juillet 2026)
- Bing Webmaster Blog - IndexNow Drives Smarter and Faster Content Discovery (19 mai 2025)
Questions fréquentes sur les pages non indexées par Google
Comment savoir si ma page est indexée par Google ?
Collez l'URL complète dans l'outil d'inspection d'URL de la Google Search Console : il répond « L'URL est sur Google » ou indique le motif d'exclusion. En l'absence d'accès à la Search Console, tapez la commande site:votresite.fr/votre-page dans Google. Aucun résultat signifie très probablement une page non indexée.
Combien de temps Google met-il à indexer une nouvelle page ?
Google ne communique aucun délai garanti. En pratique, un site actif et bien maillé voit ses nouvelles pages indexées en quelques jours, un site récent ou peu lié peut attendre plusieurs semaines. Le rapport d'indexation de la Search Console ajoute par ailleurs son propre décalage de quelques jours sur la réalité de l'index.
« Détectée, actuellement non indexée » : que faut-il faire ?
Ce statut signifie que Google connaît l'URL mais ne l'a pas encore explorée, faute de priorité. Deux leviers fonctionnent : renforcer le maillage interne vers cette page depuis des pages déjà indexées, et réduire le nombre d'URL sans valeur du site pour concentrer l'attention de Googlebot. Soumettre l'URL en boucle n'a aucun effet.
Le bouton « Demander une indexation » accélère-t-il vraiment les choses ?
Il place l'URL dans une file d'exploration prioritaire, avec un quota quotidien limité par propriété. Il ne change jamais la décision d'indexation elle-même. Si la page ressort en « Explorée, actuellement non indexée », la redemander dix fois ne servira à rien : c'est le contenu qu'il faut retravailler.
Une page non indexée peut-elle être citée par ChatGPT ou Gemini ?
Très difficilement. Gemini et AI Mode s'appuient sur l'index de Google, et la documentation officielle exige qu'une page soit indexée pour être éligible comme lien source. ChatGPT et Copilot s'appuient largement sur l'index de Bing, Perplexity sur son propre robot. Une page absente de ces index n'a donc pratiquement aucune chance d'être citée.