
Contenu dupliqué : Google pénalise-t-il vraiment ?
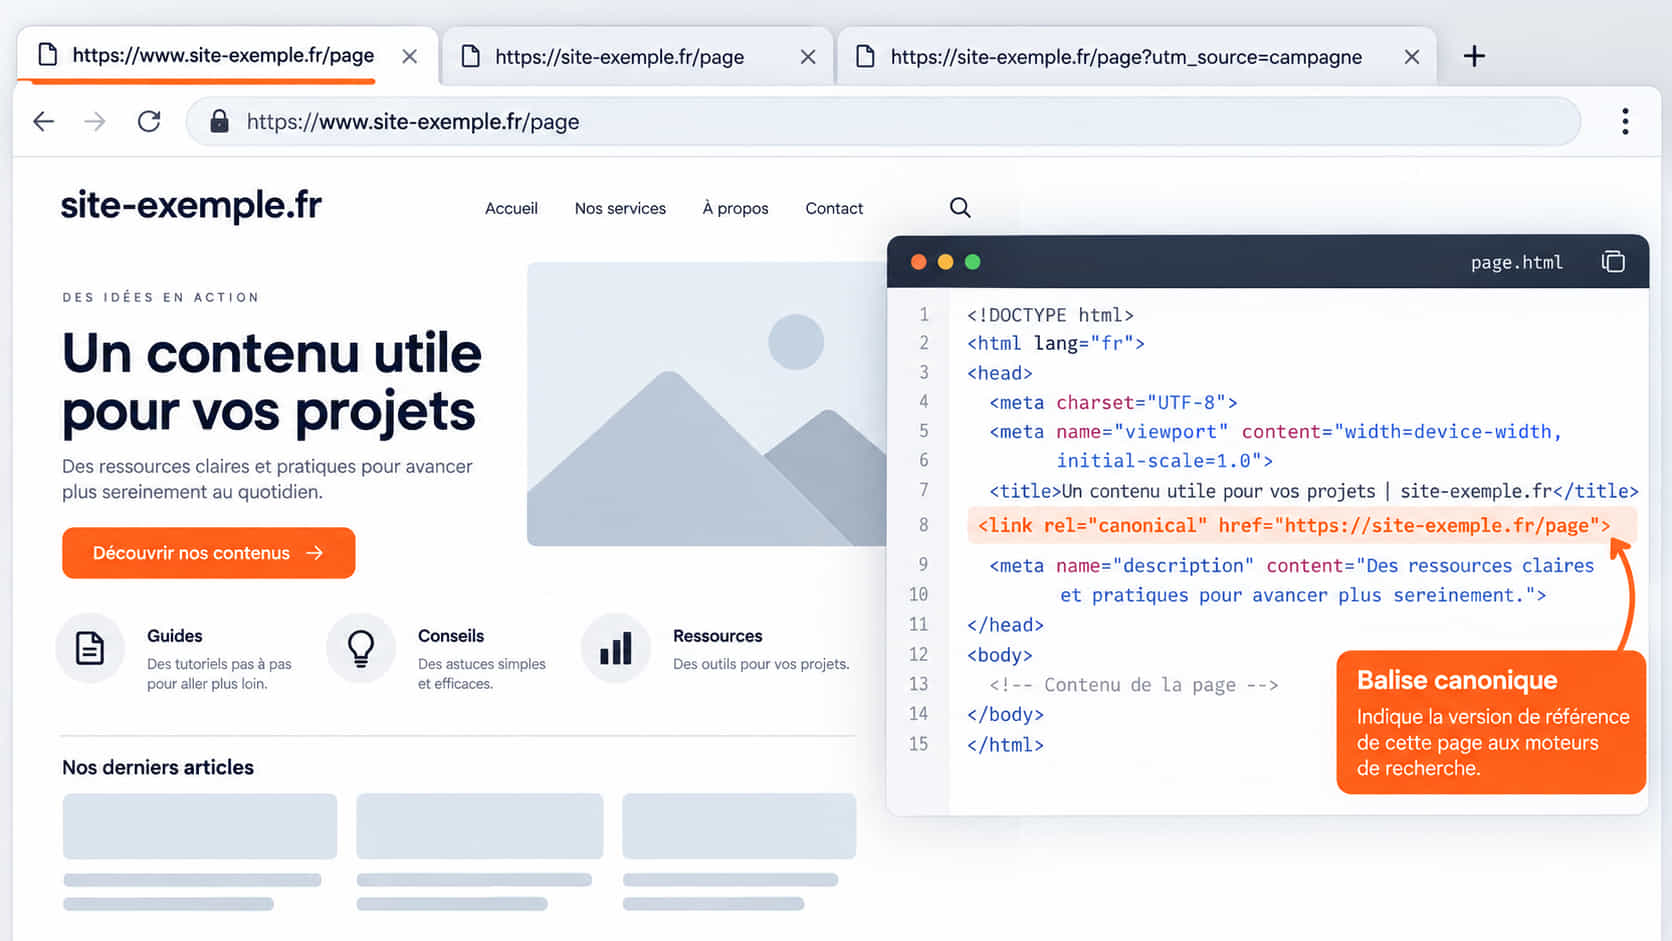
Il n'existe pas de pénalité pour contenu dupliqué. Google le dit noir sur blanc dans sa documentation officielle : une part de duplication sur un site est normale et ne constitue pas une violation de ses règles anti-spam. Pourtant, la duplication reste l'un des problèmes techniques qui coûtent le plus de trafic, pour une raison beaucoup plus banale qu'une sanction : quand plusieurs adresses servent le même contenu, Google en choisit une seule, et ce n'est pas toujours celle que vous auriez choisie. La balise canonical existe pour peser dans ce choix. Voici comment elle fonctionne réellement, où elle échoue, et comment auditer votre site en une heure.
-
- Dernière modification
13 septembre 2026 - 9 minutes de lecture
Contenu dupliqué : la réponse courte de Google
Google n'applique aucune pénalité au contenu dupliqué en tant que tel. Sa documentation Search Central est explicite : une certaine duplication sur un site est normale, elle ne constitue pas une infraction aux règles anti-spam, même si elle peut nuire à l'expérience utilisateur et brouiller le suivi des performances.
Ce que Google fait, en revanche, c'est regrouper les pages identiques ou très proches en grappes, puis désigner une adresse représentative qu'il appelle l'URL canonique. Seule cette version est retenue pour l'évaluation du contenu et affichée dans les résultats. Les autres existent toujours, mais elles ne rapportent rien. Le problème n'est donc pas une sanction, c'est une perte d'influence sur le choix de la page qui vous représente.
- Ce qui n'arrive pas : une pénalité manuelle ou algorithmique déclenchée par la seule présence de doublons internes.
- Ce qui arrive : Google choisit une URL à votre place, parfois la version avec paramètres de tracking, parfois l'ancienne adresse.
- Ce qui arrive aussi : vos signaux de popularité se répartissent entre plusieurs adresses au lieu de se concentrer sur une seule.
- Ce qui coûte le plus cher : du budget d'exploration gaspillé sur des adresses qui ne seront jamais affichées.
D'où vient la duplication sur un site parfaitement normal
La duplication naît rarement d'une intention de tricher. Google liste lui-même les causes les plus fréquentes, et elles sont toutes techniques : variantes régionales d'un même contenu, versions pour mobile et pour ordinateur, cohabitation du protocole HTTP et HTTPS, fonctions de filtrage et de tri, et duplications accidentelles.
En pratique, sur les audits que nous menons chez Digital-m, cinq générateurs reviennent systématiquement, quel que soit le secteur du client.
- Les variantes d'adresse : avec ou sans www, avec ou sans barre oblique finale, en majuscules ou en minuscules. Quatre combinaisons pour une seule page.
- Les paramètres de suivi : les campagnes UTM, les identifiants de session et les codes d'affiliation créent autant d'adresses distinctes que de campagnes.
- Les filtres et les tris : une page catégorie qui accepte le tri par prix, par marque et par disponibilité peut générer des centaines d'adresses au contenu quasi identique.
- Les fiches produit déclinées : une même référence en cinq tailles et trois coloris, avec un descriptif commun.
- Le rendu différencié : une version imprimable, une version accélérée ou un rendu servi par un réseau de distribution de contenu qui perd la balise canonique au passage.
Duplication normale ou abus : la ligne de Google

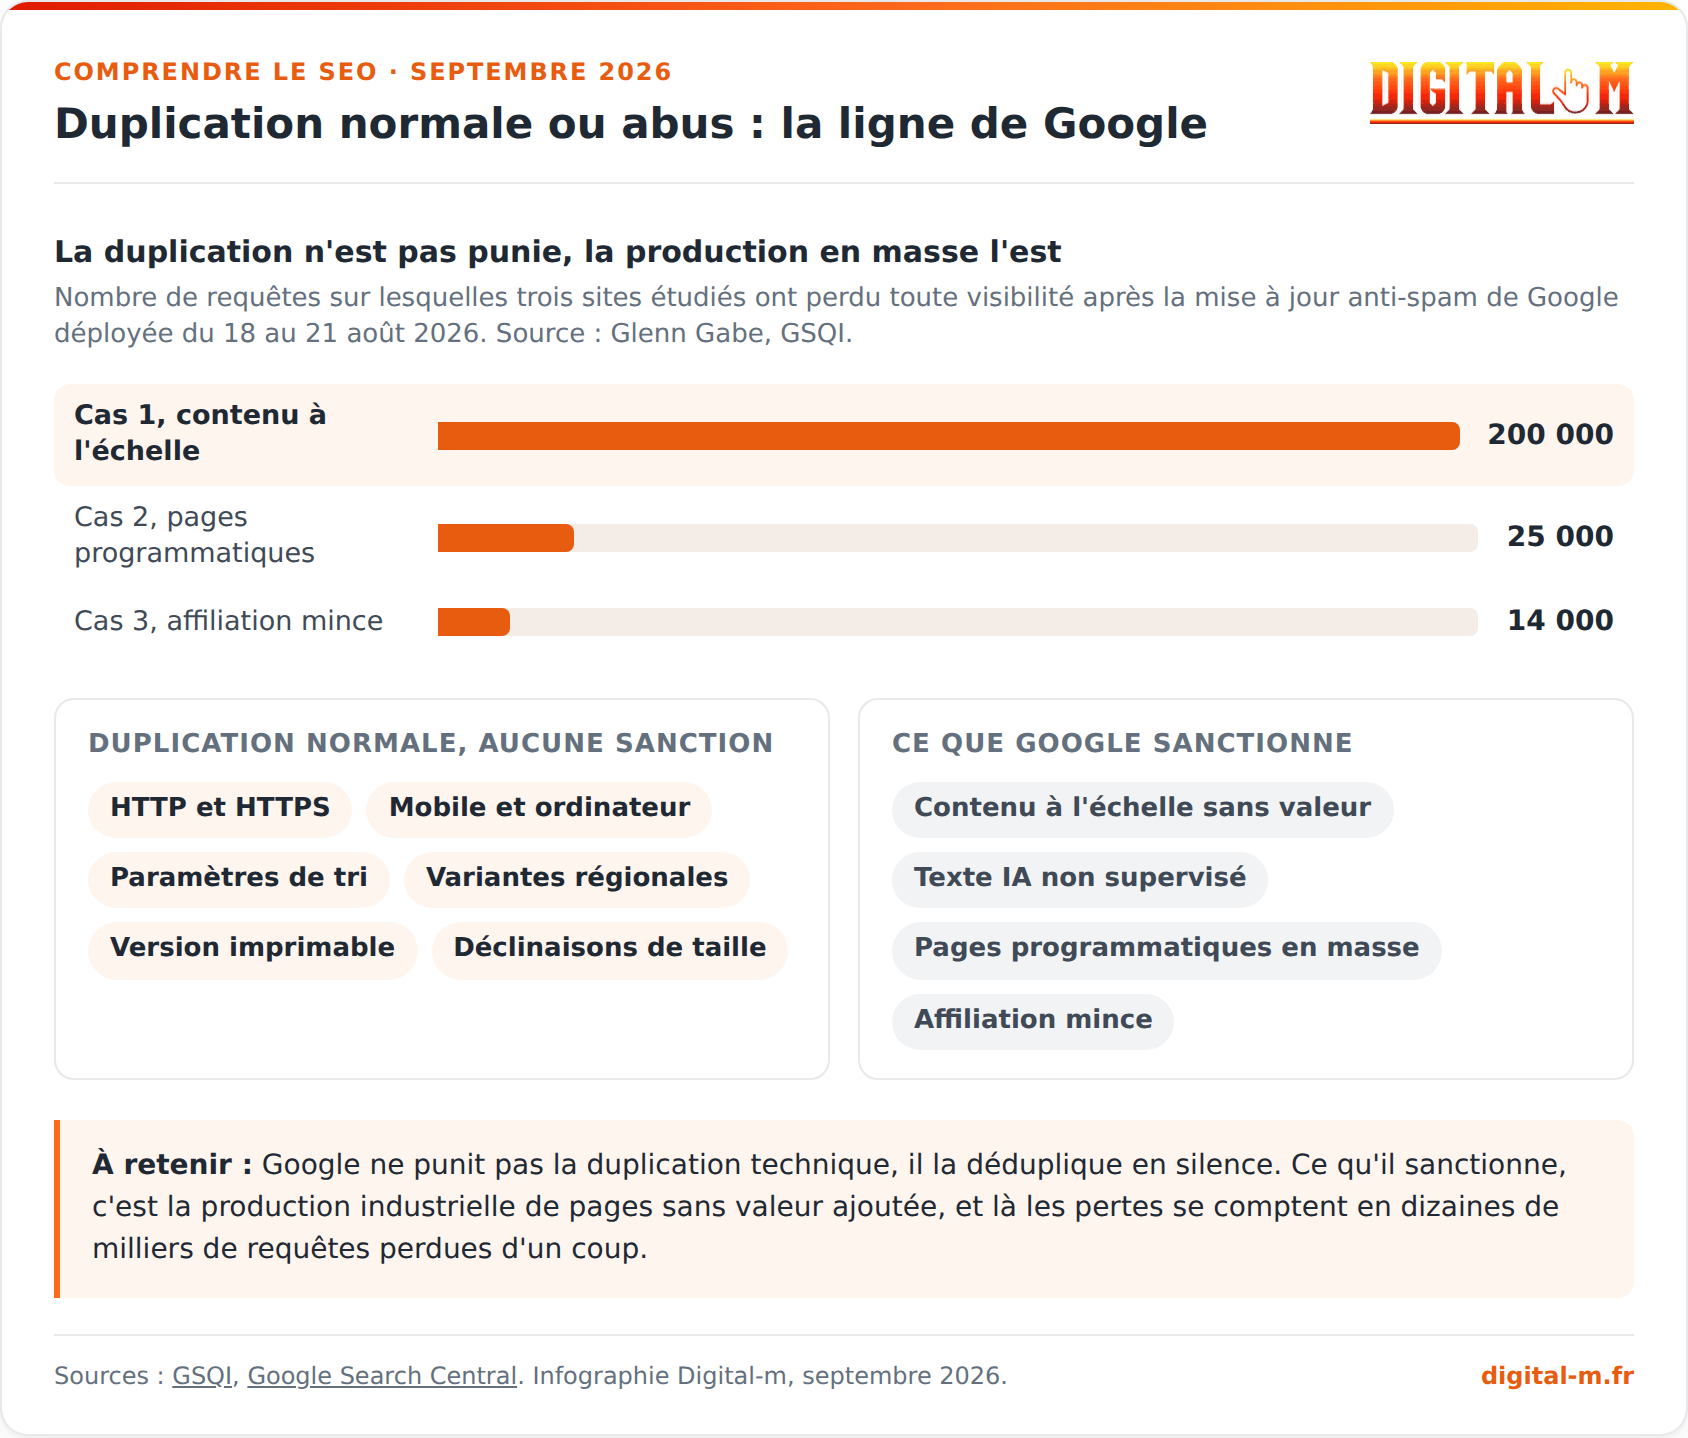
La duplication n'est pas punie, la production en masse l'est
Nombre de requêtes sur lesquelles trois sites étudiés ont perdu toute visibilité après la mise à jour anti-spam de Google déployée du 18 au 21 août 2026. Source : Glenn Gabe, GSQI.
Duplication normale, aucune sanction
Ce que Google sanctionne
À retenir : Google ne punit pas la duplication technique, il la déduplique en silence. Ce qu'il sanctionne, c'est la production industrielle de pages sans valeur ajoutée, et là les pertes se comptent en dizaines de milliers de requêtes perdues d'un coup.
Télécharger l'infographie (PNG)
Interne, externe, quasi-duplication : trois situations distinctes
Regrouper tous les doublons sous une seule étiquette mène à appliquer la mauvaise solution. Trois cas existent, avec trois traitements différents.
La duplication interne
Plusieurs adresses de votre propre site servent le même contenu. C'est le cas le plus fréquent et le plus simple à corriger, par redirection ou par balise canonique. Il ne faut pas le confondre avec la cannibalisation SEO, où deux pages différentes visent la même intention de recherche : là, le contenu diffère, c'est le ciblage qui se chevauche, et la solution passe par une fusion ou une désoptimisation.
La duplication externe
Votre contenu apparaît sur un autre domaine : reprise de communiqué, syndication, place de marché, ou copie pure et simple. Google choisit alors la version qu'il juge la plus utile, et ce n'est pas nécessairement la vôtre. La parade consiste à demander une canonique croisée à votre partenaire, ou à publier en premier avec une date visible et un balisage clair.
La quasi-duplication
Le cas le plus insidieux : des pages différentes à 5 %, typiquement des fiches produit qui ne varient que par une taille, ou des pages de ville où seul le nom de la commune change. Aucune n'est un copier-coller, mais l'ensemble n'apporte rien de neuf. C'est précisément ce que visent les mises à jour anti-spam récentes.
La balise canonical est un indice, pas un ordre
La documentation de Google est sans ambiguïté sur ce point : déclarer une URL canonique constitue « un indice, pas une règle ». Google peut retenir une adresse différente de celle que vous indiquez, s'il juge une autre version objectivement plus complète et plus utile pour l'internaute.
Cette nuance explique la moitié des incompréhensions que nous rencontrons en audit. Une balise canonique correctement posée qui n'est pas respectée n'est pas un bug : c'est un désaccord. Dans ce cas, la bonne question n'est pas « comment forcer Google » mais « pourquoi ma page préférée paraît moins complète que l'autre ». Le rapport d'indexation de la Search Console affiche d'ailleurs, pour chaque adresse, la canonique déclarée par vous et celle sélectionnée par Google : l'écart entre les deux colonnes est le meilleur point de départ d'un audit.
Les quatre méthodes officielles, classées par force
Google hiérarchise explicitement les signaux de canonisation. Connaître cet ordre évite de perdre du temps sur la méthode la plus faible.
| Méthode | Force du signal | Cas d'usage recommandé |
|---|---|---|
| Redirection 301 | Forte | La version obsolète ne doit plus exister du tout |
| Balise rel="canonical" | Forte | Les deux versions doivent rester accessibles aux visiteurs |
| En-tête HTTP rel="canonical" | Forte | Fichiers non HTML, notamment les PDF |
| Présence dans le sitemap XML | Faible | Renfort complémentaire sur les grands sites |
Deux signaux automatiques s'ajoutent à cette liste : Google privilégie spontanément le HTTPS sur le HTTP, et tient compte des grappes de langues déclarées en hreflang. Trois pratiques sont en revanche à proscrire formellement, toujours selon la documentation officielle.
- Le robots.txt : bloquer l'exploration d'un doublon empêche Google de lire la balise canonique qui s'y trouve. Le fichier robots.txt n'est pas un outil de canonisation.
- La balise noindex : appliquée à des doublons, elle risque de retirer toutes les versions des résultats, y compris celle que vous vouliez garder.
- Les signaux contradictoires : une canonique dans le HTML qui désigne une adresse, un en-tête HTTP qui en désigne une autre, et Google tranche seul.
Les erreurs de canonical les plus fréquentes en 2026
Une balise mal posée fait plus de dégâts qu'une balise absente, parce qu'elle envoie un signal fort dans la mauvaise direction. Voici les cinq erreurs que nous corrigeons le plus souvent.
- Canoniser toute la pagination vers la page 1 : les pages 2, 3 et suivantes deviennent invisibles, et les produits qu'elles contiennent aussi. Google ayant abandonné les signaux rel="prev" et rel="next", chaque page paginée doit porter sa propre canonique auto-référencée.
- Poser plusieurs canoniques sur une même page : souvent le fait d'un cumul entre le thème, une extension SEO et un module de cache. Google ignore alors généralement l'ensemble.
- Pointer vers une page redirigée ou en erreur 404 : la chaîne se casse et le signal se perd.
- Mélanger les versions d'adresse : une canonique en HTTP sur un site en HTTPS, ou avec www sur un site sans www.
- Perdre la balise au rendu : un rendu servi en périphérie de réseau ou une page générée côté client peut supprimer la canonique du code final. Vérifiez toujours le HTML réellement rendu, pas seulement le modèle.
Sur les sites e-commerce, le sujet croise directement l'optimisation des pages de listes, que nous détaillons dans notre guide du SEO d'une page catégorie e-commerce. Et lors d'un changement de structure, la canonisation fait partie des points de contrôle que nous documentons dans notre méthode de refonte de site sans perte de SEO.
Quand la duplication devient vraiment un problème
Il existe une frontière au-delà de laquelle la duplication cesse d'être un simple désordre technique. Google a déployé une mise à jour anti-spam du 18 au 21 août 2026, bouclée en un peu plus de deux jours, qui visait quatre pratiques : la production de contenu à grande échelle sans valeur ajoutée, le texte généré par IA sans supervision humaine, les pages programmatiques produites en masse, et les pages d'affiliation minces.
Les cas documentés par Glenn Gabe (GSQI) sont brutaux. Il ne s'agit pas de reculs de positions mais de disparitions complètes : un site a perdu toute visibilité sur plus de 200 000 requêtes, un autre sur environ 25 000, un troisième sur près de 14 000. Le point commun de ces sites est la quasi-duplication à l'échelle industrielle, souvent au-delà du million et demi d'adresses indexées.
La ligne est donc claire : dupliquer une page pour des raisons techniques n'est pas un problème, générer dix mille variantes d'une même page pour couvrir dix mille requêtes en est un. La différence tient à la valeur ajoutée réellement apportée par chaque adresse supplémentaire.
Et du côté des moteurs génératifs ?
ChatGPT, Perplexity, Gemini et Copilot n'ont pas de notion de pénalité, mais ils rencontrent le même arbitrage : face à plusieurs adresses servant le même texte, ils en citent une seule. Si vos signaux de canonisation sont incohérents, la version citée peut être une adresse avec paramètres de campagne, ou une copie hébergée sur une place de marché. Nettoyer sa canonisation sert donc autant le référencement classique que la visibilité dans les réponses IA.
Auditer votre site en une heure
Un contrôle sérieux ne demande pas de projet dédié. Voici la séquence que nous appliquons en ouverture de chaque audit technique, réalisable avec la Search Console et un outil d'exploration.
- Étape 1, le rapport d'indexation : dans la Search Console, ouvrez le rapport « Pages » et repérez les motifs « Page en double, Google n'a pas sélectionné la même page canonique que l'utilisateur » et « Autre page avec balise canonique correcte ». Le premier motif signale un désaccord à traiter en priorité.
- Étape 2, l'exploration complète : lancez un crawl du site et exportez la colonne des canoniques déclarées. Filtrez sur les pages sans canonique, avec plusieurs canoniques, ou dont la canonique pointe vers une redirection.
- Étape 3, le test des variantes : saisissez manuellement vos adresses avec et sans www, en HTTP et en HTTPS, avec et sans barre oblique finale. Chacune doit rediriger en 301 vers une seule et même version.
- Étape 4, les paramètres : vérifiez qu'une adresse avec paramètre de campagne porte bien une canonique vers la version propre.
- Étape 5, la pagination : contrôlez que les pages 2 et suivantes se canonisent vers elles-mêmes et non vers la page 1.
Ce nettoyage a un effet secondaire souvent sous-estimé : il libère du budget d'exploration, que Google réaffecte à vos pages utiles. Sur un catalogue de plusieurs milliers de références, le gain d'indexation est généralement visible en trois à six semaines.
Ce qu'il faut retenir
Le contenu dupliqué n'entraîne pas de pénalité : Google regroupe les doublons et désigne une URL canonique parmi eux. Votre travail consiste à peser sur ce choix plutôt qu'à le subir. La redirection 301 et la balise rel="canonical" sont les deux signaux forts, l'inscription au sitemap un signal faible, et le robots.txt comme la balise noindex ne sont pas des outils de canonisation. Rappelez-vous que la canonique reste un indice : si Google ne la suit pas, la page qu'il préfère est probablement plus complète que la vôtre.
La vraie ligne rouge est ailleurs. Elle sépare la duplication technique, inoffensive, de la production industrielle de pages sans valeur, que la mise à jour anti-spam du 18 au 21 août 2026 a frappée avec des pertes atteignant 200 000 requêtes sur un seul site. Chez Digital-m, nous intégrons ce contrôle dès la conception des sites que nous construisons, plutôt que de le traiter en rattrapage. Si vous soupçonnez un problème de canonisation sur votre site, parlons-en, et si vous préférez former vos équipes à le détecter seules, nos formations certifiées Qualiopi couvrent ce point en atelier pratique.
Avez-vous déjà vérifié quelle URL Google a choisie comme canonique pour votre page la plus importante ? Dites-le nous en commentaire !Sources et références
- Google Search Central - What is URL Canonicalization (documentation officielle)
- Google Search Central - How to Specify a Canonical with rel="canonical" and Other Methods (documentation officielle)
- Search Engine Land - Canonicalization and SEO: A guide for 2026, Lauren Busby (25 novembre 2025)
- GSQI - August 2026 Google Spam Update: Scaled Content Abuse, AI Content, Programmatic Content, Thin Affiliates, Glenn Gabe
- Search Engine Roundtable - September 2026 Google Webmaster Report, Barry Schwartz (1er septembre 2026)
Questions fréquentes sur le contenu dupliqué
Google pénalise-t-il le contenu dupliqué ?
Non. La documentation officielle de Google indique qu'une part de duplication sur un site est normale et ne constitue pas une violation des règles anti-spam. Google déduplique simplement : il regroupe les pages identiques et n'en retient qu'une. Ce qui est sanctionné, c'est la production massive de pages sans valeur ajoutée, une pratique différente.
Quelle différence entre une redirection 301 et une balise canonical ?
La redirection 301 supprime l'accès à l'ancienne adresse : le visiteur comme le robot arrivent sur la nouvelle. La balise canonical laisse les deux pages accessibles aux visiteurs tout en indiquant laquelle indexer. Utilisez la 301 quand la version dupliquée n'a plus d'utilité, et la canonical quand elle doit rester consultable, par exemple une page filtrée.
Pourquoi Google ignore-t-il ma balise canonical ?
Parce qu'il s'agit d'un indice, pas d'une règle. Google retient la version qu'il juge la plus complète et la plus utile. Vérifiez d'abord la cohérence technique (canonique unique, cible en 200, même protocole et même sous-domaine), puis comparez le contenu des deux pages : celle que Google a choisie est souvent plus riche ou mieux liée en interne.
Faut-il canoniser les pages de pagination vers la page 1 ?
Non, c'est une erreur classique qui rend le contenu des pages suivantes indécouvrable. Google n'utilise plus les signaux rel="prev" et rel="next" : chaque page paginée doit porter une balise canonique qui pointe vers elle-même. La page 2 se canonise vers la page 2, la page 3 vers la page 3.
Le contenu dupliqué nuit-il à ma visibilité dans ChatGPT ou Perplexity ?
Indirectement, oui. Les moteurs génératifs n'appliquent pas de pénalité, mais ils ne citent qu'une adresse par contenu. Si vos signaux sont incohérents, la version citée peut être une URL avec paramètres de campagne ou une copie hébergée ailleurs, et votre marque perd l'attribution. Une canonisation propre profite donc aux deux canaux.