
Fausses informations IA sur votre entreprise : que faire ?
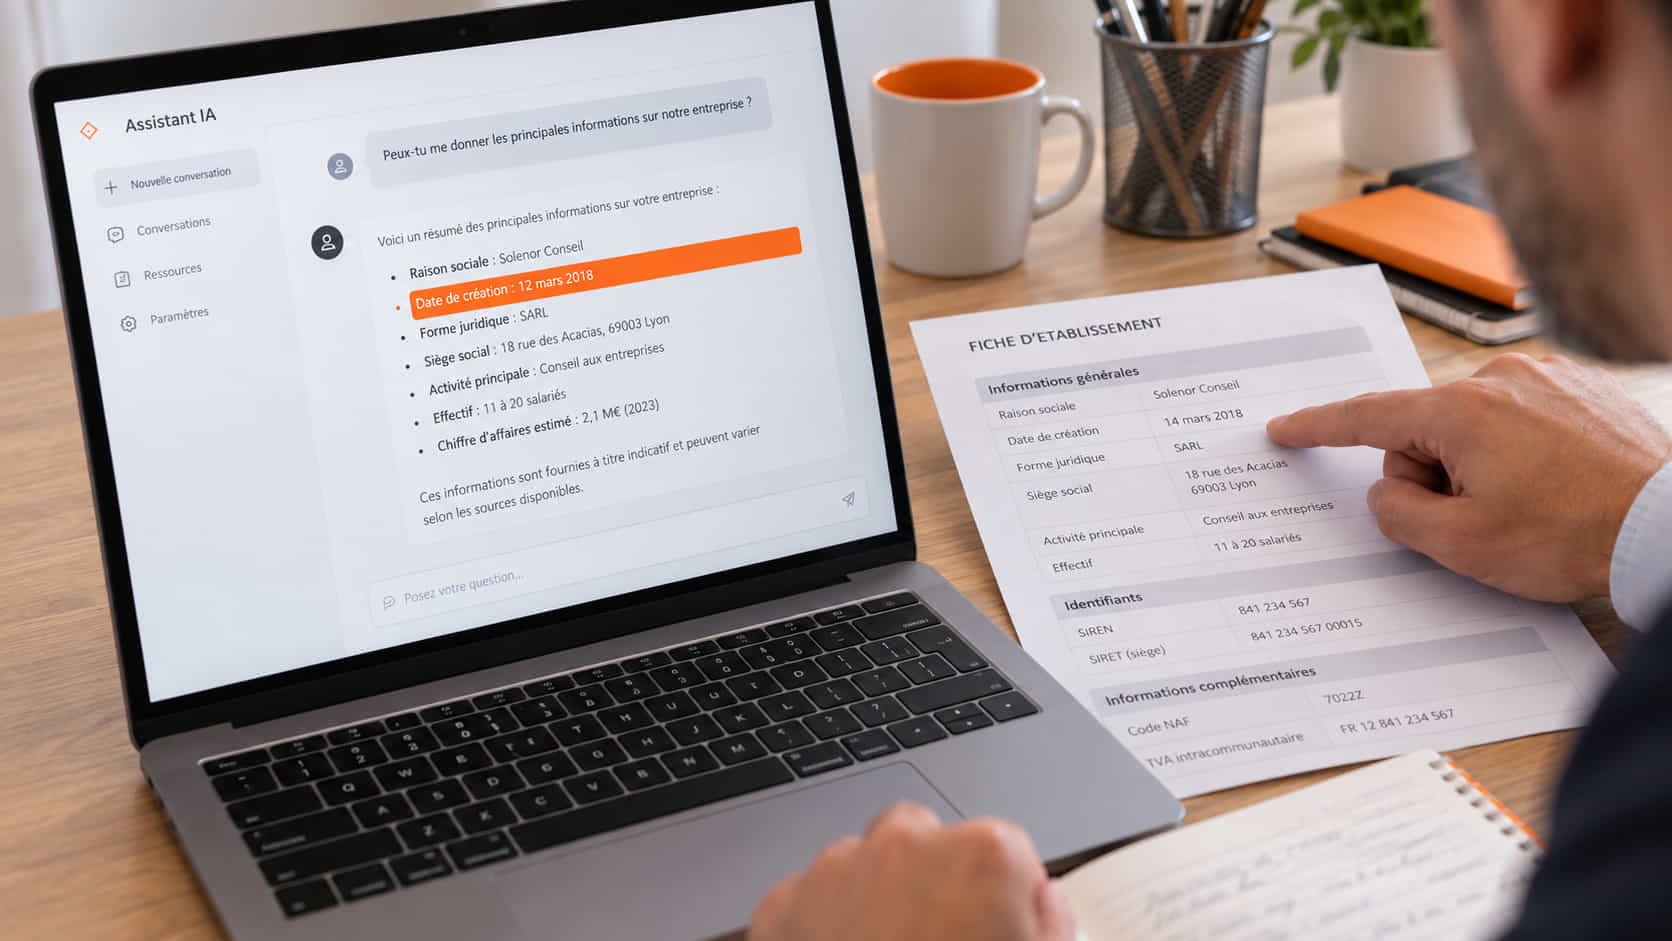
82,91 % des recherches portant sur un nom de marque déclenchent désormais un résumé généré par l'IA dans Google, contre 65,1 % en août 2026 selon les données Ahrefs relayées par Semrush le 6 octobre 2026. Quand un prospect tape le nom de votre entreprise, c'est donc une machine qui répond la première. Si cette machine se trompe sur vos tarifs, votre adresse, votre activité ou le nom de votre dirigeant, l'erreur devient la première impression. Les fausses informations IA ne sont plus une curiosité technique, elles pèsent sur vos devis. Bonne nouvelle, la majorité se corrigent. Mauvaise nouvelle, aucun moteur génératif ne propose de bouton « corriger ». Voici le protocole couche par couche pour reprendre la main.
-

- Dernière modification
7 octobre 2026 - 10 minutes de lecture
Fausses informations IA : de quoi parle-t-on exactement ?
Une fausse information IA est une affirmation inexacte sur votre entreprise, produite par un moteur génératif et présentée au lecteur comme un fait établi. Elle concerne tous les assistants : ChatGPT, Gemini, Perplexity, Copilot, Le Chat de Mistral, Grok, et les applications construites sur Llama ou DeepSeek. Trois familles d'erreurs se distinguent, et chacune se corrige par un levier différent.
- L'hallucination pure : le modèle invente une information qui n'existe nulle part, un tarif, un partenariat, une certification. Elle vient des poids du modèle, pas d'une page web.
- L'information périmée : l'IA cite une donnée vraie il y a dix-huit mois, un ancien gérant, une adresse abandonnée, un prix d'avant augmentation. La source existe, elle n'est simplement plus à jour.
- La confusion d'entité : le moteur mélange votre société avec une homonyme, un ancien employeur ou une marque proche. C'est le cas le plus fréquent pour les TPE et les artisans dont le nom commercial ressemble à celui d'un concurrent.
Cette typologie n'est pas académique. Un diagnostic qui confond une hallucination et une donnée périmée fait perdre des semaines, parce que le levier de correction n'est pas le même. Nous détaillons ces mécanismes d'invention dans notre article sur les hallucinations des LLM et leurs taux par modèle.
Pourquoi une erreur coûte beaucoup plus cher en 2026
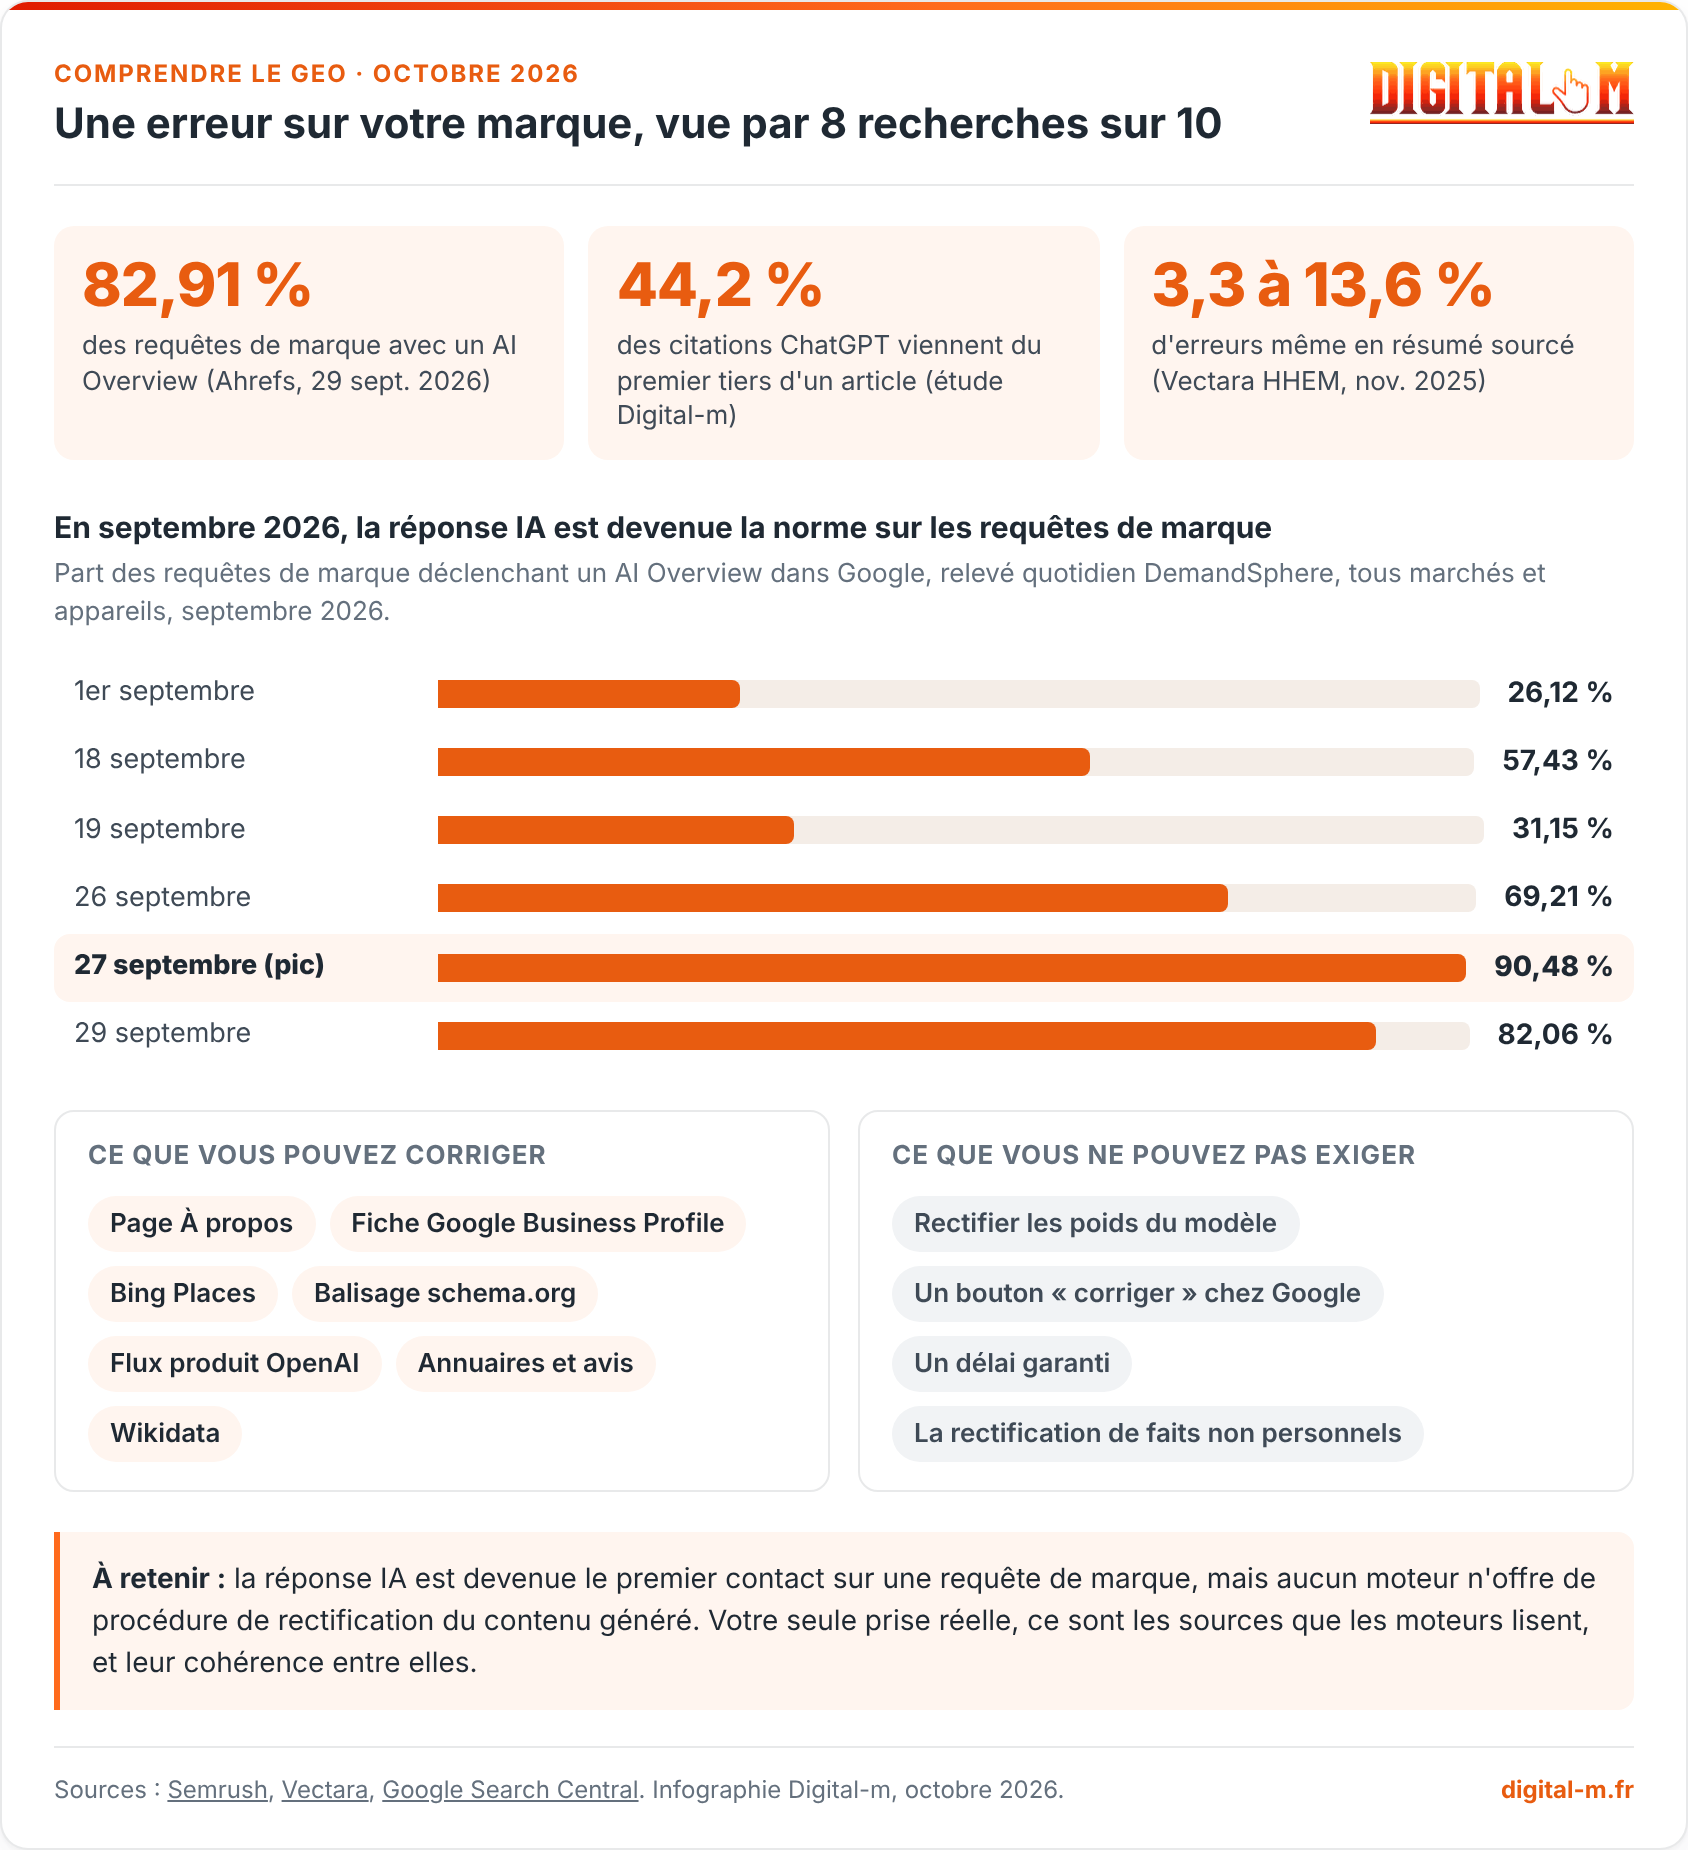
Parce que la réponse IA est devenue la réponse par défaut sur les requêtes de marque. Le suivi quotidien de DemandSphere, publié par Semrush le 6 octobre 2026, montre une bascule brutale sur le mois de septembre : 26,12 % des requêtes de marque affichaient un AI Overview le 1er septembre 2026, 90,48 % au pic du 27 septembre, et 82,06 % le 29 septembre. Les relevés d'Ahrefs, sur le desktop américain uniquement, convergent : 65,1 % en août, 82,91 % le 29 septembre.
Un test complémentaire du consultant Chris Long, cité dans la même analyse, a relevé un AI Overview sur 93 des 100 marques d'envergure testées. Autrement dit, la page de résultats qui s'affiche quand on cherche votre nom ne vous appartient plus : elle est rédigée par un modèle, à partir de sources qu'il choisit seul.
Une précision méthodologique s'impose, et Semrush la formule explicitement : ces relevés mesurent la présence d'un AI Overview, pas le fait que la marque y soit citée correctement. Le chiffre dit l'exposition, pas la justesse. C'est précisément pour cela qu'un audit manuel reste indispensable.
Chez Digital-m, nous auditons régulièrement des sites de PME dont la fiche d'établissement, le site et l'annuaire professionnel racontent trois versions différentes de la même entreprise. Dans neuf cas sur dix, l'erreur que l'IA répète n'est pas une invention du modèle : c'est une incohérence que l'entreprise a elle-même laissée traîner en ligne.
Une erreur sur votre marque, vue par 8 recherches sur 10

- 82,91 % des requêtes de marque avec un AI Overview (Ahrefs, 29 sept. 2026)
- 44,2 % des citations ChatGPT viennent du premier tiers d'un article (étude Digital-m)
- 3,3 à 13,6 % d'erreurs même en résumé sourcé (Vectara HHEM, nov. 2025)
En septembre 2026, la réponse IA est devenue la norme sur les requêtes de marque
Part des requêtes de marque déclenchant un AI Overview dans Google, relevé quotidien DemandSphere, tous marchés et appareils, septembre 2026.
Ce que vous pouvez corriger
Ce que vous ne pouvez pas exiger
À retenir : la réponse IA est devenue le premier contact sur une requête de marque, mais aucun moteur n'offre de procédure de rectification du contenu généré. Votre seule prise réelle, ce sont les sources que les moteurs lisent, et leur cohérence entre elles.
Télécharger l'infographie (PNG)
D'où vient l'erreur ? Les quatre couches à diagnostiquer
Une fausse information IA provient toujours de l'une de ces quatre couches, et savoir laquelle détermine entièrement la suite. Testez la même question dans deux modes, avec et sans recherche web activée : si l'erreur disparaît quand le moteur va chercher sur le web, elle vient des poids du modèle. Si elle persiste, elle vient d'une source en ligne.
- Couche 1, les poids du modèle : l'information a été figée pendant l'entraînement. Vous n'avez aucun accès direct. Seul le réentraînement ou une mise à jour du modèle la corrigera, sur un horizon de plusieurs mois.
- Couche 2, l'index interrogé en direct : le moteur consulte le web pendant qu'il répond, un mécanisme appelé grounding (ancrage de la réponse dans des sources réelles). C'est la couche la plus réactive, et la plus intéressante pour vous.
- Couche 3, le graphe d'entités et les bases tierces : Google Business Profile, Bing Places, Wikidata, annuaires professionnels, bases sectorielles. Ce sont les référentiels que les moteurs recoupent pour construire votre fiche d'identité.
- Couche 4, votre propre site : une mention oubliée dans un vieil article, un PDF de 2023 encore en ligne, un pied de page jamais mis à jour. L'IA cite une page que vous avez cessé de lire il y a longtemps.
Le mécanisme de la couche 2 est détaillé dans notre article sur le grounding dans les LLM. Retenez l'essentiel : un moteur ancré lit votre page au moment de répondre. Modifiez la page, et la réponse peut changer dès la prochaine exploration.
Même sur cette couche la plus favorable, la perfection n'existe pas. Le classement HHEM de Vectara, mis en ligne le 19 novembre 2025 sur plus de 7 700 articles, mesure les erreurs introduites par les modèles alors même qu'on leur fournit le texte source et qu'on leur interdit d'utiliser leurs connaissances internes. Les taux allaient de 3,3 % pour Gemini 2.5 Flash Lite à 13,6 % pour Gemini 3 Pro, Mistral Large se situant autour de 4 à 5 %. Ces chiffres portent sur la génération de modèles de fin 2025 et servent d'ordre de grandeur, pas de classement actuel.
Le protocole en 5 étapes pour corriger une fausse information
Corriger une fausse information IA se fait en cinq étapes, dans cet ordre, et l'étape de documentation n'est pas optionnelle : sans preuve horodatée, vous ne saurez jamais si votre correction a fonctionné.
Étape 1 : documenter l'erreur avec précision
Capturez le prompt exact, le moteur, le modèle, la date et la réponse complète. Refaites le test en navigation privée, sans historique et sans mémoire activée, car une réponse personnalisée n'est pas une réponse publique. Testez la même question en français et en anglais : les écarts sont fréquents et révèlent souvent quelle source alimente l'erreur.
Étape 2 : identifier la couche responsable
Demandez explicitement ses sources au moteur, puis ouvrez-les. Perplexity et le mode recherche de ChatGPT les affichent, ce qui en fait d'excellents outils de diagnostic même si vous ciblez un autre assistant. Si aucune source ne contient l'affirmation, vous êtes sur une hallucination de couche 1. Si une source la contient, vous avez votre cible.
Étape 3 : réécrire la source canonique
Choisissez une page unique qui fait autorité sur l'information contestée, en général votre page À propos ou votre page de contact, et énoncez le fait correct de façon explicite, datée et autosuffisante. Une phrase comme « Depuis janvier 2026, le siège de la société est situé à Nantes » est citable telle quelle. Une phrase comme « nous avons déménagé récemment » ne l'est pas. Placez cette affirmation dans le premier tiers de la page : notre étude sur l'origine des citations de ChatGPT montre que 44,2 % d'entre elles en proviennent.
Étape 4 : pousser la correction dans les canaux officiels
Aucun moteur ne corrige sur demande, mais plusieurs acceptent des données structurées que vous contrôlez. Le tableau ci-dessous récapitule ce qui existe réellement, moteur par moteur, en octobre 2026.
| Moteur | Canal d'alimentation que vous contrôlez | Procédure de correction du texte généré |
|---|---|---|
| Google AI Overviews et AI Mode | Index Search, Google Business Profile, balisage schema.org | Aucune. La documentation officielle ne prévoit que des contrôles d'affichage (nosnippet, data-nosnippet, max-snippet, noindex) |
| ChatGPT | Index de recherche, flux produit commerce OpenAI (9 champs obligatoires dont la marque) | Aucune pour les faits d'entreprise. Un formulaire existe pour les données personnelles |
| Copilot | Index Bing, Bing Places | Aucune. Correction indirecte via la fiche Bing Places |
| Perplexity | Index propre, pages explorées en direct | Aucune. Signalement possible par le retour utilisateur |
| Gemini, Le Chat, Grok | Sources web explorées, référentiels tiers | Aucune procédure publique documentée |
La position de Google est sans ambiguïté dans sa documentation Search Central : il n'existe aucune exigence supplémentaire ni optimisation spéciale pour apparaître dans les AI Overviews, et les seuls leviers offerts aux éditeurs sont des contrôles d'affichage. Aucune case « signaler une erreur sur mon entreprise » n'est prévue. Côté OpenAI, la spécification publique du flux produit impose neuf champs obligatoires, dont brand, ce qui en fait le canal le plus direct pour un commerçant qui veut imposer ses propres données.
Étape 5 : vérifier, puis répéter
Reposez la même question à sept jours, puis à trente jours, et conservez les captures. Une correction qui tient sur un moteur et pas sur un autre est normale : chaque assistant rafraîchit son index à son propre rythme. Nos clients en accompagnement GEO reçoivent ce suivi sous forme de relevé mensuel, avec l'évolution des réponses prompt par prompt.
Ce que la loi vous permet d'exiger, et ce qu'elle ne permet pas
Le droit à la rectification du RGPD ne couvre que les données à caractère personnel, pas les faits concernant une personne morale. La CNIL est claire sur le périmètre : vous pouvez faire corriger une information inexacte vous concernant en tant que personne physique, et l'organisme doit répondre « dans les meilleurs délais et au plus tard dans un délai d'un mois », extensible à trois mois selon la complexité de la demande.
Concrètement, si ChatGPT attribue à votre dirigeant un parcours erroné, l'article 16 du RGPD s'applique. Si le même moteur se trompe sur le chiffre d'affaires de la société ou sur ses certifications, vous sortez du champ du droit à la rectification et il vous reste le droit commun, dénigrement ou pratique commerciale trompeuse selon les cas.
Cette limite n'est pas théorique. L'ONG autrichienne noyb a déposé le 29 avril 2024 une plainte auprès de l'autorité autrichienne de protection des données, invoquant les articles 5, 15 et 16 du RGPD, précisément parce qu'OpenAI reconnaissait pouvoir filtrer ou bloquer des données sur certains prompts sans pouvoir les corriger dans le système sous-jacent. L'entreprise qualifiait alors l'exactitude factuelle des grands modèles de langage de « domaine de recherche active ». À notre connaissance, aucune décision définitive n'a été rendue sur cette plainte à la date de publication de cet article.
Retenez la nuance utile face à une fausse information IA : vous obtiendrez plus vite un blocage qu'une rectification. Et un blocage laisse un vide que vos concurrents rempliront.
Combien de temps avant que l'IA se corrige ?
Aucun délai n'est garanti pour la disparition d'une fausse information IA, et aucun éditeur ne publie d'engagement de service sur ce point. L'ordre de grandeur dépend entièrement de la couche visée, et il est honnête de le dire plutôt que de promettre des résultats en quarante-huit heures.
- Couche 2, moteur ancré sur le web : de quelques jours à quelques semaines, le temps que la page modifiée soit réexplorée et que les caches se vident.
- Couche 3, référentiels tiers : de une à plusieurs semaines pour une fiche d'établissement validée, davantage pour un annuaire sectoriel peu réactif.
- Couche 1, poids du modèle : plusieurs mois, et uniquement à l'occasion d'une nouvelle version. Aucune action de votre part n'accélère ce délai.
Sur la durée, la consolidation d'entité produit des effets mesurables. Une étude de cas publiée par Ray Martinez dans Search Engine Land le 18 septembre 2026 documente le cas d'un établissement d'enseignement dont les citations IA sont passées de 24 000 en janvier 2026 à 42 000 en juillet, soit 75 % de hausse en six mois, après un travail de normalisation du balisage : durées exprimées en ISO 8601, seuils d'admission chiffrés, dates de rentrée standardisées. Précision importante, il s'agit d'un cas client rapporté par l'agence qui a mené la mission, non d'une mesure validée par un tiers indépendant.
Les cinq réflexes qui aggravent le problème
Certaines réactions intuitives empirent la situation. Nous les voyons revenir dans presque chaque audit de fausses informations IA, et elles coûtent du temps et parfois des positions.
- Corriger l'IA dans la conversation : dire à ChatGPT ou à Gemini « non, c'est faux, voici la bonne information » ne change rien pour les autres utilisateurs. La mémoire est individuelle, pas publique, comme nous l'expliquons à propos du fonctionnement de la mémoire des LLM.
- Bourrer la page de répétitions : répéter quinze fois l'information correcte ne la rend pas plus crédible. Une affirmation claire, datée et cohérente avec vos autres sources pèse infiniment plus.
- Supprimer la page fautive : effacer la source sans la remplacer laisse le moteur se rabattre sur une source tierce, souvent plus ancienne. Mieux vaut corriger la page et conserver son URL.
- Bloquer les robots des IA : interdire GPTBot ou ClaudeBot vous rend invisible, pas exact. Le moteur continuera de parler de vous à partir de sources que vous ne contrôlez pas.
- Traiter un seul moteur : corriger pour ChatGPT en ignorant Gemini, Perplexity, Copilot et Le Chat revient à nettoyer une seule vitre. Les sources diffèrent, les délais aussi.
Mettre en place une veille pour ne plus subir
La seule protection durable contre les fausses informations IA est une veille régulière sur un jeu de prompts fixe, relevée au même rythme chaque mois. Construisez une liste de dix à vingt questions qu'un prospect poserait réellement : « que fait l'entreprise X », « quels sont les tarifs de X », « X est-il fiable », « meilleur [votre métier] à [votre ville] ».
Posez-les à au moins quatre moteurs, consignez les réponses dans un tableau daté, et surveillez trois choses : votre présence, l'exactitude des faits cités, et les sources mobilisées. Côté mesure d'audience, vérifiez aussi la qualité de votre suivi, car les canaux par défaut sous-estiment souvent le trafic issu des assistants, un point que nous traitons dans notre article sur les mentions de marque comme premier levier GEO.
Pour les équipes qui veulent internaliser cette routine, notre formation GEO certifiée Qualiopi consacre un module entier au diagnostic et à la correction des erreurs d'entité, avec les grilles de relevé que nous utilisons en mission.
Ce qu'il faut retenir
Les fausses informations IA sur votre entreprise ne se corrigent pas en écrivant au moteur, parce qu'aucun moteur ne propose cette procédure. Elles se corrigent en identifiant la couche d'où vient l'erreur, puis en réparant la source que le moteur lit. Avec 82,91 % des requêtes de marque désormais coiffées d'un résumé IA, l'enjeu n'est plus de savoir si vos prospects liront une réponse générée, mais laquelle.
Trois réflexes suffisent à prendre l'avantage : une page canonique qui énonce vos faits de façon datée et explicite, des référentiels tiers parfaitement cohérents entre eux, et un relevé mensuel sur un jeu de prompts fixe. Le droit, lui, ne vous aidera que sur les données personnelles, et seulement pour obtenir un blocage plus sûrement qu'une rectification.
Vous voulez savoir ce que les moteurs génératifs racontent aujourd'hui sur votre entreprise ? Demandez-nous un audit de réputation IA : nous relevons vos prompts stratégiques sur les principaux assistants et vous remettons le plan de correction, couche par couche.
Avez-vous déjà vérifié ce que ChatGPT ou Gemini répondent quand on cherche le nom de votre entreprise ? Dites-le nous en commentaire !Sources et références
- Semrush - Google AI Overviews now appear for most major brands (6 octobre 2026)
- Google Search Central - AI features and your website (documentation officielle, consultée le 7 octobre 2026)
- noyb - ChatGPT provides false information about people, and OpenAI can't correct it (29 avril 2024)
- CNIL - Le droit de rectification : corriger vos informations (consulté le 7 octobre 2026)
- Vectara - Introducing the next generation of Vectara's Hallucination Leaderboard (19 novembre 2025)
- Search Engine Land - Schema for AI search: Turning entity gaps into organic growth, Ray Martinez (18 septembre 2026)
- OpenAI - Commerce product feed specification, Products (consulté le 7 octobre 2026)
- OpenAI Help Center - Right to be forgotten and personal data removal from ChatGPT (consulté le 7 octobre 2026)
- Growth Memo - The Science of How AI Pays Attention, Kevin Indig
Questions fréquentes sur les fausses informations IA
Peut-on obliger OpenAI ou Google à corriger une information sur mon entreprise ?
Non pour les faits concernant la société. Le droit à la rectification de l'article 16 du RGPD ne couvre que les données à caractère personnel, donc un dirigeant à titre individuel, pas une personne morale. La documentation officielle de Google ne prévoit aucune procédure de correction du texte généré, seulement des contrôles d'affichage comme nosnippet ou noindex. Pour une donnée personnelle, en revanche, l'organisme doit répondre dans un délai d'un mois, extensible à trois mois.
Comment savoir si l'erreur vient du modèle ou d'une page de mon site ?
Posez la même question deux fois, une fois avec la recherche web activée et une fois sans. Si l'erreur disparaît quand le moteur consulte le web, elle est inscrite dans les poids du modèle et vous ne pouvez pas l'atteindre directement. Si elle persiste, demandez les sources au moteur et ouvrez-les : Perplexity et le mode recherche de ChatGPT les affichent systématiquement, ce qui en fait de bons outils de diagnostic.
Combien de temps faut-il pour qu'une correction soit prise en compte ?
Aucun éditeur ne publie d'engagement de délai. En pratique, comptez quelques jours à quelques semaines pour un moteur qui consulte le web en direct, une à plusieurs semaines pour une fiche d'établissement, et plusieurs mois pour une information inscrite dans les poids du modèle, qui ne bougera qu'avec une nouvelle version. Reposez systématiquement la même question à sept puis trente jours pour mesurer l'effet.
Faut-il bloquer les robots des IA pour éviter les erreurs ?
Non, c'est contre-productif. Bloquer GPTBot, ClaudeBot ou PerplexityBot dans votre robots.txt empêche les moteurs de lire vos informations exactes, mais ne les empêche pas de parler de vous à partir d'annuaires, d'avis clients ou d'articles de presse que vous ne maîtrisez pas. Vous perdez le contrôle de la source sans gagner en exactitude.
Mon entreprise est confondue avec une homonyme, que faire en priorité ?
Travaillez la désambiguïsation de votre entité. Associez systématiquement votre nom commercial à trois marqueurs stables et uniques : votre numéro SIREN, votre ville, et votre secteur d'activité formulé de la même manière partout. Reprenez cette triade à l'identique sur votre page À propos, votre fiche Google Business Profile, votre fiche Bing Places et vos profils d'annuaires, et déclarez-la en balisage schema.org avec les propriétés sameAs pointant vers vos profils officiels.