
LLM à diffusion : l'IA qui n'écrit plus mot à mot
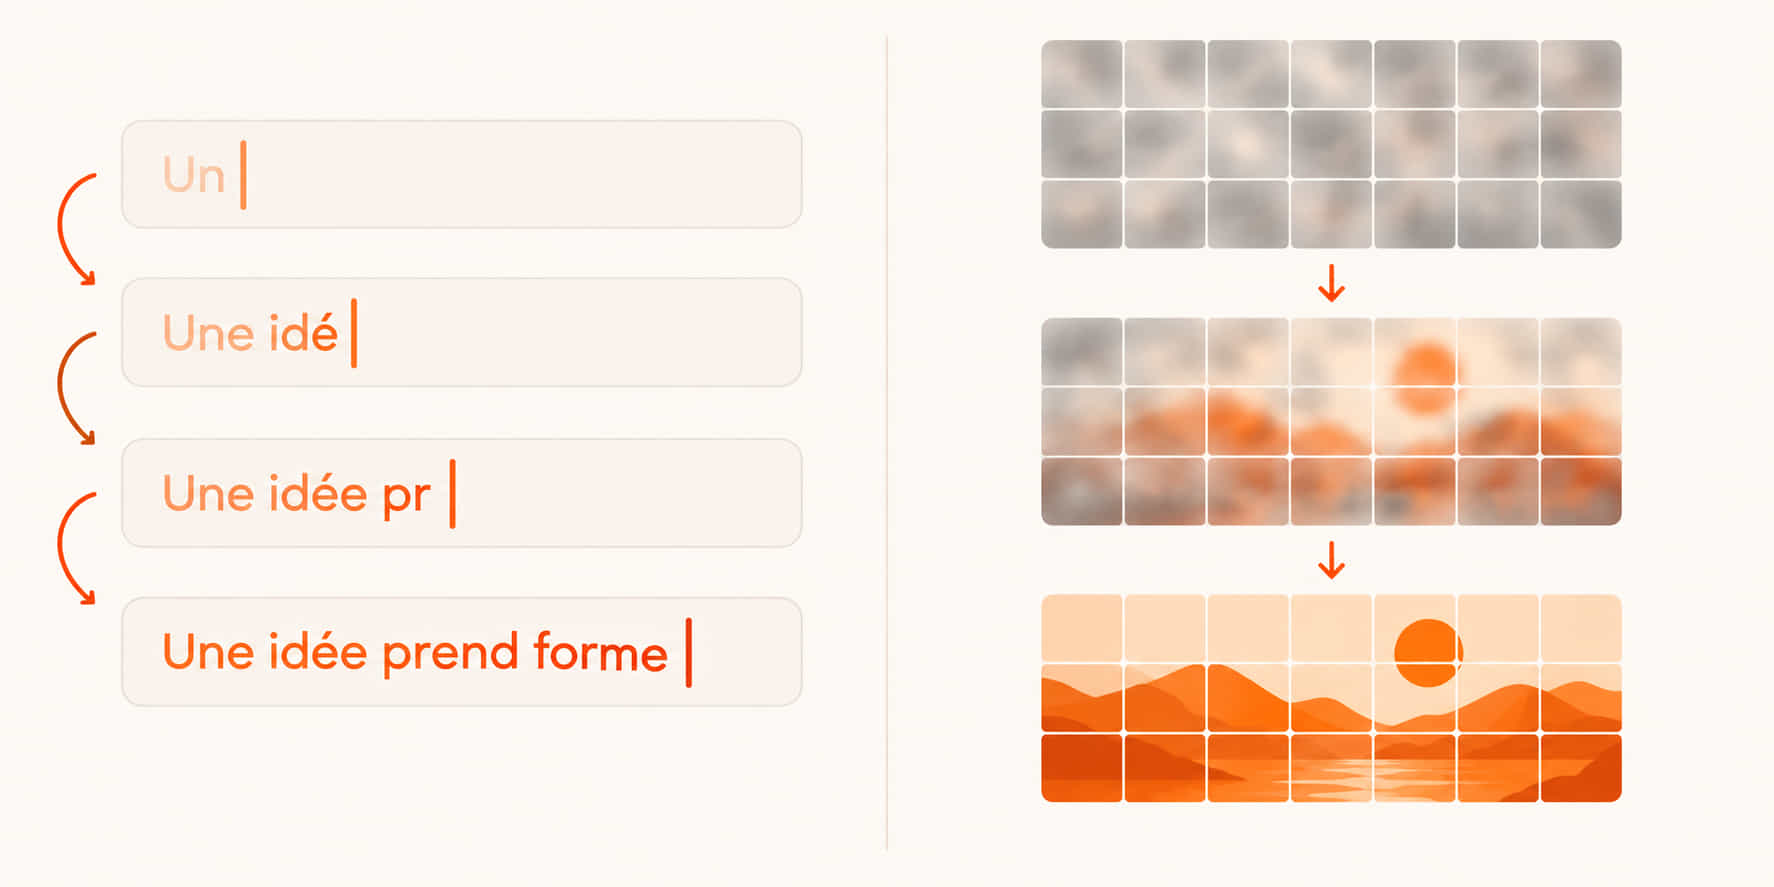
1 107 tokens par seconde. C'est la vitesse revendiquée par Mercury 2.5, lancé le 9 septembre 2026 par Inception. À côté, la médiane du marché des modèles de langage classiques plafonne à 70 tokens par seconde selon Artificial Analysis. Le secret n'est pas une puce miracle, c'est une autre façon d'écrire. Un LLM à diffusion ne produit pas son texte mot après mot : il part d'un brouillon entièrement masqué et le raffine en quelques passes, comme un photographe révèle une image. Google a publié DiffusionGemma en open-weights le 10 juin 2026, Inception commercialise son API, la recherche accumule les modèles. Voici ce que cette architecture change vraiment, où elle s'arrête, et pourquoi elle mérite dix minutes de votre attention.
-
- Dernière modification
24 septembre 2026 - 8 minutes de lecture
Un LLM à diffusion, c'est quoi exactement ?
Un LLM à diffusion est un modèle de langage qui génère son texte en parallèle, par raffinements successifs, au lieu de le produire un mot après l'autre. Il démarre avec une séquence entièrement masquée, des cases vides notées [MASK], puis remplit et corrige ces cases en quelques passes de calcul jusqu'à obtenir un texte cohérent. Le nom vient des modèles de diffusion qui génèrent des images : eux partent d'un bruit aléatoire et le « débruitent » progressivement jusqu'à faire apparaître une photo.
Le vocabulaire technique parle de débruitage itératif (« iterative denoising » en anglais) : chaque passe du modèle réduit le désordre de la séquence et rapproche le brouillon du texte final. L'article de référence sur le sujet, A Survey on Diffusion Language Models publié sur arXiv, décrit deux phases : une phase d'apprentissage où l'on corrompt volontairement des phrases en masquant des mots, et une phase de génération où le modèle apprend à remonter le courant.
- Étape 1, le masquage : à l'entraînement, on cache une partie des mots d'une phrase correcte et le modèle apprend à deviner ce qui manque, en s'appuyant sur ce qui se trouve avant ET après le trou.
- Étape 2, le débruitage : à l'usage, le modèle reçoit une séquence 100 % masquée et propose une première version complète, souvent bancale.
- Étape 3, le raffinement : il repasse plusieurs fois sur sa propre production, garde les tokens dont il est sûr et redevine les autres, jusqu'à stabilisation.
Autorégressif contre diffusion : deux façons d'écrire une phrase
La différence tient dans une image très simple. Un modèle autorégressif, c'est-à-dire la quasi-totalité des LLM que vous utilisez aujourd'hui (GPT-5.6, Gemini 3, Claude, Mistral, Llama, Qwen, DeepSeek), écrit « a », puis « ab », puis « abc » : chaque token dépend de celui d'avant, la génération est séquentielle par construction. Un LLM à diffusion écrit « xycz », puis « aycd », puis « abcd » : la séquence entière existe dès la première passe et se corrige en bloc.
Cette différence a une conséquence majeure sur l'attention, le mécanisme par lequel un modèle décide sur quels mots se concentrer. Dans un modèle autorégressif, un token ne voit que le passé. Dans un LLM à diffusion, l'attention est bidirectionnelle : chaque token voit tous les autres, y compris ceux placés après lui. Google indique que DiffusionGemma génère 256 tokens en parallèle à chaque passe avant, et que chacun peut « regarder » les 255 autres. Si la notion de découpage du texte en unités vous échappe encore, notre article sur la façon dont les tokens LLM découpent et facturent le texte pose les bases, et celui consacré à l'architecture transformeur explique d'où vient ce mécanisme d'attention.
Concrètement, l'attention bidirectionnelle débloque des usages que l'autorégressif traite mal : compléter un trou au milieu d'un fichier de code, réécrire un paragraphe sans régénérer tout ce qui suit, ou résoudre un problème dont la fin contraint le début. Google cite d'ailleurs la résolution de grilles de Sudoku comme démonstration.
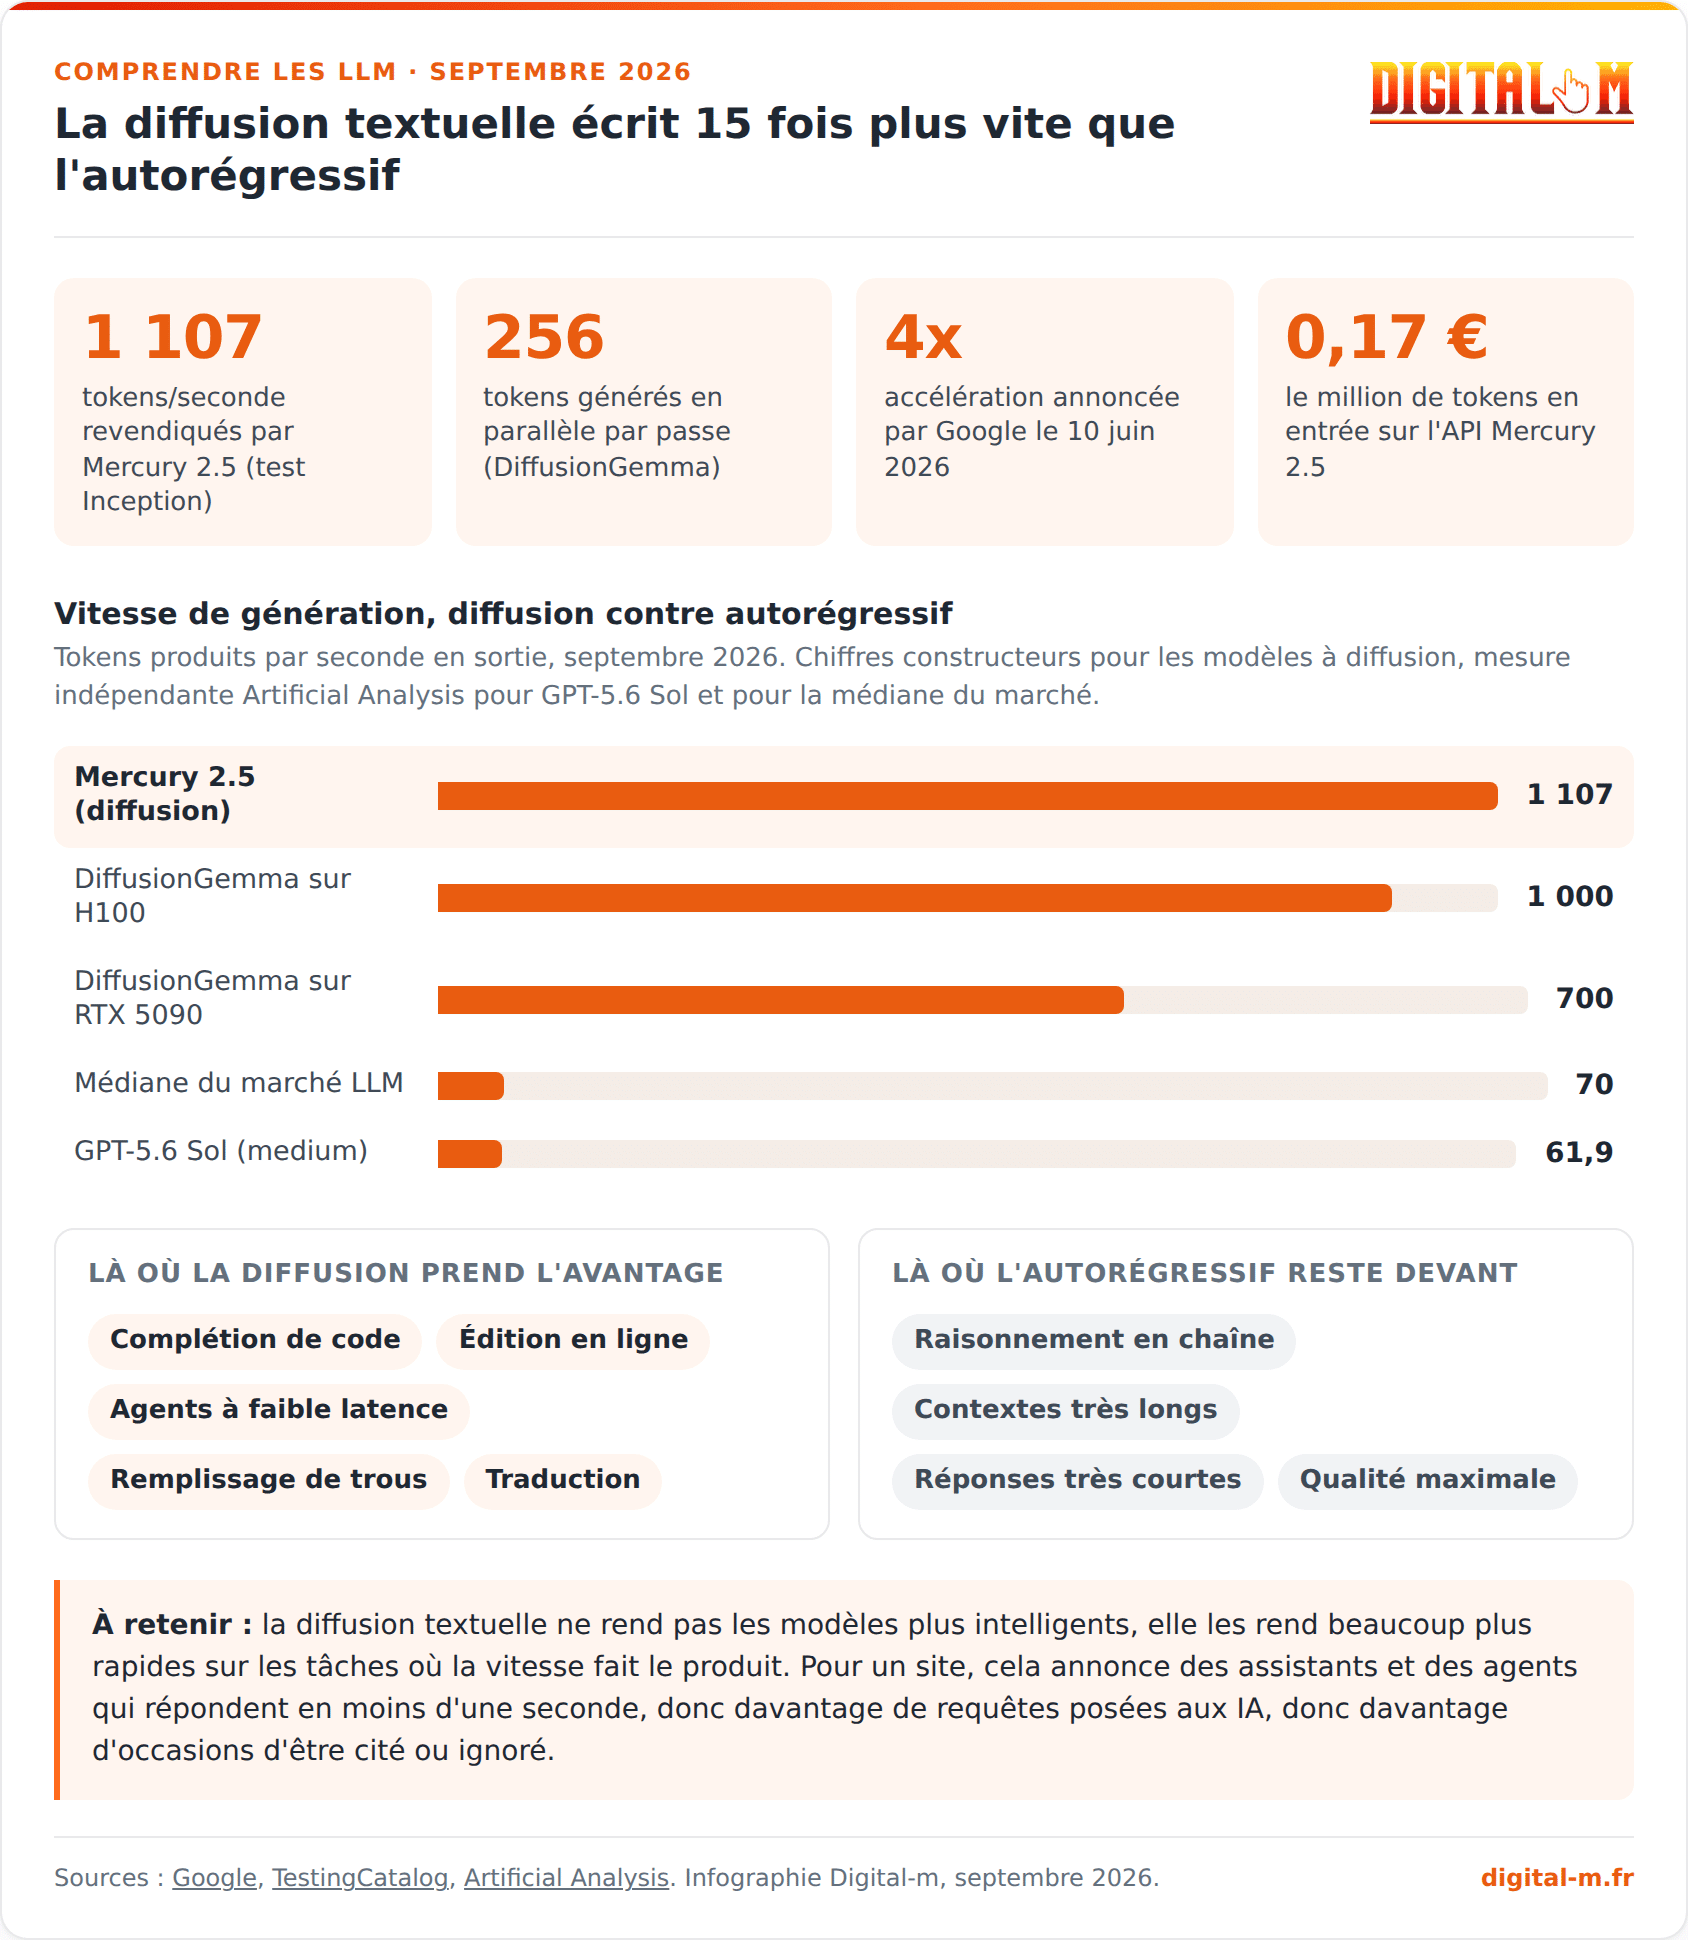
La diffusion textuelle écrit 15 fois plus vite que l'autorégressif

- 1 107 tokens/seconde revendiqués par Mercury 2.5 (test Inception)
- 256 tokens générés en parallèle par passe (DiffusionGemma)
- 4x accélération annoncée par Google le 10 juin 2026
- 0,17 € le million de tokens en entrée sur l'API Mercury 2.5
Vitesse de génération, diffusion contre autorégressif
Tokens produits par seconde en sortie, septembre 2026. Chiffres constructeurs pour les modèles à diffusion, mesure indépendante Artificial Analysis pour GPT-5.6 Sol et pour la médiane du marché.
Là où la diffusion prend l'avantage
Là où l'autorégressif reste devant
À retenir : la diffusion textuelle ne rend pas les modèles plus intelligents, elle les rend beaucoup plus rapides sur les tâches où la vitesse fait le produit. Pour un site, cela annonce des assistants et des agents qui répondent en moins d'une seconde, donc davantage de requêtes posées aux IA, donc davantage d'occasions d'être cité ou ignoré.
Télécharger l'infographie (PNG)
Pourquoi c'est beaucoup plus rapide, et ce que ça coûte
Un LLM à diffusion va plus vite parce qu'il produit plusieurs dizaines de tokens par passe de calcul, là où un modèle autorégressif en produit un seul. La fiche technique de DiffusionGemma annonce 15 à 20 tokens par passe avant, ce qui permet de dépasser 1 000 tokens par seconde sur un GPU NVIDIA H100 et plus de 700 tokens par seconde sur une carte grand public RTX 5090. Google parle d'une accélération allant jusqu'à 4 fois par rapport à ses propres modèles autorégressifs.
Pour situer l'ordre de grandeur, Artificial Analysis mesure 61,9 tokens par seconde en sortie pour GPT-5.6 Sol en effort moyen, et place la médiane du marché à 70 tokens par seconde. Un facteur 15 à 18 sépare donc les deux familles sur ce seul critère. Attention toutefois : les chiffres de vitesse des modèles à diffusion sont pour l'essentiel des tests maison publiés par les éditeurs, non vérifiés par un tiers indépendant, et mesurés sur du matériel choisi par eux.
Côté tarif, Inception affiche Mercury 2.5 à 0,17 € le million de tokens en entrée et 0,66 € en sortie (0,20 et 0,75 dollars, convertis au taux du 22 septembre 2026, 1 euro pour 1,1448 dollar), avec une promotion de lancement à 80 % de remise qui descend à 0,03 € et 0,13 €. L'entreprise revendique des gains clients spectaculaires : chez Augment Code, une latence réduite de 82 % (de 150 secondes à 27 secondes) et un coût divisé par dix ; chez OpenCall, une latence médiane de 170 millisecondes. Ces retours proviennent d'Inception et de ses clients, pas d'un audit externe.
Chez Digital-m, nous auditons régulièrement des assistants installés sur des sites de PME, et le constat est presque toujours le même : ce n'est pas la qualité de la réponse qui fait fuir le visiteur, c'est le temps d'attente. Un agent conversationnel qui met huit secondes à démarrer perd son utilisateur avant d'avoir répondu. C'est précisément le problème que la diffusion attaque.
DiffusionGemma, Mercury, LLaDA : où en est-on en septembre 2026 ?
Trois familles coexistent aujourd'hui : un modèle ouvert signé Google, une offre commerciale signée Inception, et une base de modèles académiques. Aucune ne domine encore le marché, mais l'écosystème est sorti du laboratoire en moins de deux ans.
DiffusionGemma, le pari open-weights de Google
Annoncé le 10 juin 2026, DiffusionGemma est présenté par Google comme le premier modèle de diffusion textuelle à poids ouverts d'envergure, publié sous licence Apache 2.0 et téléchargeable sur Hugging Face, Kaggle et Vertex AI. C'est un modèle Mixture of Experts de 26 milliards de paramètres au total dont seulement 3,8 milliards sont activés à chaque inférence, une technique que nous détaillons dans notre article sur l'architecture Mixture of Experts. Il accepte texte, image et vidéo en entrée, avec une fenêtre de contexte pouvant atteindre 256 000 tokens. Google le qualifie explicitement d'expérimental et le destine aux chercheurs et développeurs, pas aux applications de production exigeant la meilleure qualité possible. Sur les benchmarks publiés : 77,6 % sur MMLU Pro, 73,2 % sur GPQA Diamond, 69,1 % sur LiveCodeBench v6. La notion de poids ouverts et ses nuances juridiques sont détaillées dans notre dossier sur les LLM open-weights et le vrai sens du mot open source.
Mercury 2.5, la vitesse vendue comme un produit
Inception a lancé Mercury 2.5 le 9 septembre 2026, avec 1 107 tokens par seconde revendiqués, une fenêtre de contexte de 260 000 tokens et une intelligence annoncée en hausse de 40 % par rapport à Mercury 2. L'éditeur positionne la qualité du modèle au niveau de GPT-5.6 Luna en raisonnement bas, de Gemini 3.5 Flash-Lite et de Claude Haiku 4.5, sans publier le détail des benchmarks. La cible est claire : les agents, la complétion de code et la voix, c'est-à-dire tous les usages où chaque milliseconde compte.
LLaDA et Dream, les modèles venus de la recherche
LLaDA-8B et Dream-7B sont les deux références académiques les plus citées. Le premier a été entraîné intégralement en diffusion et affiche des performances comparables à celles d'un LLaMA 3 8B autorégressif ; le second a été initialisé à partir d'un modèle autorégressif existant, une astuce qui réduit fortement le coût d'entraînement. ByteDance a également publié Seed Diffusion. Ces modèles ne visent pas le grand public, mais ils prouvent que l'approche tient debout à taille égale.
Ce que la diffusion ne sait pas encore bien faire
La diffusion textuelle paie sa vitesse sur trois terrains précis : le raisonnement long, les contextes étendus et les réponses très courtes. Sur le benchmark de mathématiques AIME, DiffusionGemma obtient 69,1 % contre 88,3 % pour Gemma 4, son cousin autorégressif de génération équivalente. L'écart n'est pas anecdotique, il dit exactement où se situe le compromis.
- Le raisonnement pas à pas : la chaîne de pensée, qui consiste à laisser le modèle dérouler son raisonnement token par token, s'accommode mal d'une génération par blocs qui se corrige elle-même. C'est un sujet de recherche ouvert.
- Les contextes très longs : un modèle à diffusion profite difficilement du cache clé-valeur, ce mécanisme qui évite de recalculer l'attention à chaque nouveau token. Il recalcule beaucoup, donc il coûte cher quand le contexte grossit.
- Les réponses de deux mots : la diffusion exécute toutes ses passes quelle que soit la longueur demandée. Pour répondre « oui », un modèle autorégressif reste plus économique.
- La fraîcheur des données : la coupure d'entraînement de DiffusionGemma est fixée à janvier 2025, ce qui limite ses connaissances factuelles sans recours à une source externe.
Un point technique intéressant : la diffusion permet d'arbitrer entre qualité et vitesse à la demande. Arrêter le débruitage plus tôt donne un texte moins abouti mais disponible immédiatement. Ce curseur n'existe pas dans un modèle autorégressif, où le seul réglage comparable reste la température qui pilote le choix des mots.
Faut-il s'en servir aujourd'hui dans une PME ?
Pour la très grande majorité des entreprises, la réponse en septembre 2026 est non, sauf sur trois cas d'usage précis. La diffusion n'est pas un remplacement de ChatGPT ou de Gemini pour rédiger, analyser ou décider : elle est un accélérateur pour des briques applicatives bien identifiées.
- L'agent vocal : un standard téléphonique automatisé où une latence supérieure à une seconde casse la conversation.
- La complétion de code dans l'éditeur : suggestion instantanée pendant la frappe, sur des blocs courts et bien contraints.
- La transformation de masse : traduire, reformater ou résumer plusieurs milliers de fiches produits, où le prix au million de tokens et le débit priment sur la finesse.
Le bon réflexe est de tester avant d'industrialiser. DiffusionGemma étant sous licence Apache 2.0, une PME peut l'évaluer sur son propre matériel sans engagement contractuel, et Mercury dispose d'une API compatible avec les usages courants. Notre agence GEO accompagne ce type d'arbitrage en partant d'un chiffrage réel du coût par requête plutôt que d'une promesse commerciale.
Ce que ça change pour votre visibilité dans les moteurs génératifs
Un LLM à diffusion ne change rien à la façon dont votre contenu est sélectionné, mais il change beaucoup le volume de requêtes posées aux IA. Quand une réponse coûte dix fois moins cher et arrive quinze fois plus vite, les éditeurs multiplient les appels au modèle : reformulations, sous-questions, vérifications croisées. C'est exactement le mécanisme du query fan-out, où une seule question utilisateur déclenche une dizaine de recherches en coulisses.
La conséquence est directe : plus il y a de requêtes internes, plus il y a d'occasions pour votre page d'être retenue comme source, et plus la structure de votre contenu compte. Notre étude interne montre que 44,2 % des citations de ChatGPT proviennent du premier tiers d'un article. Un moteur qui interroge davantage de sources, plus vite, avec des passes plus courtes, aura encore moins de patience pour une information enterrée en conclusion.
Trois réflexes restent valables quel que soit le type de modèle en face : placer la définition et le chiffre clé haut dans la page, écrire des paragraphes autonomes et compréhensibles hors contexte, et nommer explicitement les entités (modèles, versions, dates, entreprises). Ce sont les fondamentaux que nous transmettons dans notre formation GEO certifiée Qualiopi.
Ce qu'il faut retenir
Un LLM à diffusion génère son texte en parallèle par raffinements successifs, au lieu de l'écrire mot après mot. Cela lui donne un avantage de vitesse considérable : plus de 1 000 tokens par seconde pour DiffusionGemma sur H100, 1 107 revendiqués pour Mercury 2.5, contre une médiane de marché à 70 tokens par seconde. En échange, il perd du terrain sur le raisonnement long, les contextes étendus et les réponses très courtes, et l'écart de 19 points sur AIME entre DiffusionGemma et Gemma 4 le montre noir sur blanc.
Pour une PME, l'intérêt immédiat se concentre sur les agents vocaux, la complétion de code et les traitements de masse. Pour votre visibilité, la vraie nouvelle n'est pas l'architecture mais son effet de bord : des moteurs génératifs qui interrogent plus de sources, plus souvent, et qui récompensent encore davantage les contenus clairs, structurés et citables dès les premiers paragraphes.
Vous voulez savoir si vos pages sont réellement citables par ChatGPT, Gemini, Perplexity ou Mistral ? Demandez un audit GEO personnalisé à notre équipe : nous analysons votre contenu, vos citations existantes et les corrections à prioriser.
Et vous, avez-vous déjà testé un modèle à diffusion sur un cas concret ? Dites-le nous en commentaire !Sources et références
- Google - DiffusionGemma : 4x faster text generation (10 juin 2026)
- Google AI for Developers - DiffusionGemma model card (2026)
- Google DeepMind - DiffusionGemma, page modèle (2026)
- TestingCatalog - Inception launches Mercury 2.5 at 1,107 tokens per second (9 septembre 2026)
- Inception - When Every Millisecond Matters (2026)
- Artificial Analysis - GPT-5.6 Sol (medium), Intelligence, Performance & Price Analysis (septembre 2026)
- arXiv - A Survey on Diffusion Language Models (2026)
- Sean Goedecke - Strengths and limitations of diffusion language models (2026)
- arXiv - Dream 7B : Diffusion Large Language Models (2026)
Questions fréquentes sur les LLM à diffusion
Quelle est la différence entre un LLM à diffusion et un LLM classique ?
Un LLM classique est autorégressif : il écrit un token après l'autre, chacun dépendant du précédent. Un LLM à diffusion produit toute la séquence d'un coup sous forme masquée, puis la raffine en plusieurs passes. Résultat : la génération est parallèle et beaucoup plus rapide, mais le modèle voit aussi ce qui se trouve après chaque mot, ce qui facilite l'édition et la complétion de code.
Les modèles à diffusion sont-ils vraiment plus rapides ?
Oui, sur les mesures publiées. DiffusionGemma dépasse 1 000 tokens par seconde sur un GPU NVIDIA H100 selon Google, et Mercury 2.5 annonce 1 107 tokens par seconde, contre une médiane de marché à 70 tokens par seconde mesurée par Artificial Analysis. Ces chiffres de vitesse sont pour l'essentiel des tests réalisés par les éditeurs eux-mêmes, non vérifiés par un tiers indépendant.
Peut-on utiliser un LLM à diffusion gratuitement ?
Oui. DiffusionGemma est publié par Google sous licence Apache 2.0 et téléchargeable sur Hugging Face, Kaggle et Vertex AI : vous pouvez le faire tourner sur votre propre matériel sans payer de licence. Côté API commerciale, Mercury 2.5 est facturé 0,17 € le million de tokens en entrée et 0,66 € en sortie, avec une remise de lancement de 80 %.
Un LLM à diffusion hallucine-t-il moins ?
Rien ne le confirme à ce jour. La diffusion change la façon dont le texte est produit, pas la façon dont les connaissances sont stockées. La fiche modèle de DiffusionGemma indique d'ailleurs que le modèle peut générer des informations factuellement incorrectes, comme n'importe quel modèle de langage. La seule parade reste l'ancrage sur des sources externes vérifiables.
La diffusion va-t-elle remplacer les modèles autorégressifs ?
Peu probable à court terme. Google qualifie lui-même DiffusionGemma d'expérimental et le réserve aux chercheurs et développeurs. Sur le raisonnement complexe, l'écart reste net : 69,1 % contre 88,3 % sur le benchmark AIME face à Gemma 4. Le scénario le plus crédible est une coexistence, la diffusion prenant les tâches où la latence fait le produit et l'autorégressif gardant le raisonnement.