
Date de coupure des LLM : que sait vraiment votre IA ?
Demandez à GPT-6 Astra ce qui s'est passé hier. Il n'en sait rien. Sa date de coupure est fixée au 30 avril 2026, soit quatre mois avant sa mise à disposition publique du 3 septembre 2026. Tous les grands modèles de langage fonctionnent ainsi : leurs connaissances s'arrêtent net à une date, puis le modèle est figé. Entre cette date et le jour où vous l'interrogez, il peut s'écouler quatre mois chez OpenAI, et jusqu'à seize mois sur certains modèles Gemini. Comprendre ce mécanisme change deux choses très concrètes : la confiance que vous accordez aux réponses de l'IA, et la façon dont votre entreprise peut espérer y être citée. Voici ce que recouvre cette date, pourquoi les chiffres publiés se contredisent, et comment la vérifier vous-même en quelques minutes.
-
- Dernière modification
9 octobre 2026 - 9 minutes de lecture
La date de coupure, c'est quoi exactement ?
La date de coupure (en anglais knowledge cutoff, littéralement « coupure de connaissance ») est la date limite des données sur lesquelles un modèle de langage a été entraîné. Tout ce qui a été publié après n'existe pas pour lui, sauf si on le lui fournit par un autre moyen.
Concrètement, l'entraînement d'un modèle consiste à lui faire ingérer un très grand corpus de textes à un moment donné, puis à figer ses paramètres. Après cette opération, le modèle n'apprend plus rien par lui-même. Il ne lit pas le web en continu. Il ne se met pas à jour la nuit. Il reste exactement dans l'état où l'entraînement l'a laissé, jusqu'à ce que son éditeur publie une nouvelle version.
Attention à ne pas confondre trois dates que l'on mélange souvent :
- La date de coupure : la fin des données d'entraînement. C'est la frontière de ce que le modèle « sait » spontanément.
- La date de sortie : le jour où le modèle devient accessible au public. Elle est toujours postérieure, parfois de plus d'un an.
- La date du jour : celle que le modèle affiche s'il la connaît, généralement injectée dans son prompt système par l'application qui l'héberge.
Anthropic va plus loin que ses concurrents sur ce point et publie deux dates distinctes pour ses modèles Claude : une date de coupure des données d'entraînement, et une date de coupure des connaissances dites fiables, toujours antérieure ou égale. Pour Claude Sonnet 4.6, par exemple, la documentation annonce des données jusqu'en janvier 2026 mais des connaissances solides seulement jusqu'en août 2025. La différence n'est pas cosmétique : elle reconnaît que les derniers mois du corpus sont moins densément couverts, donc moins fiables.
Horizon GEO • La newsletter
Comprendre les LLM, sans jargon
Chaque semaine, un mécanisme des IA expliqué simplement (contexte, embeddings, raisonnement…) et l’actu des modèles qui compte.
1 e-mail par semaine • Désinscription en 1 clic
Pourquoi un LLM n'apprend pas en continu
Un modèle de langage n'apprend pas en continu parce que son entraînement est une opération industrielle, longue et coûteuse, impossible à relancer chaque jour. Mistral a par exemple entraîné son modèle Mistral Large 4 depuis zéro sur 3 800 cartes graphiques NVIDIA Grace Blackwell, dans ses centres de données européens. On ne refait pas cela pour intégrer l'actualité du matin.
À cela s'ajoutent trois contraintes techniques que les éditeurs évoquent rarement en façade :
- La collecte prend du temps : il faut aspirer, nettoyer, dédupliquer et filtrer le corpus avant même de lancer l'entraînement. Les données les plus récentes sont donc toujours les moins bien traitées.
- L'alignement vient après : une fois le modèle brut obtenu, il reste les phases de réglage et d'alignement sur des valeurs humaines, type RLHF ou DPO, qui ajoutent plusieurs semaines.
- Les tests de sécurité allongent le délai : évaluations internes, red teaming (mise à l'épreuve par des équipes qui cherchent à faire dérailler le modèle), conformité réglementaire. Autant de temps pendant lequel la coupure recule dans le passé.
Résultat : au moment où vous ouvrez une conversation, le modèle le plus récent du marché a déjà plusieurs mois de retard sur le monde réel, et sa date de coupure recule un peu plus chaque jour. Cette latence structurelle n'a rien à voir avec la mémoire conversationnelle des LLM, qui porte sur ce que l'outil retient de vos échanges, et non sur ce qu'il a appris pendant son entraînement.
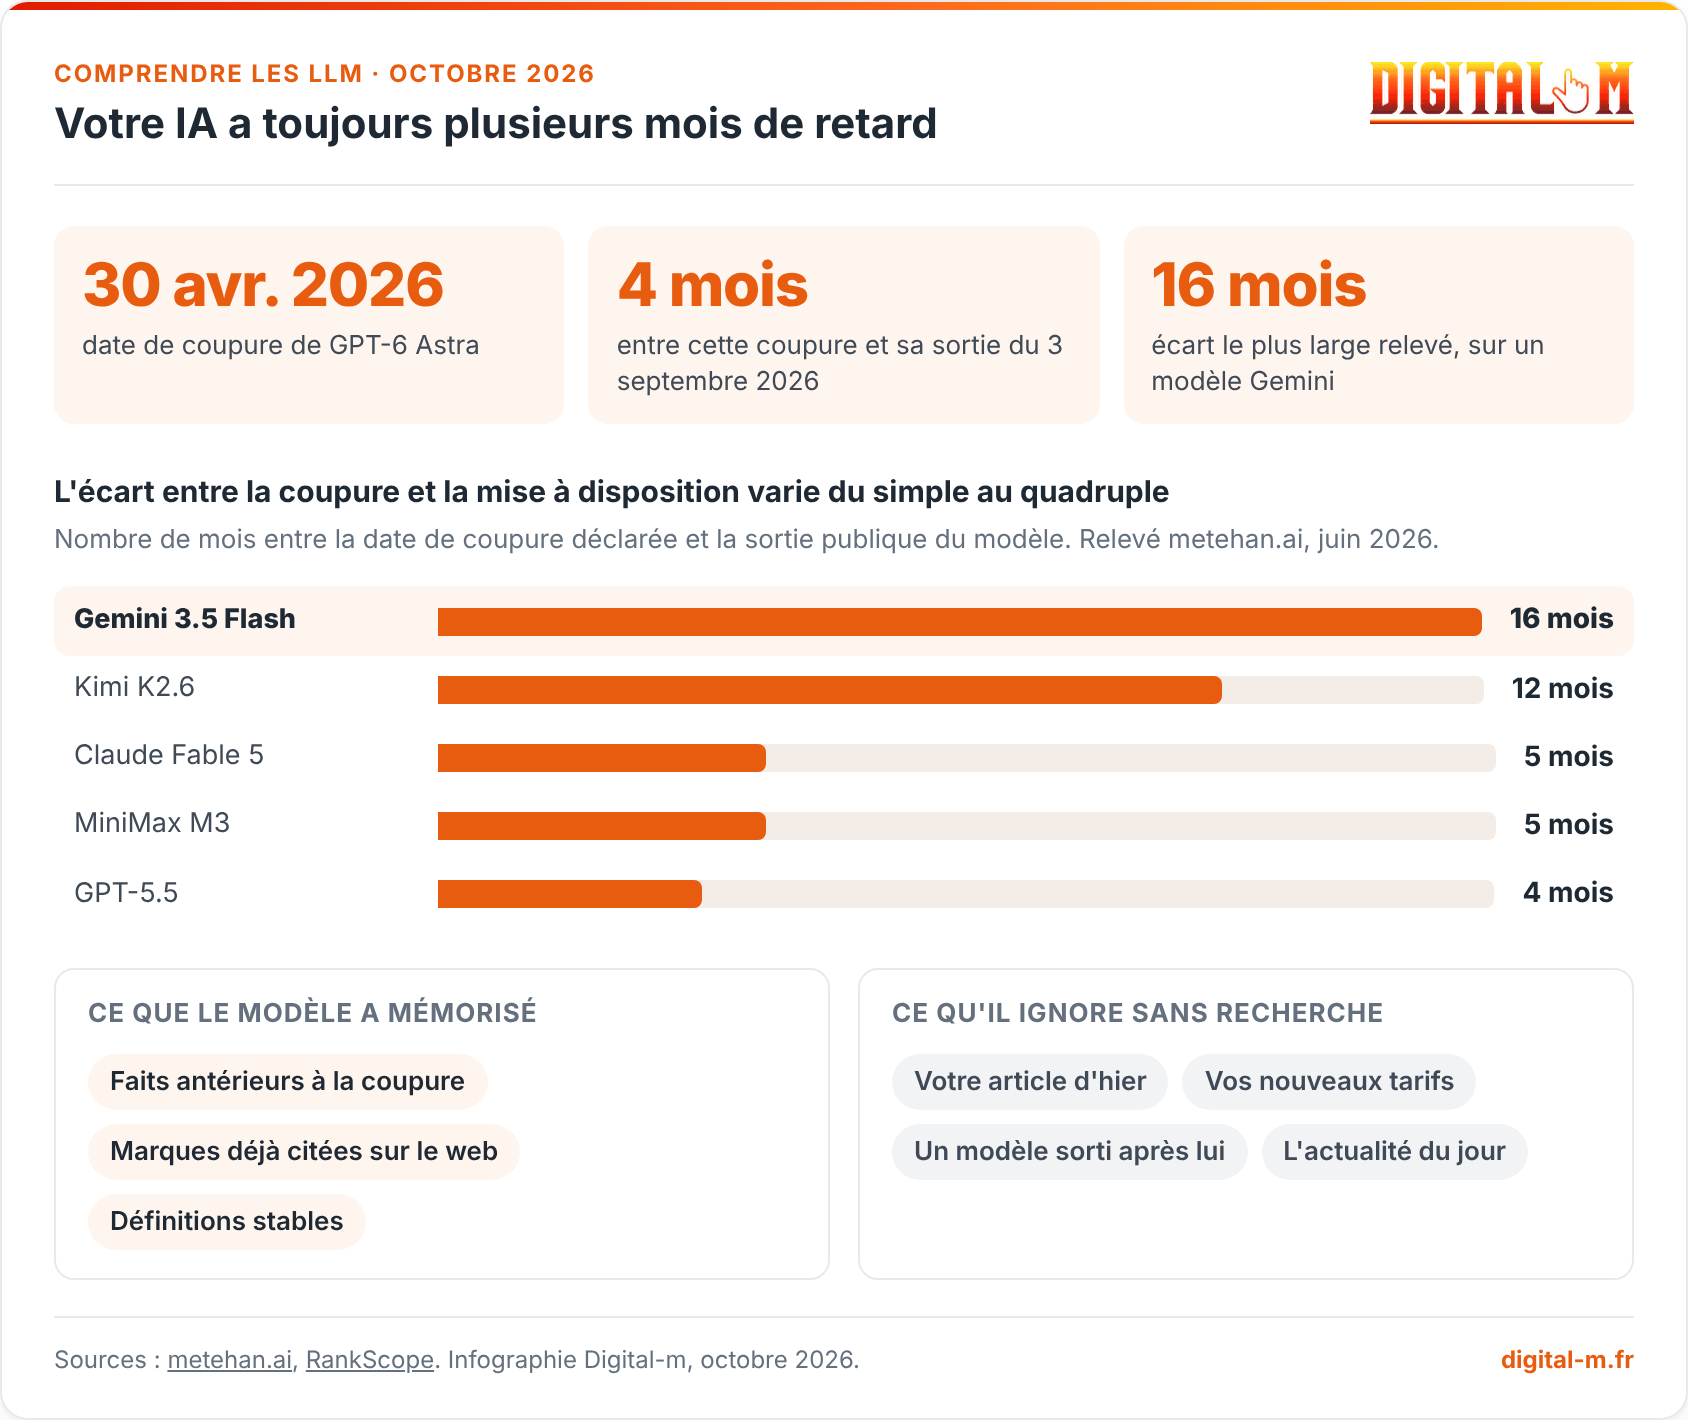
Votre IA a toujours plusieurs mois de retard

- 30 avr. 2026 date de coupure de GPT-6 Astra
- 4 mois entre cette coupure et sa sortie du 3 septembre 2026
- 16 mois écart le plus large relevé, sur un modèle Gemini
L'écart entre la coupure et la mise à disposition varie du simple au quadruple
Nombre de mois entre la date de coupure déclarée et la sortie publique du modèle. Relevé metehan.ai, juin 2026.
Ce que le modèle a mémorisé
Ce qu'il ignore sans recherche
Télécharger l'infographie (PNG)
Les dates de coupure des principaux modèles en octobre 2026
Voici les dates de coupure déclarées pour les modèles les plus utilisés, telles que les relèvent deux suivis spécialisés à jour début octobre 2026. Ces chiffres proviennent de la documentation des éditeurs, pas de mesures indépendantes.
| Modèle | Éditeur | Date de coupure déclarée |
|---|---|---|
| GPT-5.6 Sol et Luna | OpenAI | 16 février 2026 |
| GPT-6 Astra | OpenAI | 30 avril 2026 |
| GPT-6 Luna | OpenAI | 18 mai 2026 |
| Claude Opus 5.5 et Sonnet 5.5 | Anthropic | juin 2026 |
| Claude Opus 4.8 | Anthropic | janvier 2026 |
| Grok 4.7 | xAI | mai 2026 |
| Gemini 3.1 Pro | environ février 2026 | |
| Qwen 3.7 | Alibaba | environ avril 2026 |
| DeepSeek V4 | DeepSeek | environ avril 2026 |
| Llama 4.5 | Meta | environ mars 2026 |
| Mistral Medium 3 | Mistral AI | environ avril 2026 |
Deux enseignements sautent aux yeux de ce tableau des dates de coupure. D'abord, aucun modèle grand public ne connaît le mois en cours. Ensuite, les écarts entre éditeurs sont considérables : Anthropic et xAI rafraîchissent leurs corpus toutes les six à huit semaines environ, tandis que Google a laissé des modèles sortis en 2026 tourner sur des données de janvier 2025.
Le cas Grok, qui brouille la comparaison
Grok 4 constitue une exception notable : son accès continu aux publications de X fait qu'il n'a pas de coupure fixe pour cette partie de ses données. Comparer sa « date de coupure » à celle de GPT-6 ou de Gemini n'a donc qu'un sens limité. C'est un bon rappel que l'étiquette « date de coupure » recouvre des réalités techniques différentes selon les architectures.
Pourquoi les dates publiées ne concordent pas d'une source à l'autre
Les dates de coupure publiées ne concordent pas parce que personne, en dehors des éditeurs, ne peut les mesurer directement. Les suivis spécialisés recoupent fiches modèles, articles d'aide et prompts système d'API, trois sources qui se contredisent régulièrement.
Un exemple concret : pour les modèles Gemini 3.x, le relevé de metehan.ai de juin 2026 retient une coupure en janvier 2025, y compris pour Gemini 3.5 Flash sorti en mai 2026, et signale explicitement que les articles tiers annonçant janvier 2026 se trompent. Un autre suivi, celui de presenc.ai, indique « environ février 2026 » pour Gemini 3.1 Pro. Les deux ne peuvent pas avoir raison.
Trois causes se cumulent :
- Les éditeurs communiquent peu : Google, Meta, Mistral et DeepSeek ne publient pas systématiquement de date de coupure officielle. Les suivis comblent alors par estimation.
- Le modèle ignore sa propre date : les mainteneurs de Qwen avertissent eux-mêmes que leurs modèles ne connaissent pas toujours leur date de coupure. Lui poser la question donne une réponse qui relève du réglage post-entraînement, pas du corpus.
- Les corpus se contaminent entre eux : les modèles s'entraînent en partie sur des textes générés par d'autres modèles, ce qui rend les dates floues.
Chez Digital-m, nous auditons régulièrement la façon dont les IA parlent de nos clients, et cette incertitude a une conséquence pratique très simple : il ne faut jamais fonder une décision de visibilité sur une date de coupure trouvée dans un article de blog, y compris celui-ci. Il faut la tester.
Comment vérifier soi-même la date de coupure d'un modèle
Pour vérifier la date de coupure d'un modèle, la méthode la plus fiable consiste à sonder sa connaissance d'événements datés, plutôt qu'à lui poser la question directement. L'analyste Umesh Malik a formalisé cette approche en août 2026 autour de trois sondes complémentaires.
- Le quiz de faits datés : posez une série de questions factuelles sur des événements vérifiables, étalés mois par mois, puis repérez le moment où la précision des réponses s'effondre. C'est la sonde la plus parlante.
- La date auto-déclarée : demandez au modèle quelle est la date du jour, sans contexte. Si sa réponse est très postérieure à ce que le quiz suggère, les deux étapes d'entraînement se contredisent.
- Les sondes d'identité : répétez plusieurs formulations de la question « quel modèle es-tu ? ». Des réponses incohérentes signalent une contamination par les données d'autres éditeurs.
La règle de prudence de l'auteur mérite d'être reprise : ne retenez une estimation que si au moins deux sondes concordent. Appliquée à Claude Opus 5, la méthode donne une date de coupure réelle autour de janvier 2026, soit quatre mois avant la date de mai 2026 annoncée par Anthropic. Sur Claude Opus 4.7, en revanche, elle retombe à quelques semaines près sur la date officielle de janvier 2026, ce qui valide la méthode.
Ce résultat reste une estimation, l'auteur le souligne lui-même : il n'existe pas de vérité publique à laquelle se comparer. Il suffit cependant à ne plus prendre une fiche technique au pied de la lettre.
Recherche web, RAG et grounding : les trois béquilles du modèle
Un modèle figé peut quand même vous parler de l'actualité d'hier, à condition qu'on lui apporte l'information de l'extérieur. Trois mécanismes s'en chargent, et ils ne se valent pas.
- La recherche web : l'outil lance de vraies requêtes, récupère des pages et les résume. C'est ce qui se passe dans ChatGPT Search, Perplexity ou les Aperçus IA de Google. Les citations affichées dépendent alors de l'index de recherche, pas de la date de coupure.
- Le RAG : le Retrieval-Augmented Generation consiste à piocher dans une base documentaire privée avant de répondre. C'est la solution des entreprises qui veulent une IA à jour sur leurs propres documents.
- Le grounding : l'ancrage des réponses dans des sources réelles oblige le modèle à appuyer chaque affirmation sur un document fourni, ce qui réduit fortement les hallucinations.
Attention à un piège fréquent : un modèle équipé d'une recherche web ne la déclenche pas systématiquement. Il peut très bien répondre de mémoire sur une question qui lui semble stable, et vous servir un prix ou un classement périmé de six mois avec un aplomb parfait. Si la précision compte, demandez explicitement une vérification en ligne.
Ce que la date de coupure change pour votre visibilité
Pour une entreprise, la conséquence est claire : espérer entrer dans le corpus d'entraînement du prochain modèle est une stratégie à plusieurs mois, voire à plusieurs années. Être récupéré à la volée par une recherche web, en revanche, se joue dès maintenant.
Autrement dit, le levier utile n'est pas la date de coupure, c'est l'indexation et la citabilité. Un article publié ce matin peut être cité par Perplexity cet après-midi, alors qu'il n'entrera dans la mémoire paramétrique de GPT ou de Gemini qu'à la génération suivante, si tant est qu'il y entre.
Quatre réflexes en découlent :
- Datez vos pages visiblement : une date de mise à jour lisible aide le moteur génératif à juger de la fraîcheur, et c'est l'un des leviers de la fraîcheur du contenu en GEO.
- Formulez vos faits de façon autonome : un chiffre, sa source et sa date dans la même phrase se cite seul, hors contexte.
- Soignez l'indexabilité : si vos pages ne sont pas accessibles aux robots des IA, aucune fraîcheur ne vous sauvera.
- Surveillez ce que l'IA raconte de vous : une information obsolète figée dans un modèle peut circuler pendant toute la durée de vie de ce modèle.
C'est précisément le travail que mène notre agence GEO pour les PME, artisans et commerçants : rendre un site lisible, daté et citable, pour que les moteurs génératifs aillent y chercher l'information plutôt que de se fier à un souvenir vieux de huit mois.
Ce qu'il faut retenir
La date de coupure est la frontière des connaissances spontanées d'un modèle de langage. Tous les grands LLM en ont une, et aucun ne connaît le mois en cours : quatre mois de retard pour GPT-6 Astra, jusqu'à seize mois sur certains modèles Gemini. Anthropic est le seul éditeur à distinguer coupure des données et coupure des connaissances fiables, un aveu utile sur la qualité inégale des derniers mois de corpus.
Retenez aussi que les dates publiées se contredisent d'un suivi à l'autre, que le modèle ignore souvent la sienne, et qu'un sondage par faits datés donne une estimation plus honnête qu'une question directe. Enfin, pour votre visibilité, tout se joue dans la recherche web et non dans l'entraînement : datez, sourcez, rendez vos pages indexables.
Vous voulez savoir ce que les IA disent de votre entreprise aujourd'hui, et si elles le disent avec des informations à jour ? Demandez-nous un audit de visibilité générative, ou formez votre équipe avec notre formation GEO certifiée Qualiopi.
Et vous, avez-vous déjà repéré une information périmée sur votre entreprise dans une réponse d'IA ? Dites-le nous en commentaire !Sources et références
- metehan.ai - LLM Knowledge Cutoff Dates, Every Major Model Fact-Checked (juin 2026)
- RankScope - ChatGPT Knowledge Cutoff: Feb 16, 2026 (GPT-5.6) and Apr 30, 2026 (GPT-6) (mis à jour le 4 octobre 2026)
- presenc.ai - LLM Training Cutoff Date Tracker 2026 (juin 2026)
- Umesh Malik - How to Test an LLM's Knowledge Cutoff: Opus 5's May Claim Falls Short (11 août 2026)
- SearchOS - What is Knowledge Cutoff? LLM Limits & GEO Strategy (juin 2026)
- MarkTechPost - Mistral AI Releases Mistral Large 4 (Le Chonk) (6 octobre 2026)
Questions fréquentes sur la date de coupure des LLM
Comment connaître la date de coupure de ChatGPT ?
La documentation d'OpenAI indique une coupure au 16 février 2026 pour GPT-5.6 et au 30 avril 2026 pour GPT-6 Astra. Posez-lui directement la question et vous obtiendrez une réponse peu fiable : le modèle ignore souvent sa propre date. Préférez la fiche modèle officielle, puis vérifiez par un quiz de faits datés.
Pourquoi mon IA ne connaît-elle pas l'actualité d'hier ?
Parce que ses paramètres ont été figés à la fin de son entraînement, donc à sa date de coupure. Elle ne lit pas le web en continu. Si l'outil dispose d'une recherche web, il peut aller chercher l'information, mais il ne le fait pas systématiquement : demandez-lui explicitement de vérifier en ligne.
Date de coupure et fenêtre de contexte, quelle différence ?
La date de coupure concerne ce que le modèle a appris pendant son entraînement, donc sa mémoire permanente. La fenêtre de contexte désigne la quantité de texte qu'il peut lire dans une même conversation, par exemple un million de tokens pour Mistral Large 4. Coller un document récent dans la fenêtre de contexte contourne la coupure, le temps de l'échange.
Un nouvel article a-t-il une chance d'entrer dans un modèle ?
Oui, mais à la génération suivante et sans garantie. Les éditeurs rafraîchissent leurs corpus toutes les six à huit semaines environ chez OpenAI, Anthropic et Google, tous les deux à trois mois chez les acteurs chinois. En attendant, le seul chemin rapide vers une citation passe par la recherche web et l'indexation de votre page.
Pourquoi Anthropic publie-t-il deux dates de coupure ?
Parce que les deux derniers mois d'un corpus sont moins densément couverts que le reste. Anthropic distingue donc la coupure des données d'entraînement et celle des connaissances fiables. Pour Claude Sonnet 4.6, les données vont jusqu'en janvier 2026 mais les connaissances solides s'arrêtent en août 2025.