
Gemini 4 Argon : 3 fois moins d'hallucinations que GPT-6
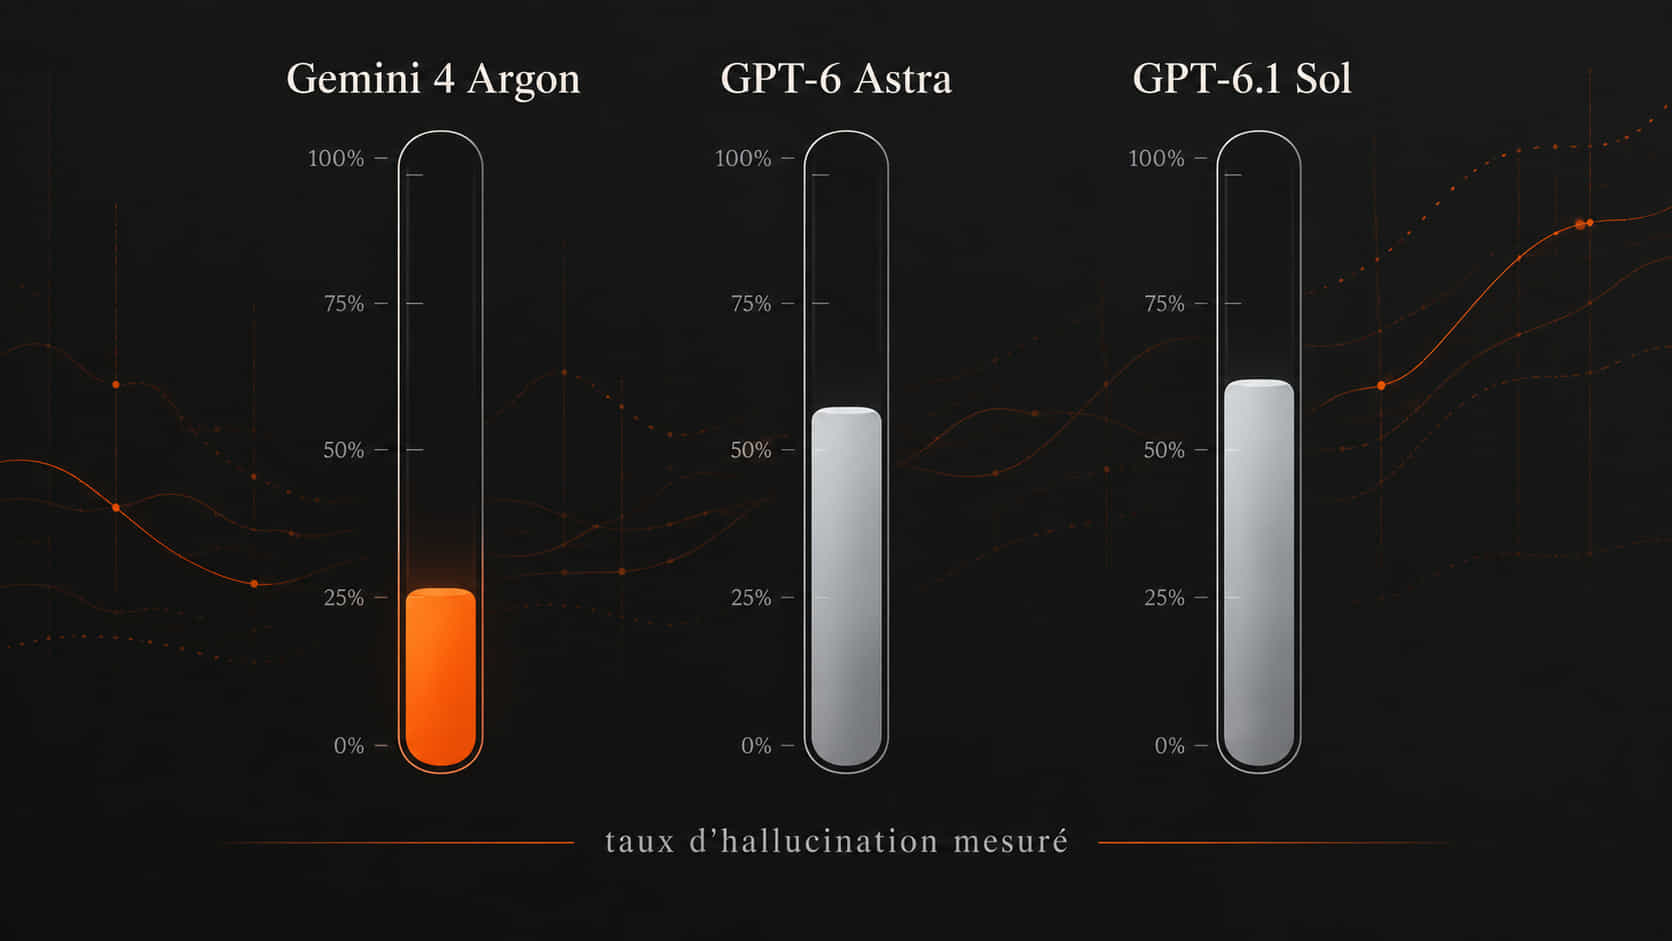
Quinze pour cent. C'est le taux d'hallucination mesuré sur Gemini 4 Argon, le nouveau modèle de pointe annoncé par Google DeepMind le 30 septembre 2026. Au même moment, GPT-6 Astra affiche 51 % et GPT-6.1 Sol 54 % sur le même protocole. Pour une fois, la nouveauté ne porte pas sur un score de raisonnement de plus, mais sur la quantité de bêtises qu'un modèle raconte quand il ne sait pas. Argon égale GPT-6 Astra sur l'indice d'intelligence d'Artificial Analysis, à 53 points, pour environ 60 % du coût par tâche. Le hic : presque personne ne peut l'utiliser aujourd'hui, l'accès étant réservé à un programme fermé de cyberdéfenseurs. Voici les chiffres, les limites, et ce que cette sortie change concrètement pour votre visibilité dans les réponses des IA.
-

- Dernière modification
1er octobre 2026 - 8 minutes de lecture
Gemini 4 Argon : ce que Google a annoncé le 30 septembre 2026
Gemini 4 Argon est le premier modèle de la génération Gemini 4 de Google DeepMind, annoncé le 30 septembre 2026 et orienté vers trois usages : le développement logiciel, le travail documentaire en entreprise (juridique, finance) et la cyberdéfense. Il ne remplace pas Gemini 3.8 Flash dans les produits grand public, il arrive au-dessus, comme modèle haut de gamme.
Le changement le plus spectaculaire ne concerne pas l'intelligence brute mais la longueur de sortie. Argon peut produire jusqu'à 1 million de tokens dans une seule réponse, contre 64 000 pour la génération précédente, grâce à une fonctionnalité expérimentale baptisée «Long Decode Continuation». Un token est l'unité de découpage du texte que les modèles facturent, environ trois quarts de mot en français.
- Éditeur : Google DeepMind, annonce officielle publiée le 30 septembre 2026.
- Sortie maximale : 1 million de tokens par réponse, contre 64 000 auparavant.
- Tarif de lancement : 1,76 € le million de tokens en entrée, 8,82 € en sortie.
- Score d'intelligence : 53 points sur l'indice Artificial Analysis, à égalité avec GPT-6 Astra.
- Taux d'hallucination : 15 %, le plus bas de tous les modèles dépassant 45 points sur cet indice.
- Accès : programme Fairwind uniquement, réservé aux cyberdéfenseurs et aux administrations.
Google met aussi en avant des usages internes chiffrés : des agents Argon auraient libéré plus de 300 TiB de mémoire sur ses infrastructures et participé à la migration de plus de 800 000 lignes de code C et C++ vers Rust. Ces chiffres proviennent de Google, ils n'ont pas été vérifiés par un tiers indépendant.
Un taux d'hallucination de 15 %, et pourquoi ce chiffre compte
Le taux d'hallucination mesuré sur Gemini 4 Argon est de 15 %, contre 51 % pour GPT-6 Astra et 54 % pour GPT-6.1 Sol, selon le protocole AA-Omniscience d'Artificial Analysis. Une hallucination désigne une réponse fausse énoncée avec assurance, sans aucun signal d'incertitude. C'est le défaut le plus coûteux d'un modèle de langage en usage professionnel.
Le protocole AA-Omniscience interroge le modèle sur des faits vérifiables et compte la part de réponses erronées parmi les réponses données. Un taux bas signifie donc que le modèle se trompe rarement quand il répond. Nous avons déjà détaillé pourquoi les LLM inventent des réponses et ce qui déclenche le phénomène.
La nuance mérite d'être posée franchement, parce qu'elle est systématiquement escamotée dans les reprises de l'annonce. Argon affiche une précision globale de 50 %, là où GPT-6 Astra atteint 63 %. Autrement dit, Argon répond moins souvent, et se trompe beaucoup moins quand il répond. Il préfère s'abstenir. Pour un juriste ou un analyste financier, c'est exactement le comportement souhaité. Pour un assistant grand public censé toujours trouver quelque chose à dire, c'est un compromis.
Chez Digital-m, nous auditons régulièrement les réponses générées par ChatGPT, Gemini et Perplexity sur les requêtes commerciales de nos clients, et le constat est constant : les erreurs les plus dommageables ne sont pas les absences de citation, ce sont les faits inventés sur une marque, un tarif ou une zone d'intervention. Un modèle qui s'abstient plus souvent est une bonne nouvelle pour les entreprises citées.
Gemini 4 Argon face aux modèles de pointe

- 15 % taux d'hallucination d'Argon, contre 51 % pour GPT-6 Astra
- 53 points d'indice d'intelligence, à égalité avec GPT-6 Astra
- 1,76 € le million de tokens en entrée, tarif de lancement
- 650+ organisations ayant accès via le programme Fairwind
Argon rejoint le peloton de tête, sans le dominer
Indice d'intelligence Artificial Analysis, mesure du 1er octobre 2026, effort de raisonnement maximal. Plus le score est élevé, mieux c'est.
À retenir : sur l'intelligence pure, Gemini 4 Argon rattrape GPT-6 Astra sans détrôner Claude Opus 5.5 ; son vrai avantage est de se tromper trois fois moins souvent, au prix d'une abstention plus fréquente (précision de 50 % contre 63 % pour Astra). Pour votre entreprise, cela signifie qu'un modèle fiable ira chercher une source citable plutôt que d'inventer, et que la qualité de vos contenus publics pèse davantage dans la réponse affichée.
Télécharger l'infographie (PNG)

Combien coûte Argon, en euros
Gemini 4 Argon est facturé 1,76 € le million de tokens en entrée et 8,82 € en sortie pendant la période de lancement, puis 3,53 € et 17,64 € ensuite. Google applique une réduction de lancement de 50 %, sans date de fin annoncée. Les tokens mis en cache bénéficient d'une remise de 95 %, soit environ 0,09 € le million.
Ces montants sont convertis depuis les tarifs officiels en dollars (2 et 10 dollars au lancement, 4 et 20 dollars ensuite), au taux de 1 euro pour 1,1341 dollar relevé le 29 septembre 2026. La comparaison avec les concurrents directs est instructive.
| Modèle | Entrée (par million de tokens) | Sortie (par million de tokens) |
|---|---|---|
| Gemini 4 Argon (lancement) | 1,76 € | 8,82 € |
| Argon (tarif normal) | 3,53 € | 17,64 € |
| Claude Opus 5.5 | 3,53 € | 17,64 € |
| GPT-6 Astra | 8,82 € | 44,09 € |
| Claude Fable 5.1 | 8,82 € | 44,09 € |
Attention au piège du prix unitaire. Artificial Analysis relève qu'Argon génère en moyenne 62 000 tokens de sortie par tâche, contre 27 000 pour GPT-6 Astra, soit plus du double. Le coût par tâche réelle ressort à environ 1,75 € au tarif promotionnel et 3,51 € au tarif plein, soit à peu près 60 % du coût de GPT-6 Astra pour une performance équivalente. L'avantage reste net, mais il est deux fois moins large que ne le suggère la grille tarifaire. Ce décalage entre tarif affiché et facture réelle est devenu la règle : nous l'avions documenté en expliquant pourquoi la baisse des prix des LLM s'est arrêtée en 2026.
Les benchmarks annoncés, et ce qu'ils valent vraiment
Google revendique la première place sur 12 des 18 évaluations publiées, et Latent Space compte 13 victoires sur 19 tests crédibles face à GPT-6 Astra et Claude Opus 5.5. Reuters, cité par la presse spécialisée, note que Google a employé un mot plus prudent sur certains tests de programmation et de cybersécurité : «comparable».
Là où Argon prend la tête
- DeepSWE v1.1 : 77,9 %, contre 74,2 % pour Claude Opus 5.5 et 74,1 % pour GPT-6 Astra. C'est le meilleur score public sur ce test d'ingénierie logicielle.
- LVBench : 91,7 % en compréhension de vidéos longues.
- Text Arena : première place avec 1 525 points, un classement établi par votes humains comparatifs.
- Vibe Code Bench : 30 applications générées sans défaut, contre 25 pour Claude Opus 5 et 24 pour GPT-6 Astra.
- CWE-bench v1 : 68 %, à égalité en première place sur la détection de vulnérabilités logicielles.
Là où Argon décroche
Sur FrontierSWE v2, Argon plafonne à 55,0 % quand GPT-6 Astra atteint 65,5 %. Un écart de plus de dix points sur un test réputé plus proche de conditions réelles que DeepSWE. Les premiers retours relèvent aussi un niveau modeste en développement web, et des outils logiciels encore en retard sur les environnements agentiques d'OpenAI et d'Anthropic.
Rappel méthodologique utile : tous ces scores sont déclarés par les éditeurs eux-mêmes, sur des tests qu'ils choisissent. Seuls l'indice Artificial Analysis et Text Arena reposent sur un protocole tiers. Nous détaillons les pièges de cette lecture dans notre article sur les quatre sorties de modèles en 48 heures de septembre 2026, où les écarts annoncés s'étaient révélés bien plus minces à l'usage.
Pourquoi presque personne ne peut encore l'utiliser
Argon n'est accessible qu'aux membres du programme Fairwind de Google, qui réunit plus de 650 organisations : agences gouvernementales, opérateurs d'infrastructures critiques et fournisseurs de sécurité. Aucune API publique, aucun abonnement grand public, aucune date de disponibilité élargie n'a été communiquée.
La raison avancée par Google tient aux capacités offensives potentielles du modèle : Argon sait «trouver, valider et corriger de façon autonome des vulnérabilités logicielles critiques». Un outil capable de corriger une faille sait aussi la trouver. Google a engagé un processus volontaire de revue pré-lancement avec le gouvernement américain avant toute ouverture plus large.
Conséquence pratique pour une PME française : vous ne testerez pas Argon cette semaine, ni probablement ce mois-ci. Les modèles qui alimentent réellement les réponses vues par vos clients restent Gemini 3.8 Flash dans les AI Overviews de Google, GPT-6 dans ChatGPT, et les moteurs de Perplexity ou de Mistral côté européen. L'annonce est un signal de trajectoire, pas un changement immédiat de terrain.
Où se situe Argon dans le classement des modèles de pointe
Avec 53 points sur l'indice d'intelligence d'Artificial Analysis, Argon égale GPT-6 Astra mais reste derrière Claude Opus 5.5 (58 points) et Claude Sonnet 5.5 (56 points). Google progresse de 23 points par rapport à Gemini 3.1 Pro Preview, ce qui ramène l'éditeur dans le trio de tête après plusieurs mois d'absence des annonces majeures.
Le reste du classement, à la même date : GPT-6.1 Sol à 52 points, Grok 4.7 de xAI à 46, Qwen3.8 Max d'Alibaba à 45, Kimi K3 de Moonshot AI à 44, DeepSeek V4 Pro à 36. Mistral Large 3 et Llama 4 Scout figurent beaucoup plus bas sur cet indice (9 et 8 points), mais la comparaison est trompeuse : l'indice mesure le raisonnement à effort maximal, un terrain que ces modèles ne visent pas, puisqu'ils jouent sur la latence, le coût et les poids ouverts.
Le vrai enseignement de cette grille est l'écart entre le haut du classement et le milieu de tableau : six points séparent Claude Opus 5.5 de GPT-6.1 Sol, pour des tarifs qui varient d'un facteur cinq. Choisir un modèle sur son score d'intelligence seul reste un mauvais réflexe.
Ce que cette sortie change pour votre visibilité dans les réponses IA
Un modèle qui hallucine moins va chercher plus souvent une source externe, ce qui augmente mécaniquement la valeur d'un contenu clair, daté et attribuable. C'est le mécanisme du grounding, l'ancrage de la réponse générée sur des documents récupérés en direct plutôt que sur la mémoire du modèle.
Trois conséquences concrètes pour votre contenu, dès maintenant, sans attendre l'ouverture d'Argon :
- Chiffrez et datez : un modèle prudent écarte les affirmations vagues et retient celles qu'il peut vérifier. «Nos délais d'intervention sont rapides» ne sera jamais cité, «intervention sous 48 heures en Île-de-France, tarif 2026» a une chance de l'être.
- Nommez les entités : marque, ville, modèle de produit, version, norme, année. Ce sont les points d'accroche que les moteurs génératifs utilisent pour relier votre page à une question.
- Placez l'essentiel tôt : notre étude maison montre que 44,2 % des citations de ChatGPT proviennent du premier tiers d'un article. Une définition ou un chiffre clé enterré en conclusion ne sera pas repris.
La sortie de la génération Gemini 4 confirme aussi une tendance de fond : les écarts de capacité entre éditeurs se resserrent, et la différenciation se déplace vers la qualité des sources que les modèles consultent. C'est précisément le terrain du GEO, et c'est pour cela que notre agence GEO travaille d'abord sur la structure et la vérifiabilité des contenus, avant les volumes.
Ce qu'il faut retenir
Argon marque le retour de Google dans le trio de tête des modèles de pointe, avec 53 points d'indice d'intelligence, un record de sortie à 1 million de tokens et surtout un taux d'hallucination de 15 % quand ses concurrents directs dépassent 50 %. Le tarif de lancement, 1,76 € et 8,82 € le million de tokens, le place sous Claude Opus 5.5 et très loin sous GPT-6 Astra, même en tenant compte de sa verbosité doublée.
Les réserves sont réelles : scores déclarés par l'éditeur, précision globale inférieure à celle de GPT-6 Astra, décrochage sur FrontierSWE v2, et accès verrouillé au programme Fairwind sans calendrier d'ouverture. L'annonce informe votre stratégie, elle ne la déclenche pas.
Ce que vous pouvez faire dès cette semaine, en revanche, c'est préparer vos contenus pour des moteurs qui citent mieux et inventent moins : affirmations chiffrées, entités nommées, informations clés placées haut dans la page. Si vous voulez savoir sur quelles requêtes vos concurrents sont déjà cités et vous non, demandez-nous un audit de visibilité IA. Et si vous préférez internaliser la compétence, notre formation GEO certifiée Qualiopi couvre exactement cette méthode.
Et vous, préférez-vous une IA qui répond moins souvent mais se trompe rarement, ou l'inverse ? Dites-le nous en commentaire !Sources et références
- Google - Gemini 4 Argon: our next era of frontier intelligence (30 septembre 2026)
- MarkTechPost - Google DeepMind Unveils Gemini 4 Argon with 1M Output Tokens for Coding, Knowledge Work and Cyber Defense (30 septembre 2026)
- The Decoder - Google Gemini 4 Argon closes the gap with OpenAI and Anthropic but doesn't take a clear lead (1er octobre 2026)
- Artificial Analysis - LLM Leaderboard, indice d'intelligence et taux d'hallucination (relevé du 1er octobre 2026)
- Latent Space - AINews: Gemini 4 Argon, GDM's answer to Astra/Fable, with 1M output (1er octobre 2026)
- Forkast - Google's Gemini 4 Argon Closes the Pricing Triangle. The Benchmark Lead Is the Real Story (octobre 2026)
- MacGeneration - Google annonce Gemini 4 Argon, qui battrait les derniers modèles OpenAI et Anthropic (1er octobre 2026)
- Growth Memo - The Science of How AI Pays Attention (2026)
- Digital-m - 44 % des citations de ChatGPT viennent du premier tiers de vos articles (2026)
- Exchange-Rates.org - Taux de change EUR/USD, relevé du 29 septembre 2026
Questions fréquentes sur Gemini 4 Argon
Quand Gemini 4 Argon sera-t-il disponible pour tout le monde ?
Google n'a annoncé aucune date. Au 1er octobre 2026, l'accès est réservé au programme Fairwind, qui réunit plus de 650 organisations de cyberdéfense et administrations. L'éditeur indique vouloir ouvrir l'accès aux développeurs, aux entreprises puis au grand public «dès que possible», après un processus de revue pré-lancement engagé avec le gouvernement américain.
Argon est-il meilleur que GPT-6 et Claude ?
Cela dépend du critère. Sur l'indice d'intelligence d'Artificial Analysis, Argon égale GPT-6 Astra à 53 points mais reste derrière Claude Opus 5.5 (58 points). Sur la fiabilité factuelle, Argon domine largement avec 15 % d'hallucinations contre 51 % pour GPT-6 Astra. Sur FrontierSWE v2 en revanche, il décroche à 55,0 % contre 65,5 % pour GPT-6 Astra. Aucun modèle ne gagne sur tous les tableaux.
Que signifie une sortie de 1 million de tokens ?
Un token correspond à environ trois quarts de mot en français. Un million de tokens en sortie représente donc à peu près 750 000 mots dans une seule réponse, soit l'équivalent de plusieurs romans. Concrètement, cela permet de générer une base de code complète ou un dossier documentaire entier sans que le modèle s'interrompe. La génération précédente plafonnait à 64 000 tokens. Cette capacité repose sur une fonctionnalité expérimentale appelée «Long Decode Continuation».
Un taux d'hallucination de 15 %, est-ce vraiment bon ?
C'est le meilleur résultat mesuré parmi les modèles dépassant 45 points d'indice d'intelligence, et environ trois fois mieux que GPT-6 Astra. La nuance à connaître : Argon atteint ce chiffre en s'abstenant plus souvent de répondre, sa précision globale étant de 50 % contre 63 % pour GPT-6 Astra. Pour un usage juridique, financier ou de conformité, ce comportement prudent est préférable. Pour un assistant généraliste, c'est un arbitrage discutable.
Faut-il changer sa stratégie GEO à cause de Gemini 4 Argon ?
Pas de virage à opérer, mais une confirmation de cap. Les modèles qui hallucinent moins s'appuient davantage sur des sources récupérées en direct, ce qui valorise les contenus chiffrés, datés et clairement attribuables. Les trois leviers à travailler restent les mêmes : affirmations vérifiables plutôt que formulations vagues, entités nommées (marque, ville, version, année), et informations clés placées dans le premier tiers de la page.