
Latence des LLM : pourquoi l'IA répond vite ou lentement
Même question, même modèle, même journée : un dixième de seconde avant le premier mot, parfois dix secondes d'attente. L'écart mesuré entre les modèles de pointe atteint un facteur 78, de 0,12 seconde pour Claude Opus 5.5 à 9,32 secondes pour Grok 4.7 poussé à son réglage de réflexion maximal. Cette attente n'a rien d'aléatoire : elle s'explique par deux phases techniques très différentes, par un mécanisme de cache que vous pouvez exploiter, et par la quantité de texte que vous envoyez. Comprendre la latence des LLM, c'est comprendre pourquoi votre facture d'API grimpe et pourquoi votre chatbot semble parfois à l'arrêt.
-
- Dernière modification
4 octobre 2026 - 9 minutes de lecture
Qu'appelle-t-on la latence d'un LLM ?
La latence d'un LLM est le temps qui sépare l'envoi de votre question de l'apparition du premier mot de la réponse. Les ingénieurs l'appellent le TTFT, pour « time to first token », soit le délai avant le premier jeton. C'est la mesure qui correspond à ce que vous ressentez comme de l'attente.
Elle ne doit pas être confondue avec la vitesse d'écriture, mesurée en jetons par seconde. Un jeton, ou token, est le fragment de texte que le modèle manipule, environ trois quarts d'un mot en français. Les deux indicateurs sont indépendants : un modèle peut démarrer très vite puis écrire lentement, ou l'inverse.
- Latence (TTFT) : le silence avant le premier mot. Mesurée en secondes ou en millisecondes.
- Débit (jetons par seconde) : la vitesse à laquelle le texte se déroule une fois commencé.
- Durée totale : la somme des deux, la seule qui compte pour un agent automatisé qui ne lit pas au fil de l'eau.
Exemple concret relevé chez Artificial Analysis : GPT-6 Astra démarre en 0,23 seconde mais écrit à 51 jetons par seconde, tandis que DeepSeek V4.1 Flash met 0,99 seconde à démarrer puis déroule à 209 jetons par seconde. Sur une réponse longue, le second termine largement avant le premier. Pour tout comprendre sur cette unité de mesure, voyez notre article sur les tokens des LLM.
Les deux temps d'une réponse : le prefill et le decode
Une réponse d'IA se fabrique en deux phases aux propriétés opposées. C'est la clé de toute la suite.
La première phase s'appelle le prefill, littéralement le préremplissage. Le modèle lit d'un seul coup l'intégralité de ce que vous lui avez envoyé : votre question, l'historique de la conversation, les documents joints, les instructions du système. Il traite tous ces jetons en parallèle. Cette phase est gourmande en puissance de calcul pur et c'est elle qui détermine la latence.
La seconde phase s'appelle le decode, le décodage. Le modèle écrit sa réponse un jeton après l'autre, chacun dépendant des précédents. Impossible de paralléliser. Cette phase n'est pas limitée par la puissance de calcul mais par la bande passante mémoire de la carte graphique, c'est-à-dire la vitesse à laquelle elle va chercher ses propres données.
Retenez la conséquence pratique : un prompt long allonge l'attente avant le premier mot, une réponse longue allonge la durée totale. Ce ne sont pas les mêmes leviers.
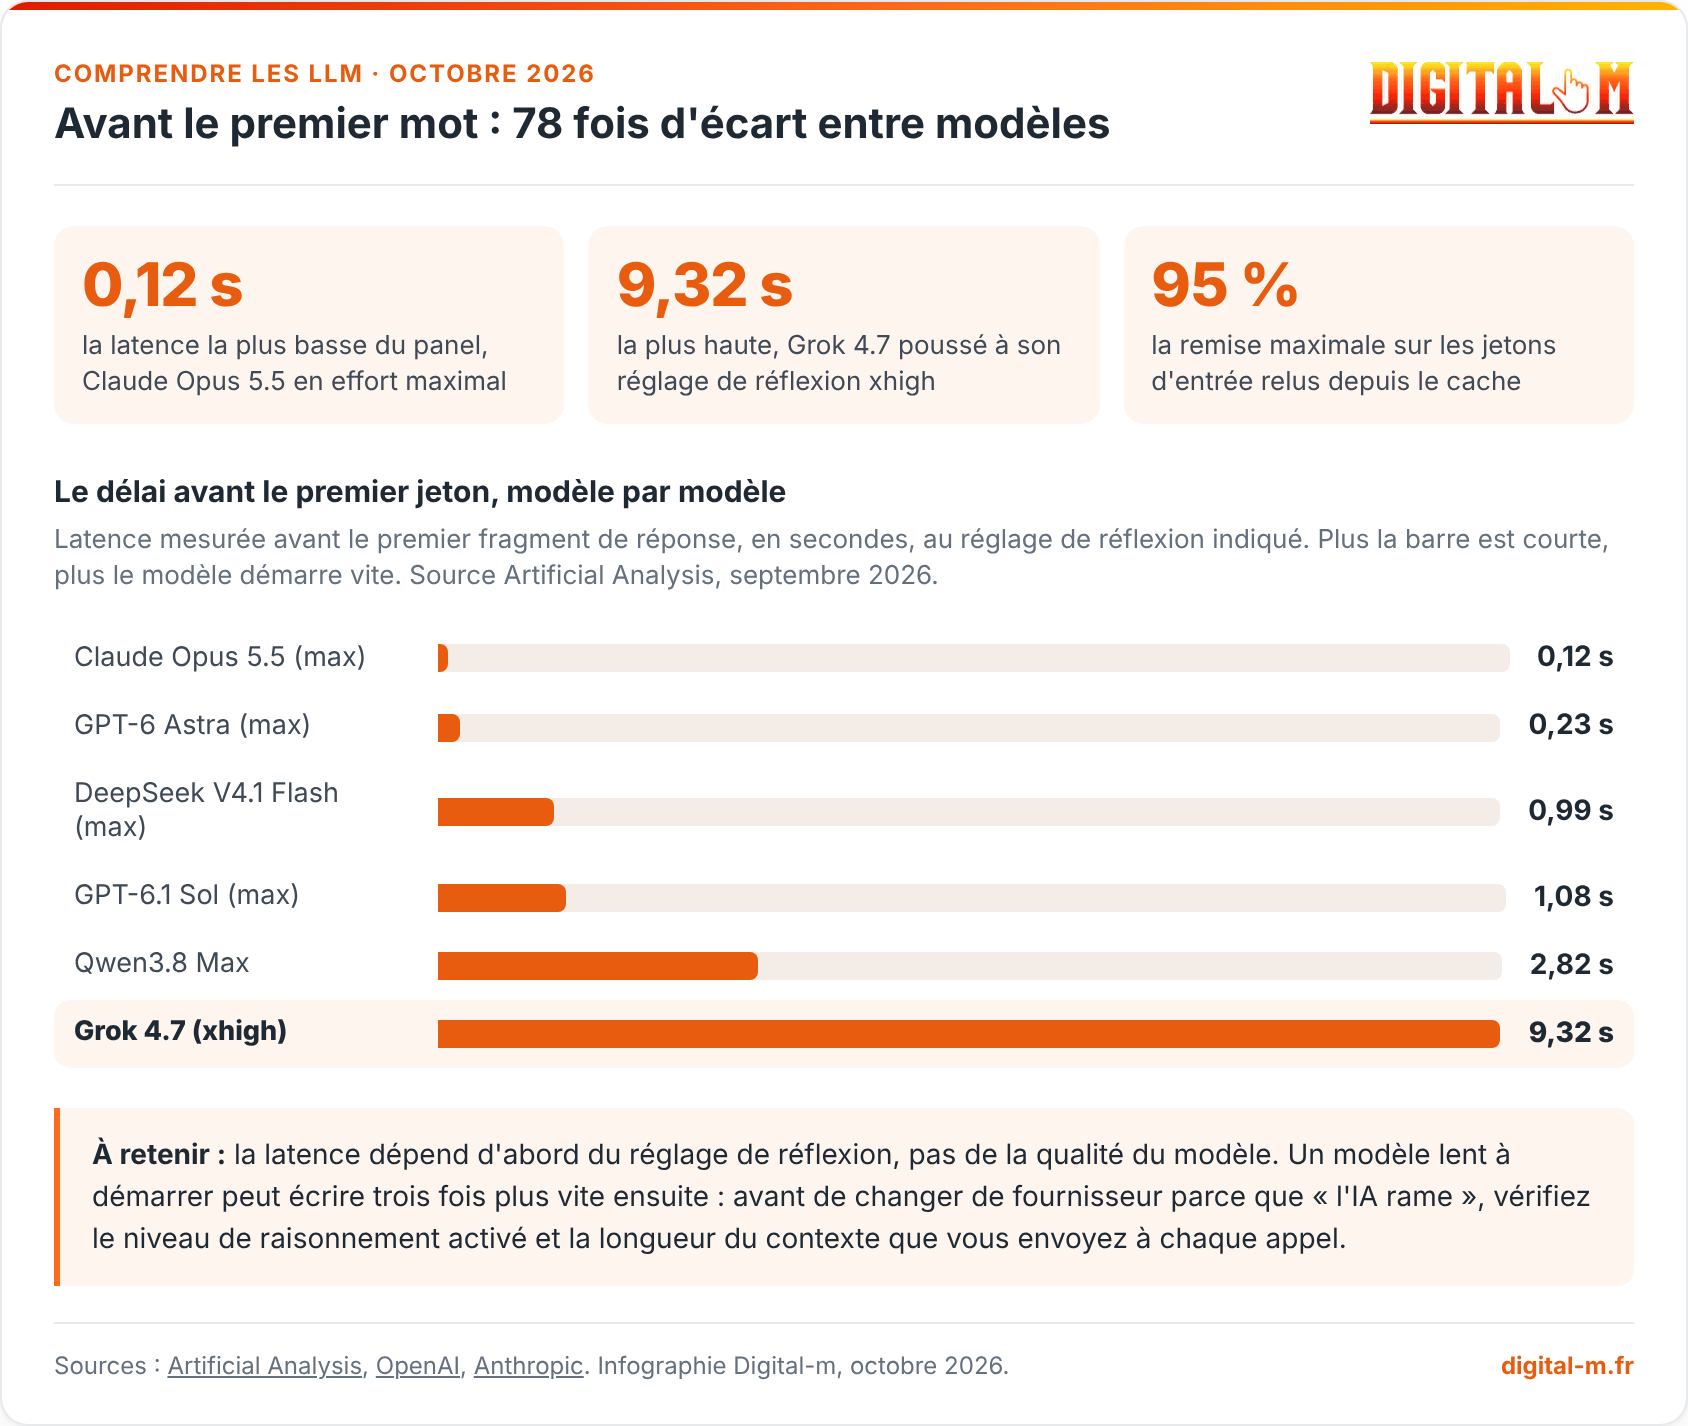
Avant le premier mot : 78 fois d'écart entre modèles

- 0,12 s la latence la plus basse du panel, Claude Opus 5.5 en effort maximal
- 9,32 s la plus haute, Grok 4.7 poussé à son réglage de réflexion xhigh
- 95 % la remise maximale sur les jetons d'entrée relus depuis le cache
Le délai avant le premier jeton, modèle par modèle
Latence mesurée avant le premier fragment de réponse, en secondes, au réglage de réflexion indiqué. Plus la barre est courte, plus le modèle démarre vite. Source Artificial Analysis, septembre 2026.
À retenir : la latence dépend d'abord du réglage de réflexion, pas de la qualité du modèle. Un modèle lent à démarrer peut écrire trois fois plus vite ensuite : avant de changer de fournisseur parce que « l'IA rame », vérifiez le niveau de raisonnement activé et la longueur du contexte que vous envoyez à chaque appel.
Télécharger l'infographie (PNG)
Le cache, l'accélérateur invisible
Le cache est la raison pour laquelle la deuxième question d'une conversation arrive souvent plus vite que la première. Il en existe deux formes, qu'il ne faut pas confondre.
Le KV cache, le carnet de notes du modèle
Pendant qu'il lit votre texte, le modèle calcule pour chaque jeton des valeurs intermédiaires qu'il range dans une mémoire appelée KV cache, pour « key-value cache », soit le cache clé-valeur. Sans lui, il devrait tout recalculer à chaque nouveau mot écrit. Avec lui, il réutilise ses notes. Ce mécanisme est automatique, interne, et vous n'avez aucune prise dessus.
Le prompt caching, celui que vous pilotez
Le prompt caching, ou mise en cache du prompt, conserve le travail de lecture d'un début de message identique entre deux appels. Si vos mille premières lignes d'instructions ne changent jamais, le fournisseur ne les relit pas : il repart de ses notes. L'attente avant le premier mot chute, et le coût aussi.
Les trois grands fournisseurs l'ont industrialisé, avec des règles différentes.
- OpenAI : activé par défaut sur les modèles compatibles, à partir de 1 024 jetons pour GPT-5.6 et au-delà. Le cache est conservé au moins 30 minutes après la dernière utilisation.
- Anthropic : à déclarer explicitement, à partir de 512 jetons sur les modèles récents comme Claude Opus 5.5. Durée de vie de 5 minutes par défaut, extensible à 1 heure.
- Google : le cache implicite est activé par défaut sur Gemini 2.5 et les versions suivantes, à partir de 4 096 jetons sur les Gemini 3.x Flash. Rien à paramétrer.
Point commun : le cache ne se déclenche que si le début du message est strictement identique. Un horodatage ou un identifiant de session placé en tête de prompt suffit à tout invalider. Placez toujours la partie stable en premier et la partie variable en dernier.
Ce que vous payez quand vous attendez
La latence et la facture sont liées, parce que les deux dépendent du nombre de jetons d'entrée relus à chaque appel. Les remises accordées sur les jetons servis depuis le cache sont considérables.
- Lecture en cache standard : facturée 0,1 fois le tarif d'entrée normal, soit 90 % d'économie sur cette portion.
- Lecture en cache sur les modèles les plus optimisés : 0,05 fois le tarif, soit 95 % d'économie, un niveau revendiqué aussi bien par OpenAI sur GPT-6.1 Sol que par Anthropic sur Claude Opus 5.5.
- Écriture en cache : chez Anthropic, elle coûte 1,25 fois le tarif d'entrée pour une durée de vie de 5 minutes, et 2 fois pour une heure. Le cache n'est donc rentable qu'à partir de deux réutilisations.
Attention au raccourci « rapide égale économique ». Artificial Analysis publie un coût moyen par tâche qui montre l'inverse. Au cours du 30 septembre 2026, où un euro valait 1,1331 dollar, le modèle le plus rapide à démarrer, Claude Opus 5.5, revient à environ 5,28 € par tâche, quand DeepSeek V4.1 Flash en coûte 0,24 €, soit vingt-deux fois moins, pour une latence certes huit fois supérieure mais un débit quatre fois plus élevé. Le bon arbitrage dépend entièrement de votre usage. Nous détaillons ces tarifs dans notre dossier sur les prix des LLM en 2026.
Pourquoi les modèles de raisonnement sont plus lents
Un modèle de raisonnement réfléchit avant de répondre, et cette réflexion consomme des jetons que vous payez sans jamais les lire. C'est la principale cause d'attente longue en 2026.
Le chiffre le plus parlant de notre panel vient de là. Grok 4.7 affiche 9,32 secondes de latence au réglage xhigh, le niveau de réflexion le plus poussé, contre 0,12 seconde pour Claude Opus 5.5 au réglage max. Ce n'est pas une différence d'architecture, c'est une différence de quantité de réflexion demandée. Le même modèle, réglé plus bas, démarre bien plus vite.
Conséquence opérationnelle : avant de conclure qu'un fournisseur est lent, vérifiez le niveau d'effort configuré. Dans la moitié des intégrations que nous reprenons chez Digital-m, le réglage de raisonnement a été laissé au maximum par défaut sur des tâches qui n'en avaient aucun besoin, comme reformuler un titre ou classer un e-mail. Le sujet est développé dans notre article sur le raisonnement des LLM.
Les six facteurs qui ralentissent vos réponses au quotidien
Au-delà du modèle choisi, six paramètres expliquent l'essentiel des variations que vous observez d'un appel à l'autre.
- La longueur du contexte : plus vous envoyez de texte, plus le prefill est long. Un historique de conversation de 50 messages coûte du temps à chaque tour. Voyez notre article sur le contexte dans les LLM.
- Le niveau de raisonnement : le facteur le plus lourd, et le plus facile à régler.
- Le cache touché ou manqué : un prompt à préfixe stable démarre nettement plus vite qu'un prompt reconstruit à chaque fois.
- La charge du service : aux heures de pointe, les requêtes sont regroupées par lots, ce qui augmente le débit global du serveur mais allonge l'attente individuelle.
- Les outils appelés : une recherche web, une lecture de fichier ou un appel à une base de données ajoutent chacun leur propre délai, invisible dans les mesures de latence pure du modèle.
- Le format demandé : exiger un JSON strict ou un schéma contraint ajoute une vérification à chaque jeton produit.
Notez qu'une rupture technologique se prépare sur ce terrain. Les modèles à diffusion, qui génèrent plusieurs fragments en parallèle au lieu d'écrire mot à mot, dépassent déjà le millier de jetons par seconde, comme nous l'expliquions dans notre décryptage des LLM à diffusion. Ils ne règlent pas la question du prefill, mais ils effacent celle du decode.
Ce que la latence change pour votre site et votre visibilité
Vous n'avez aucune prise sur la vitesse de ChatGPT, Gemini ou Perplexity quand ils répondent à un internaute. En revanche, deux conséquences vous concernent directement.
Première conséquence, sur vos propres outils. Si vous avez déployé un assistant sur votre site, un agent de qualification de leads ou un robot de réponse aux avis, chaque seconde de latence se paye en taux d'abandon. Les leviers sont connus et peu coûteux : préfixe de prompt stable pour profiter du cache, contexte réduit à l'essentiel, niveau de raisonnement ajusté à la tâche, et modèle léger pour les tâches simples.
Seconde conséquence, sur votre contenu. Quand un moteur génératif consulte votre page pour construire une réponse, il la découpe et la lit sous contrainte de temps et de budget de calcul. Un contenu clair, segmenté et dont l'information essentielle figure tôt dans la page est mécaniquement plus facile à exploiter. Notre propre étude sur les citations de ChatGPT montre que 44,2 % des citations proviennent du premier tiers d'un article. La latence côté moteur et la structure côté éditeur sont les deux faces d'une même contrainte.
C'est précisément ce que nous travaillons avec nos clients dans nos missions d'agence GEO, et ce que nous transmettons en formation GEO certifiée Qualiopi.
Ce qu'il faut retenir
La latence d'un LLM est le délai avant le premier mot, et elle se joue pendant la phase de prefill, quand le modèle lit tout ce que vous lui avez envoyé. La vitesse d'écriture, mesurée en jetons par seconde, est un indicateur distinct qui dépend de la bande passante mémoire. Les deux ne vont pas ensemble : Claude Opus 5.5 démarre en 0,12 seconde, Grok 4.7 en réflexion maximale en 9,32 secondes, soit 78 fois plus, et ce n'est pas une question de qualité mais de réglage.
Trois leviers sont à votre portée si vous exploitez une API : placer la partie stable de vos instructions en tête pour que le prompt caching se déclenche et vous fasse économiser jusqu'à 95 % sur les jetons relus, ajuster le niveau de raisonnement à la difficulté réelle de la tâche, et réduire le contexte transmis à chaque appel.
Votre assistant en ligne met trop de temps à répondre, ou votre facture d'API vous surprend ? Demandez un audit technique à notre équipe : nous commençons toujours par mesurer avant de changer quoi que ce soit.
Et vous, combien de secondes votre IA préférée met-elle à démarrer sur une question simple ? Dites-le nous en commentaire !Sources et références
- Artificial Analysis - Comparatif indépendant des modèles : latence avant premier jeton, débit et coût par tâche (consulté le 2 octobre 2026)
- OpenAI - Prompt caching, remise sur les jetons d'entrée et durée de conservation du cache (documentation officielle)
- Anthropic - Prompt caching, multiplicateurs d'écriture et de lecture, minimums par modèle (documentation officielle)
- Google - Gemini API, mise en cache implicite et explicite du contexte (documentation officielle)
- Hugging Face - Prefill and Decode for Concurrent Requests, Benjamin Merkel, TNG Technology Consulting (16 avril 2025)
- Exchange-Rates.org - Taux de change EUR vers USD, 1 EUR = 1,1331 USD au 30 septembre 2026
- Digital-m - 44 % des citations de ChatGPT viennent du premier tiers de vos articles (étude maison)
Questions fréquentes sur la latence des LLM
Pourquoi ChatGPT est-il parfois beaucoup plus lent que d'habitude ?
Trois causes se cumulent le plus souvent. Le modèle sélectionné peut activer un mode de raisonnement qui consomme des jetons de réflexion avant d'écrire. La conversation peut être devenue très longue, ce qui allonge la phase de lecture à chaque tour. Enfin, aux heures de forte affluence, les requêtes sont regroupées par lots côté serveur, ce qui augmente le débit global mais allonge l'attente de chacun.
Quelle est la différence entre latence et jetons par seconde ?
La latence mesure le silence avant le premier mot, les jetons par seconde mesurent la vitesse de déroulement du texte ensuite. Les deux sont indépendants. GPT-6 Astra démarre en 0,23 seconde mais écrit à 51 jetons par seconde, DeepSeek V4.1 Flash démarre en 0,99 seconde et écrit à 209 jetons par seconde. Sur une réponse longue, c'est le second qui termine en premier.
Le prompt caching fonctionne-t-il automatiquement ?
Cela dépend du fournisseur. Chez OpenAI, il est activé par défaut sur les modèles compatibles, à partir de 1 024 jetons. Chez Google, la mise en cache implicite est active par défaut sur Gemini 2.5 et au-delà. Chez Anthropic en revanche, il faut déclarer explicitement les portions à mettre en cache. Dans tous les cas, le cache ne se déclenche que si le début du message est rigoureusement identique d'un appel à l'autre.
Faire tourner un modèle en local réduit-il la latence ?
Pas forcément. Vous supprimez le temps de trajet réseau et l'attente liée à la charge du service, ce qui aide sur les très petites requêtes. Mais la phase de décodage dépend de la bande passante mémoire de votre machine, généralement très inférieure à celle d'un serveur professionnel. Un modèle léger comme un Mistral ou un Qwen compact en local peut répondre vite, un gros modèle quantifié sur un ordinateur portable sera lent.
Comment réduire la latence de mon assistant IA sans changer de modèle ?
Quatre actions donnent des résultats immédiats. Placez vos instructions fixes en tête de prompt pour déclencher le cache. Limitez l'historique transmis aux derniers échanges utiles plutôt qu'à toute la conversation. Abaissez le niveau de raisonnement sur les tâches simples. Enfin, affichez la réponse en flux continu, le fameux streaming, pour que l'utilisateur voie le texte apparaître au lieu d'attendre devant un écran vide.