
LLM multimodal : comment l'IA voit-elle une image ?
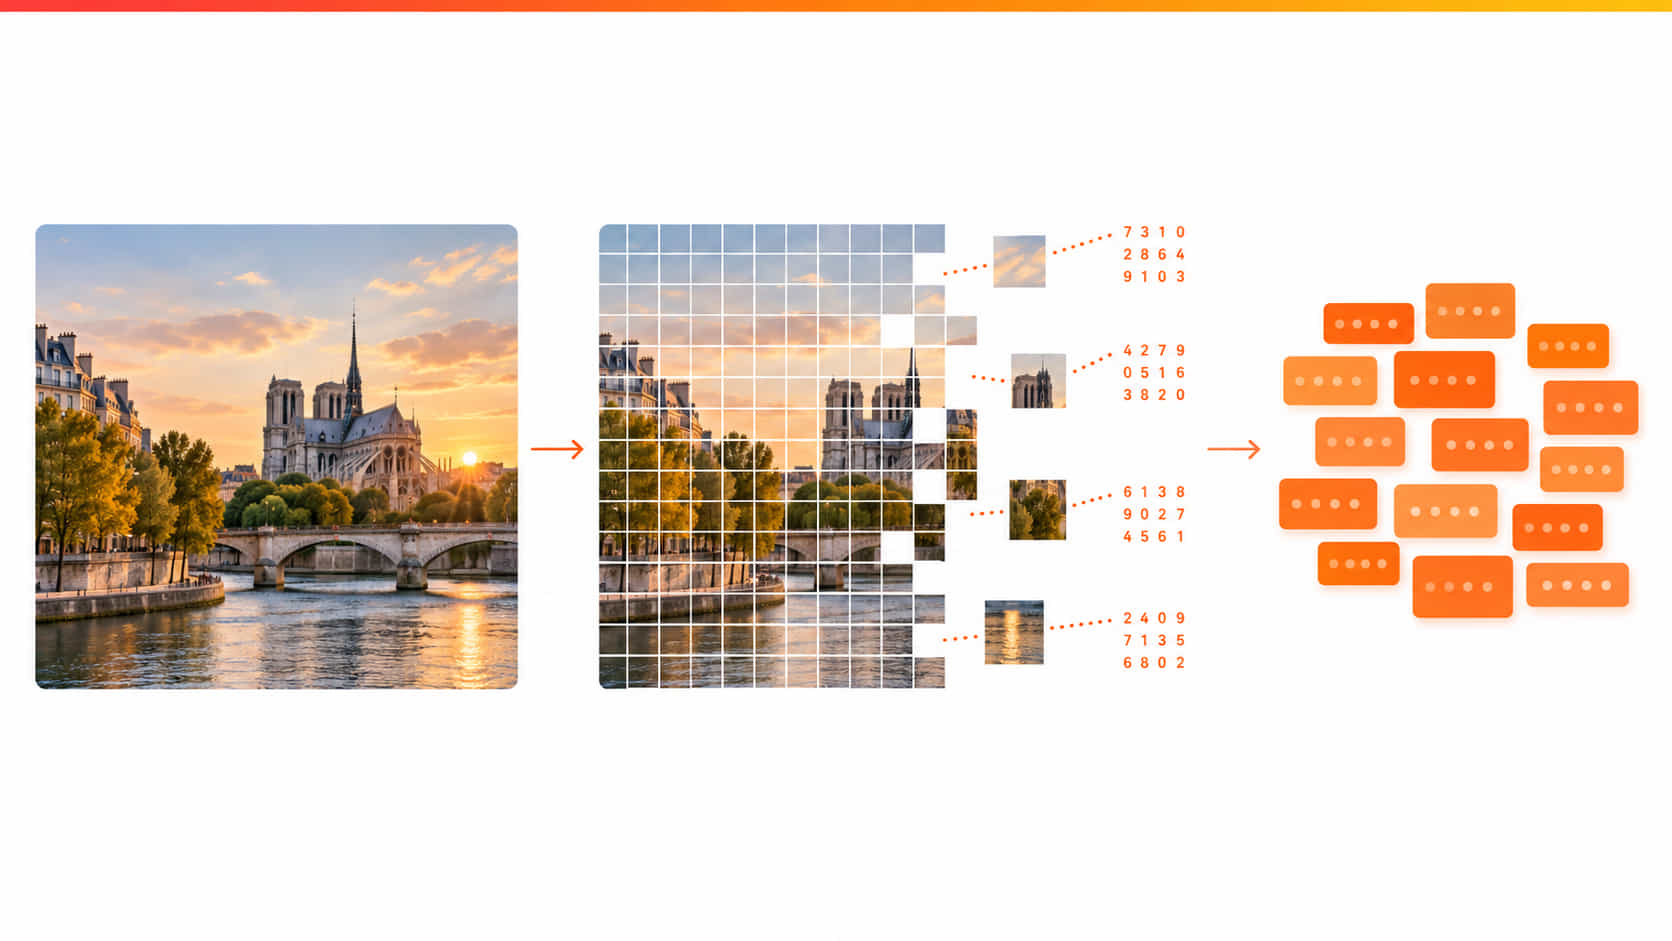
Une photo de smartphone coûte 2 451 tokens à GPT-5.5 et 6 636 tokens à Claude Opus 4.7. Exactement la même image, un écart de 2,7 fois sur la facture. Cet écart ne vient pas d'une différence de qualité, mais d'une différence de méthode : chaque éditeur découpe les images autrement avant de les donner à lire à son modèle. Comprendre ce découpage, c'est comprendre pourquoi une IA lit sans peine un graphique complexe mais se trompe en comptant six stylos sur une table. Cet article décompose le trajet d'une image dans un LLM multimodal, du pixel au mot, avec les coûts réels, les scores de septembre 2026 et les limites que les éditeurs eux-mêmes reconnaissent.
-
- Dernière modification
19 septembre 2026 - 9 minutes de lecture
Un LLM multimodal ne voit pas une image, il la découpe
Un LLM multimodal est un modèle de langage capable de traiter autre chose que du texte : images, et selon les cas audio ou vidéo. Il ne « regarde » pourtant jamais une photo au sens humain. Il la découpe en petits carrés réguliers, appelés patches (littéralement « morceaux »), les convertit en suites de nombres, puis les insère dans le flux de texte comme s'il s'agissait de mots.
Le chiffre de référence est simple à retenir : une image de 224 x 224 pixels découpée en patches de 14 x 14 pixels produit exactement 256 tokens de patch. Un token, c'est l'unité de base que manipule un modèle de langage, l'équivalent d'un fragment de mot. Autrement dit, pour la machine, une petite image équivaut à peu près à un paragraphe de tokens.
Chaque patch devient un vecteur de nombres, ce qu'on appelle un embedding. Ces vecteurs vivent dans le même espace mathématique que ceux des mots. C'est tout le tour de force : une fois traduits, un bout de ciel bleu et le mot « ciel » sont deux points voisins que le modèle peut comparer.
Les trois étages d'un LLM multimodal
Tous les LLM multimodaux de 2026, propriétaires comme ouverts, reposent sur la même architecture en trois étages : un encodeur visuel, un connecteur, un décodeur de texte. Le détail change, jamais le principe.
Étage 1 : l'encodeur visuel
L'encodeur transforme les patches en vecteurs. Les familles dominantes sont CLIP ViT-L/14 (24 couches, entrées de 224 ou 336 pixels), SigLIP, une variante plus économe en données, et Pixtral-ViT, l'encodeur de 1 milliard de paramètres développé par Mistral AI pour accepter des résolutions variables. Le sigle ViT signifie Vision Transformer : c'est la même architecture transformer que pour le texte, appliquée à des carrés d'image.
Étage 2 : le connecteur
Le connecteur projette les vecteurs visuels dans l'espace des tokens du modèle de langage. Trois stratégies coexistent. La projection simple, un petit réseau à deux couches qui transforme chaque patch en token, utilisée par LLaVA et Pixtral. Le Q-Former, qui compresse des centaines de patches en 32 tokens seulement, utilisé par BLIP-2. Et l'attention croisée, qui insère de nouvelles couches directement dans le modèle de langage gelé, l'approche de Flamingo.
Étage 3 : le décodeur
Le décodeur est un modèle de langage classique : Llama, Qwen, Mistral. Il reçoit un flux mélangé de tokens de texte et de tokens d'image et génère sa réponse mot à mot, sans savoir lesquels viennent d'une photo. Pour lui, tout est token.
Ce que coûte vraiment une image à une IA

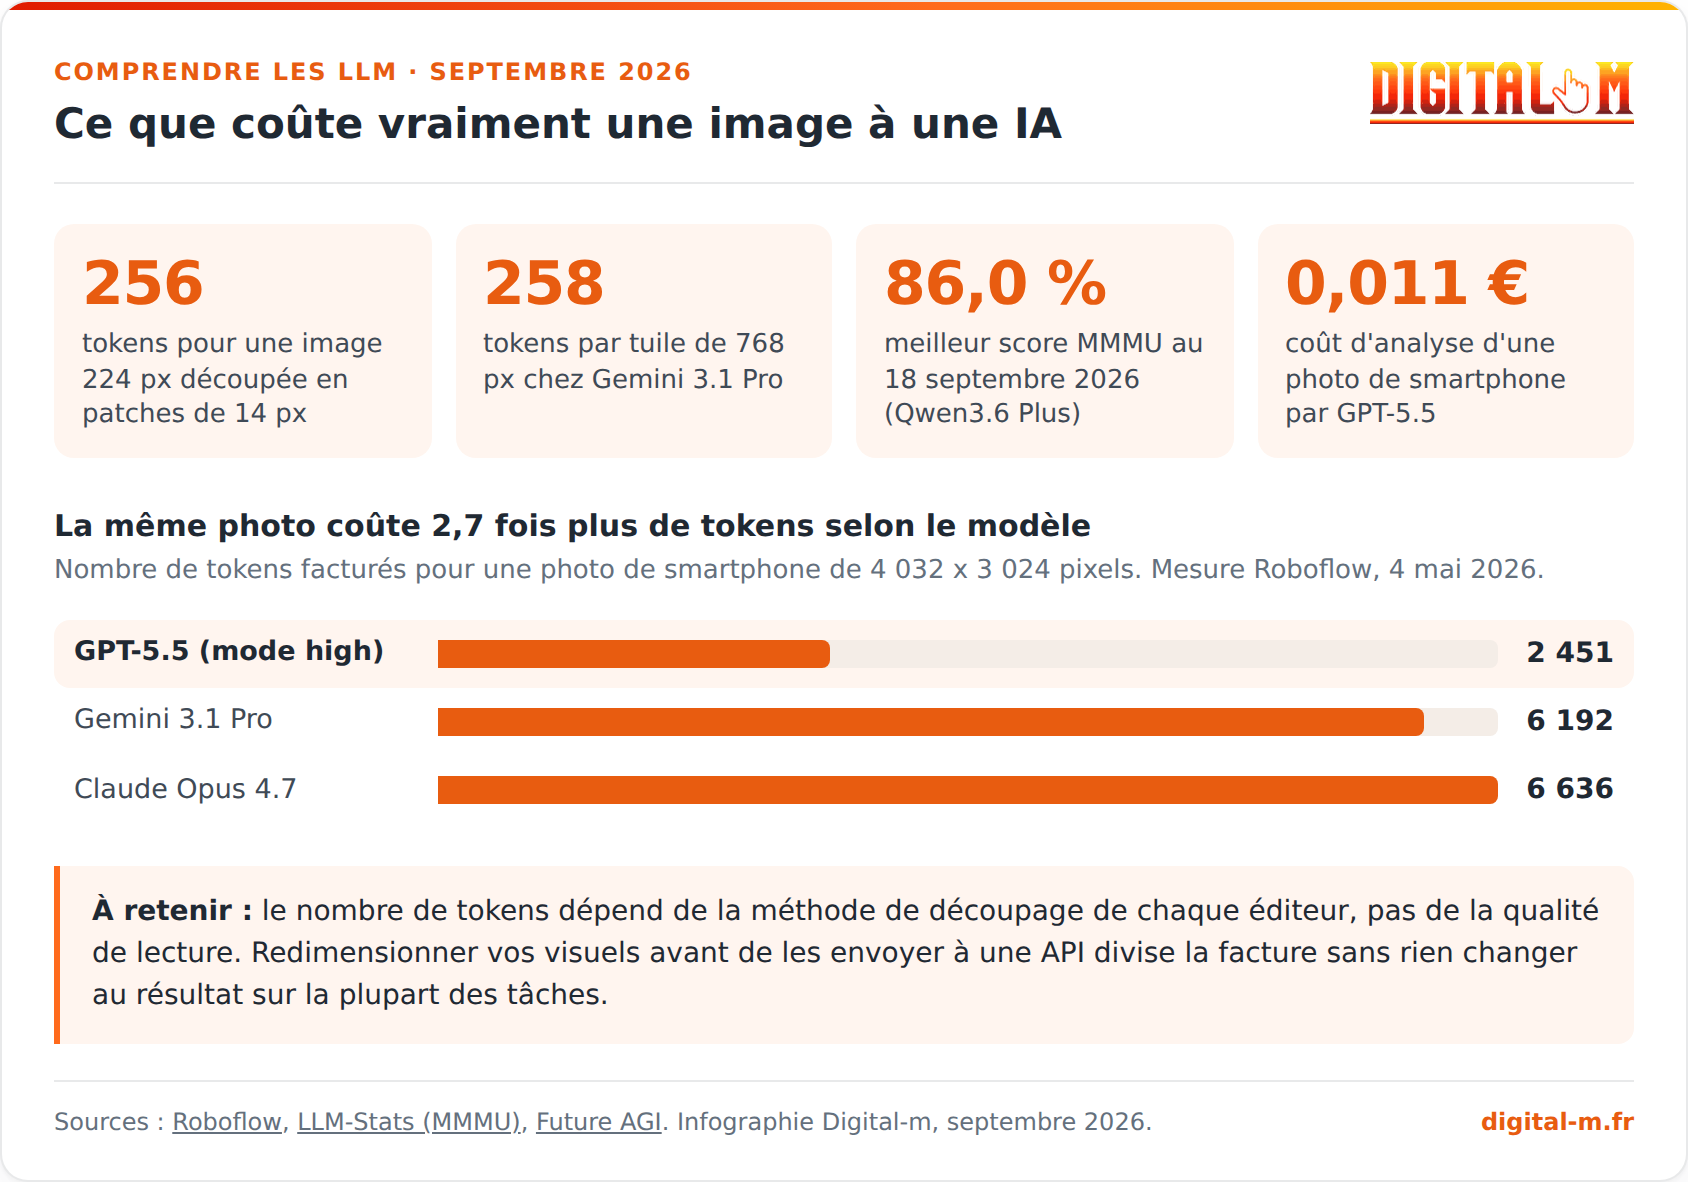
- 256 tokens pour une image 224 px découpée en patches de 14 px
- 258 tokens par tuile de 768 px chez Gemini 3.1 Pro
- 86,0 % meilleur score MMMU au 18 septembre 2026 (Qwen3.6 Plus)
- 0,011 € coût d'analyse d'une photo de smartphone par GPT-5.5
La même photo coûte 2,7 fois plus de tokens selon le modèle
Nombre de tokens facturés pour une photo de smartphone de 4 032 x 3 024 pixels. Mesure Roboflow, 4 mai 2026.
À retenir : le nombre de tokens dépend de la méthode de découpage de chaque éditeur, pas de la qualité de lecture. Redimensionner vos visuels avant de les envoyer à une API divise la facture sans rien changer au résultat sur la plupart des tâches.
Télécharger l'infographie (PNG)
Combien coûte une image en tokens ?
Le coût d'une image dans un LLM multimodal dépend entièrement de la méthode de découpage de l'éditeur, et les trois grands modèles en utilisent trois différentes. Voici les règles publiées, mesurées par Roboflow le 4 mai 2026.
- GPT-5.5 (OpenAI) : découpage en patches de 32 x 32 pixels, plafonné à 2 500 patches ou 2 048 pixels de côté. Tarif de 4,36 € le million de tokens.
- Claude Opus 4.7 (Anthropic) : calcul par la surface, largeur multipliée par hauteur puis divisée par 750, côté long plafonné à 2 576 pixels. Même tarif de 4,36 € le million de tokens.
- Gemini 3.1 Pro (Google) : 258 tokens forfaitaires sous 384 pixels, puis découpage en tuiles de 768 x 768 pixels à 258 tokens chacune. Tarif de 1,74 € le million de tokens.
Sur une photo de smartphone de 4 032 x 3 024 pixels, cela donne 2 451 tokens pour GPT-5.5, 6 192 pour Gemini et 6 636 pour Claude. En euros, environ 0,011 € pour GPT-5.5, 0,011 € pour Gemini grâce à son tarif deux fois plus bas, et 0,029 € pour Claude. L'écart paraît dérisoire sur une image. Sur un catalogue de 40 000 fiches produits à analyser, il représente plusieurs centaines d'euros.
Chez Digital-m, nous rencontrons régulièrement ce cas sur des projets e-commerce : le simple fait de redimensionner les visuels à 1 024 pixels de côté avant l'appel à l'API divise la note par trois, sans dégrader la génération des descriptions ni celle des attributs alt. C'est d'ailleurs le même réflexe qui sert le SEO des images : un visuel bien dimensionné coûte moins cher partout.
Ce que les LLM multimodaux réussissent, et ce qu'ils ratent encore
Les LLM multimodaux excellent sur la lecture de documents et faiblissent sur le raisonnement spatial. Pixtral Large dépasse 90 % sur DocVQA (questions sur des documents scannés) et 88 % sur ChartQA (lecture de graphiques), tandis que NVLM 1.0 atteint 92 % sur OCRBench, le test de reconnaissance de caractères. Lire une facture, un tableau ou un ticket de caisse est devenu une tâche résolue.
Les échecs se concentrent ailleurs, et ils sont assez systématiques pour être anticipés.
- Le comptage : au-delà de cinq ou six objets identiques, le taux d'erreur grimpe. Le découpage en patches fragmente les objets, le modèle recolle mal.
- Les relations spatiales : « à gauche de », « derrière », « sous » restent des points faibles récurrents, car la position d'un patch est encodée de façon approximative.
- Le détail fin sur grande image : un numéro de série minuscule sur une photo pleine résolution disparaît au redimensionnement. Recadrez avant d'envoyer.
- L'écriture manuscrite dégradée : bien meilleure qu'en 2023, mais toujours en retrait sur les documents anciens ou photographiés de travers.
- L'hallucination visuelle : interrogé sur un élément absent de l'image, un modèle a tendance à en décrire un plausible plutôt qu'à dire qu'il ne le voit pas.
Où en sont GPT, Gemini, Qwen et les modèles ouverts ?
Au 18 septembre 2026, le classement MMMU, le test de référence des LLM multimodaux, place Qwen3.6 Plus en tête avec 86,0 %, devant les trois variantes de GPT-5.1 à 85,4 % et GPT-5 à 84,2 %. Le benchmark compte 11 500 questions de niveau universitaire sur six disciplines, et la moyenne des 66 modèles classés s'établit à 67,9 %.
Le fait marquant de cette édition, c'est la position d'un modèle chinois au sommet, et la densité de la famille Qwen dans le top 10 (quatre entrées). Du côté ouvert, Mistral AI tient sa place avec Pixtral Large, bâti sur un encodeur de 1 milliard de paramètres et un décodeur de 123 milliards, doté d'une fenêtre de contexte de 128 000 tokens. Meta avec Llama Vision et les déclinaisons de Qwen-VL complètent l'offre auto-hébergeable.
Un avertissement s'impose sur ces scores : MMMU teste la connaissance disciplinaire et le raisonnement, pas la fiabilité sur vos documents à vous. Un modèle à 86 % peut se révéler moins bon qu'un modèle à 80 % sur vos bons de livraison. Testez sur votre propre échantillon avant de trancher.
Multimodalité native ou greffée : pourquoi la différence compte
Un LLM multimodal natif est entraîné dès le départ sur du texte et des images mélangés, tandis qu'un modèle « greffé » ajoute un encodeur visuel à un modèle de texte déjà entraîné. La différence se voit sur les tâches qui exigent d'aller et venir entre les deux, comme décrire un schéma puis raisonner dessus.
L'approche greffée a un effet secondaire documenté, l'oubli catastrophique : en apprenant à voir, le modèle perd en compétences purement textuelles. Les équipes de NVLM 1.0 corrigent ce défaut en mélangeant des données texte de haute qualité à l'entraînement multimodal, et rapportent un gain de 4,3 points en mathématiques et en programmation sur texte seul. C'est une bonne illustration d'un principe général : ajouter une capacité à un modèle se paie ailleurs, sauf à recomposer soigneusement le jeu d'entraînement.
Pour l'utilisateur, la conséquence est pratique : si votre cas d'usage mélange constamment lecture d'image et rédaction, privilégiez un LLM multimodal natif. S'il s'agit d'extraire des données d'un document puis de les envoyer dans un tableur, un modèle greffé spécialisé document fera très bien l'affaire, souvent moins cher.
Cinq usages concrets pour une PME
La lecture d'images par LLM multimodal est devenue assez fiable et assez bon marché pour entrer dans des processus ordinaires. Voici cinq usages que nous voyons fonctionner sur le terrain, classés du plus simple au plus ambitieux.
- Attributs alt automatiques : générer les textes alternatifs d'un catalogue d'images à partir des visuels eux-mêmes, avec relecture humaine. Utile en accessibilité comme en référencement.
- Extraction de documents : factures fournisseurs, bons de commande, notes de frais. Le modèle sort un JSON structuré, votre outil comptable l'avale.
- Contrôle qualité des fiches produits : vérifier que la photo correspond bien à la référence, repérer les visuels flous, les fonds non uniformes, les watermarks oubliés.
- Modération et tri de contenus : classer automatiquement les photos envoyées par des clients ou des franchisés avant publication.
- Analyse de captures d'écran : faire lire à l'IA vos tableaux de bord pour en tirer un commentaire écrit, plutôt que de ressaisir les chiffres à la main.
Un point de méthode, valable pour ces cinq usages : mesurez son taux d'erreur sur un échantillon de cinquante cas avant d'automatiser quoi que ce soit. La vision par IA se rapproche de la génération d'images sur un point, elle produit toujours un résultat plausible, y compris quand il est faux.
Ce qu'il faut retenir
Un LLM multimodal ne voit pas, il découpe une image en patches, les transforme en vecteurs et les insère dans son flux de tokens. Une image de 224 pixels vaut 256 tokens, une photo de smartphone entre 2 451 et 6 636 tokens selon l'éditeur, soit de 0,011 € à 0,029 € par image.
L'architecture est partout la même : encodeur visuel, connecteur, décodeur de texte. Les LLM multimodaux lisent aujourd'hui les documents mieux que beaucoup d'humains pressés, avec plus de 90 % sur DocVQA, mais comptent mal et se repèrent mal dans l'espace. Au 18 septembre 2026, Qwen3.6 Plus domine le classement MMMU à 86,0 %, GPT-5.1 suit à 85,4 %, et l'écosystème ouvert reste une option crédible avec Pixtral et Qwen-VL.
Vous envisagez d'automatiser la lecture de vos visuels ou de vos documents ? Commencez par chiffrer le volume et tester deux modèles sur un échantillon réel. L'équipe Digital-m peut cadrer ce test avec vous, et notre formation GEO certifiée Qualiopi forme vos équipes à manier ces outils sans se faire piéger par leurs angles morts. Parlons de votre cas.
Sur quelle tâche visuelle aimeriez-vous mettre une IA au travail dès demain ? Dites-le nous en commentaire !Sources et références
- Roboflow - What does it cost to process an image with a vision model? (4 mai 2026)
- Future AGI - How Multimodal LLMs Work in 2026: Vision Encoders, Fusion, and Decoders
- LLM-Stats - MMMU Leaderboard (mise à jour du 18 septembre 2026)
- MMMU Benchmark - A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark
- Jina AI - Vision Encoders in Vision-Language Models: A Survey
- Mistral AI - Models Overview (documentation officielle)
- Google - Gemini Developer API pricing (consulté en septembre 2026)
Questions fréquentes sur les LLM multimodaux
Quelle différence entre un LLM multimodal et un générateur d'images ?
Le sens de circulation est inversé. Un LLM multimodal prend une image en entrée et produit du texte en sortie : il décrit, extrait, analyse. Un générateur d'images fait le contraire, il part d'une description écrite pour fabriquer un visuel. Certains modèles de 2026 font les deux, mais ce sont bien deux chaînes de traitement distinctes.
Combien de tokens coûte une image envoyée à une IA ?
Entre 258 tokens pour une vignette et plusieurs milliers pour une photo pleine résolution. Sur une image de 4 032 x 3 024 pixels mesurée par Roboflow en mai 2026 : 2 451 tokens pour GPT-5.5, 6 192 pour Gemini 3.1 Pro, 6 636 pour Claude Opus 4.7. Redimensionner à 1 024 pixels de côté réduit fortement la facture.
Quel est le meilleur LLM multimodal en septembre 2026 ?
Sur le classement MMMU du 18 septembre 2026, Qwen3.6 Plus arrive premier avec 86,0 %, suivi de GPT-5.1 à 85,4 % et de GPT-5 à 84,2 %. Ces scores mesurent le raisonnement disciplinaire, pas la fiabilité sur vos propres documents. Un test sur un échantillon de vos fichiers reste indispensable avant de choisir.
Pourquoi une IA se trompe-t-elle en comptant des objets ?
Parce que l'image est découpée en patches indépendants avant d'être lue. Un même objet peut chevaucher plusieurs patches, et le modèle n'a pas de mécanisme de comptage explicite : il estime à partir de ce qu'il a vu pendant son entraînement. Au-delà de cinq ou six éléments identiques, le taux d'erreur devient significatif.
Peut-on faire tourner un modèle multimodal sur son propre serveur ?
Oui. Les familles Qwen-VL, Pixtral de Mistral AI et Llama Vision de Meta sont disponibles en poids ouverts et s'exécutent sur une machine équipée d'un GPU correct. Le coût bascule de l'appel d'API vers le matériel et l'exploitation, un arbitrage qui devient intéressant à partir de quelques dizaines de milliers d'images par mois.