Prompt système : qui donne vraiment ses ordres à l'IA ?
Quatre mille mots. C'est la longueur du texte que Claude Opus 5.5 lit avant même de voir votre question, publié par Anthropic le 22 septembre 2026. Ce texte porte un nom : le prompt système. C'est lui qui fixe le ton, les refus, le format des réponses et jusqu'à la date du jour. Chez OpenAI, Google, Mistral ou xAI, le même mécanisme existe sous d'autres appellations, mais presque personne ne le rend public. Comprendre le prompt système, c'est comprendre pourquoi deux IA répondent de façon opposée à une question identique, pourquoi votre chatbot ignore parfois vos consignes, et pourquoi certaines pages sont citées quand d'autres restent invisibles.
-
- Dernière modification
19 octobre 2026 - 9 minutes de lecture
Le prompt système, c'est quoi exactement ?
Un prompt système est un bloc d'instructions écrit par l'éditeur de l'IA, inséré automatiquement avant votre message, et relu intégralement à chaque nouvelle requête. Vous ne le voyez jamais. Le modèle, lui, le lit toujours en premier.
Le terme anglais « system prompt » désigne exactement la même chose. Dans les interfaces techniques, ce bloc occupe un emplacement réservé, distinct du message de l'utilisateur. OpenAI l'appelle désormais le message developer, Google le nomme system_instruction dans son API Gemini, Mistral parle du rôle system. Trois noms, un seul mécanisme.
Concrètement, ce bloc d'instructions remplit trois fonctions :
- Informer le modèle : la date du jour, le nom de la version active, les outils auxquels il a accès. Un LLM ne connaît rien de tout cela par lui-même, puisque son entraînement s'est arrêté des mois plus tôt.
- Cadrer le comportement : le ton, la longueur, l'usage des listes, la langue, les sujets à refuser. C'est la couche qui transforme un modèle brut en assistant utilisable.
- Fixer les limites : sécurité des mineurs, armes, code malveillant, reproduction d'œuvres protégées. Ces règles s'ajoutent à celles déjà apprises pendant la phase d'alignement du modèle.
Point essentiel à comprendre : ce texte ne modifie pas le modèle. Les poids restent identiques, le savoir appris reste le même, la date de coupure ne bouge pas. C'est une consigne de lecture, pas un réentraînement. D'où son intérêt pour les éditeurs : on peut le changer du jour au lendemain, sans toucher à l'infrastructure.
Horizon GEO • La newsletter
Comprendre les LLM, sans jargon
Chaque semaine, un mécanisme des IA expliqué simplement (contexte, embeddings, raisonnement…) et l’actu des modèles qui compte.
1 e-mail par semaine • Désinscription en 1 clic
Ce que contient le prompt système de Claude, le seul publié en entier
Anthropic est le seul grand éditeur à publier ses prompts système, modèle par modèle, sur sa documentation officielle. La liste couvre 22 versions, de Claude Haiku 3 jusqu'à Claude Opus 5.5. Une précision importante y figure : ce prompt s'applique à claude.ai et aux applications mobiles, pas à l'API.
La version publiée le 22 septembre 2026 pour Claude Opus 5.5 compte environ 4 000 mots, soit près de 25 000 caractères. On y trouve, pêle-mêle, le nom du modèle sélectionné (« The currently selected version of Claude is Claude Opus 5.5 »), une consigne de sobriété typographique (« Claude avoids over-formatting with bold emphasis, headers, lists, and bullet points »), des règles de refus sur les substances dangereuses, des instructions sur le bien-être de l'utilisateur et une neutralité imposée sur les sujets politiques.
Un texte qui a été multiplié par onze en deux ans
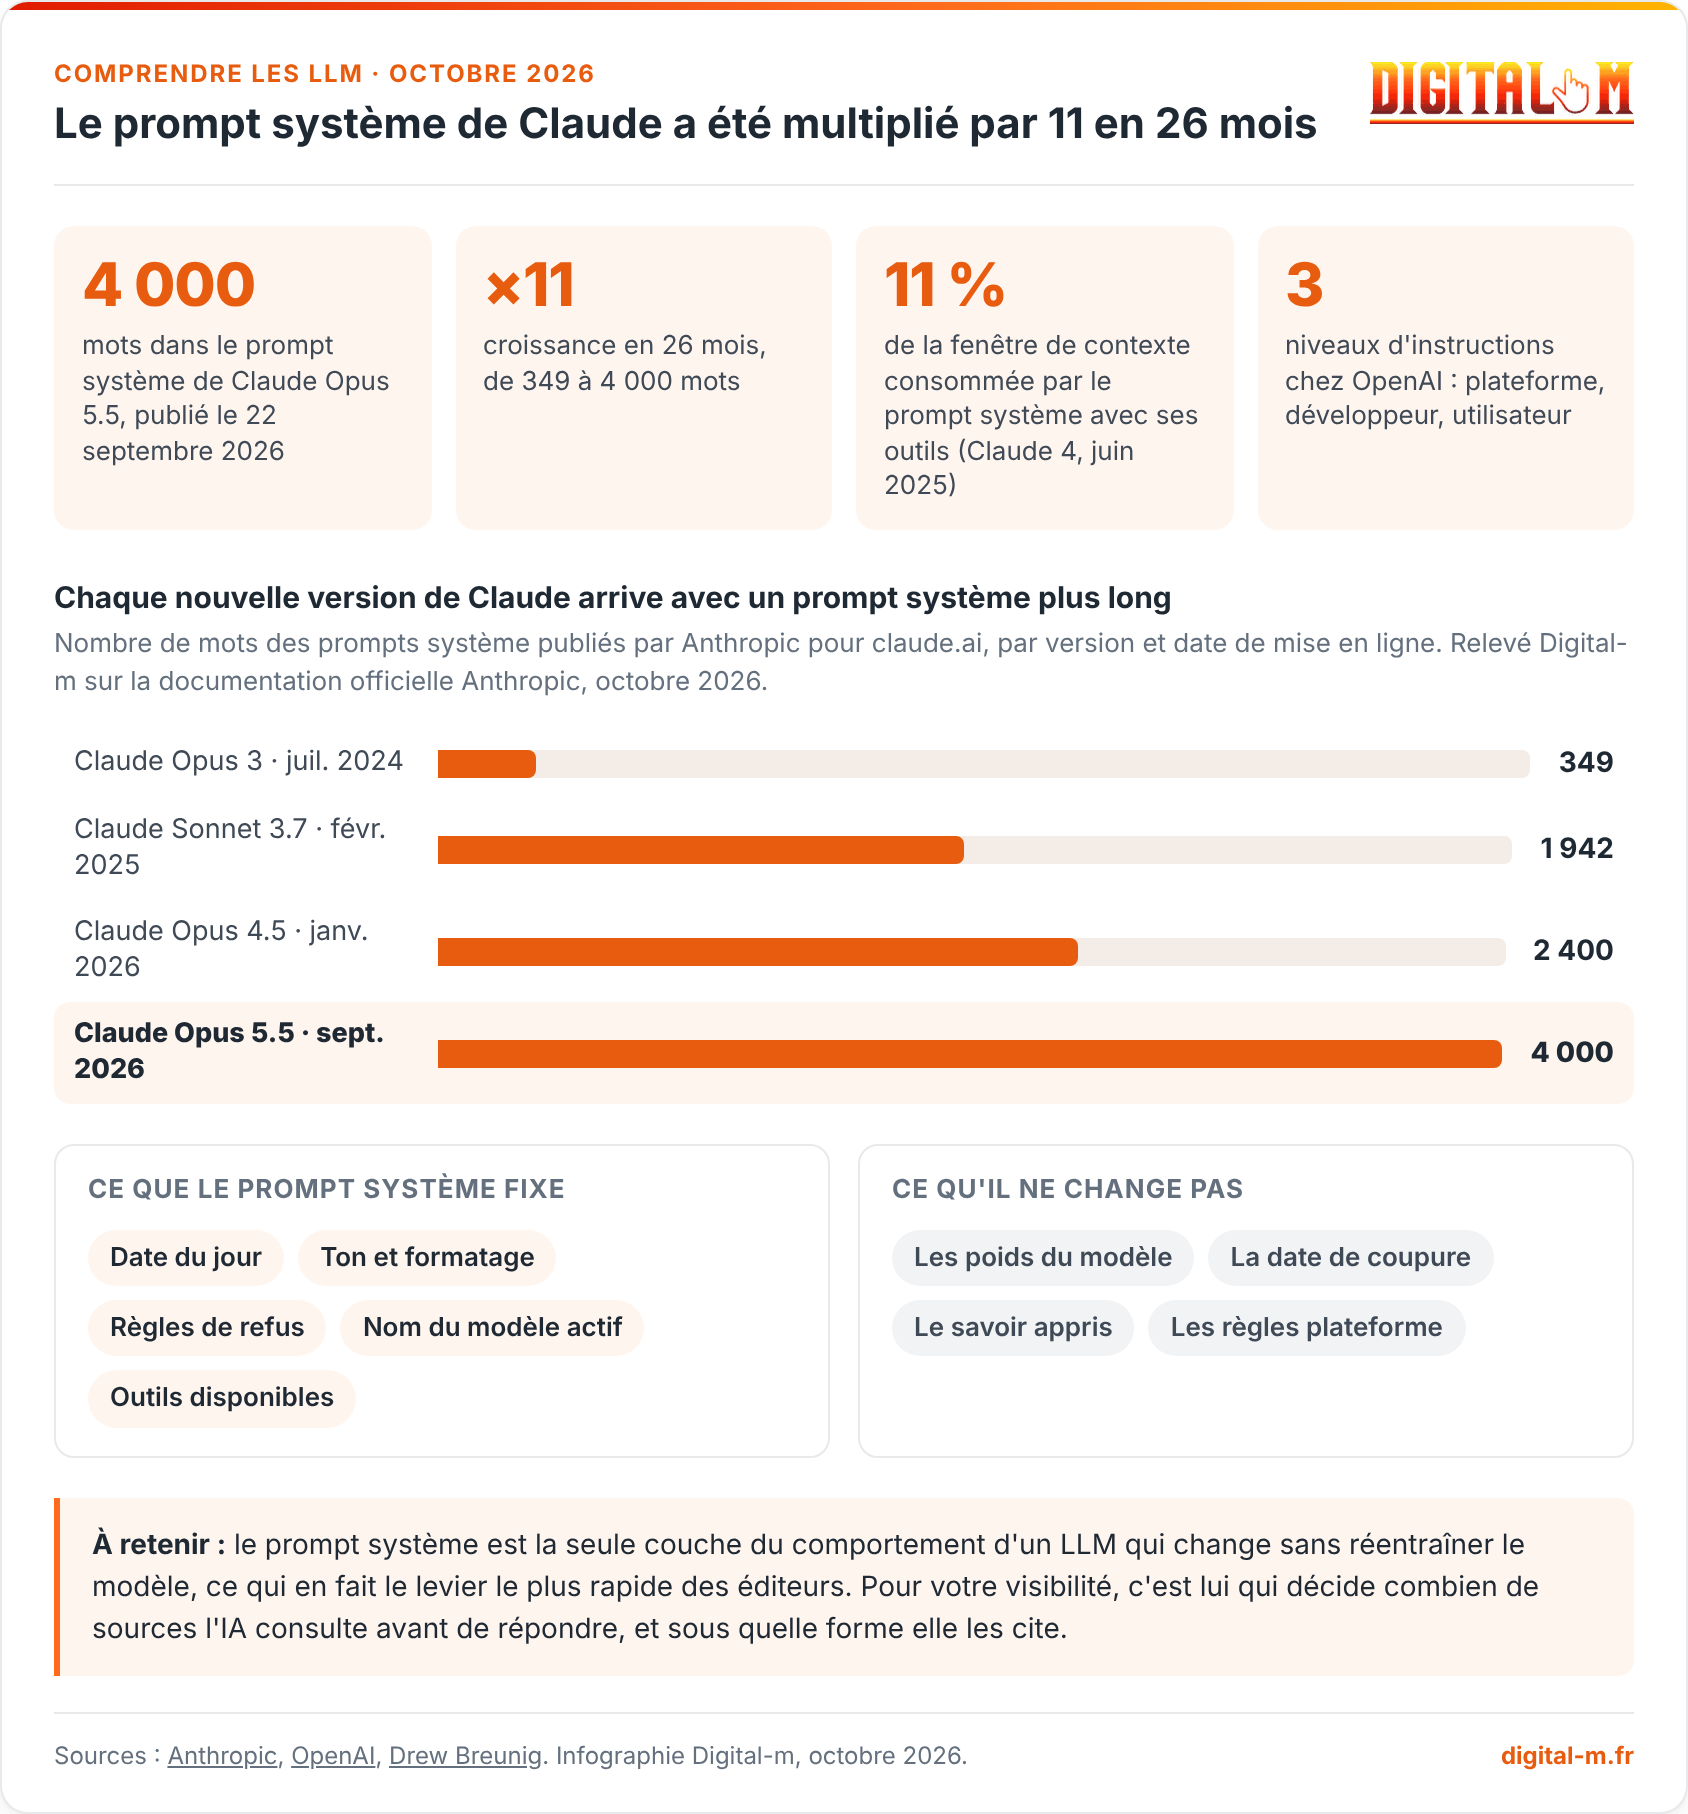
En comparant les versions datées publiées par Anthropic, la trajectoire est nette. Le prompt système de Claude Opus 3, mis en ligne le 12 juillet 2024, tenait en 349 mots. Celui de Claude Sonnet 3.7, daté du 24 février 2025, en comptait 1 942. Celui de Claude Opus 4.5, mis à jour le 18 janvier 2026, tournait autour de 2 400. Deux ans et deux mois plus tard, on atteint 4 000 mots.
Cette inflation raconte quelque chose : à mesure que les modèles gagnent en capacité, les éditeurs ajoutent des garde-fous (des règles de sécurité qui bornent les réponses) plutôt que de réentraîner. Il devient la rustine la plus rapide du secteur.
Le prompt système de Claude a été multiplié par 11 en 26 mois

- 4 000 mots dans le prompt système de Claude Opus 5.5, publié le 22 septembre 2026
- ×11 croissance en 26 mois, de 349 à 4 000 mots
- 11 % de la fenêtre de contexte consommée par le prompt système avec ses outils (Claude 4, juin 2025)
- 3 niveaux d'instructions chez OpenAI : plateforme, développeur, utilisateur
Chaque nouvelle version de Claude arrive avec un prompt système plus long
Nombre de mots des prompts système publiés par Anthropic pour claude.ai, par version et date de mise en ligne. Relevé Digital-m sur la documentation officielle Anthropic, octobre 2026.
Ce que le prompt système fixe
Ce qu'il ne change pas
À retenir : le prompt système est la seule couche du comportement d'un LLM qui change sans réentraîner le modèle, ce qui en fait le levier le plus rapide des éditeurs. Pour votre visibilité, c'est lui qui décide combien de sources l'IA consulte avant de répondre, et sous quelle forme elle les cite.
Télécharger l'infographie (PNG)
Pourquoi OpenAI, Google et Mistral ne publient pas le leur
Aucun autre grand éditeur ne publie son prompt système intégral. OpenAI a choisi une autre voie : le Model Spec, un document public qui décrit les principes de comportement attendus sans livrer le texte exact des instructions. Publié le 12 février 2025 sous licence CC0, il est depuis mis à jour en continu, la version en ligne portant l'identifiant 2026-08-18.
Google documente le paramètre system_instruction de son API Gemini et donne des exemples, mais pas celui de l'application Gemini grand public. Mistral AI publie des recommandations de rédaction détaillées pour le rôle system, sans dévoiler celui du Chat. Du côté de xAI, la démarche est née d'une crise : après une modification non autorisée du prompt système du robot Grok sur X, le 14 mai 2025, qui a fait dériver ses réponses pendant plusieurs heures, l'entreprise a publié ses prompts système sur GitHub dans le dépôt xai-org/grok-prompts.
Le marché gris des prompts système
Faute de publication officielle, des dépôts communautaires compilent les prompts système extraits par ingénierie inverse. On y trouve des versions attribuées à GPT-6 Astra, Gemini 3.8 Flash, Grok ou Kimi. Ces documents circulent largement et servent de référence dans la communauté, mais attention : ils ne sont pas vérifiés par les éditeurs et peuvent être incomplets ou périmés. Nous ne les citons ici que pour signaler leur existence, pas comme source fiable.
Cette opacité n'est pas qu'une question de secret industriel. Un prompt système connu est un prompt contournable : les techniques de prompt injection s'appuient précisément sur la connaissance des consignes à neutraliser.
Hiérarchie des instructions : qui gagne quand les ordres se contredisent ?
Quand une instruction de l'éditeur contredit celle d'un développeur, et que l'utilisateur en demande une troisième, le modèle applique une règle de priorité explicite. OpenAI l'appelle la chain of command (chaîne de commandement) et la documente dans son Model Spec : les instructions de la plateforme passent avant celles du développeur, qui passent avant celles de l'utilisateur.
La documentation technique d'OpenAI le confirme sans ambiguïté : les messages developer sont « prioritized ahead of user messages ». C'est exactement ce qui explique un agacement très courant chez nos clients : vous demandez à un assistant d'entreprise de répondre en trois phrases, il en écrit dix, parce que le prompt système configuré en amont lui impose un format détaillé.
| Niveau | Qui l'écrit | Exemple concret | Peut être contredit par |
|---|---|---|---|
| Plateforme | L'éditeur du modèle | Refus sur les armes, sécurité des mineurs | Personne |
| Développeur | L'entreprise qui intègre l'IA | « Tu es l'assistant de la société X, réponds en français » | La plateforme |
| Utilisateur | Vous, dans la conversation | « Réponds plus court » | La plateforme et le développeur |
Chez Digital-m, nous auditons régulièrement des chatbots de PME dont les consignes métier sont écrites dans le mauvais niveau. Résultat : des instructions commerciales placées côté utilisateur, que n'importe quel visiteur peut écraser d'une phrase. Le correctif tient en une migration vers le message développeur, et le taux de réponses hors sujet s'effondre.
Ce que le prompt système coûte à chaque message
Le prompt système est facturé comme n'importe quel autre texte. Il est relu, donc recompté en tokens (les unités de découpage du texte qui servent de base à la facturation), à chaque message de la conversation. Un bloc de 4 000 mots représente environ 5 300 tokens en anglais. Multipliez par le nombre d'échanges.
L'impact dépasse le budget. En juin 2025, l'analyse de Drew Breunig estimait que le prompt système de Claude 4, outils inclus, atteignait environ 23 000 tokens, soit plus de 11 % de la fenêtre de contexte disponible. Autant d'espace qui n'est plus utilisable pour vos documents. Si le sujet vous intéresse, nous avons détaillé ce que représente la fenêtre de contexte d'un LLM et pourquoi elle se remplit plus vite qu'on ne le croit.
Bonne nouvelle : comme ce bloc ne change pas d'un message à l'autre, tous les grands fournisseurs appliquent une remise sur sa relecture, via le cache de prompt. La partie stable du contexte coûte alors une fraction de son prix plein. Encore faut-il qu'il soit placé au tout début de la requête, et qu'il ne contienne rien de variable, pas même la date, sous peine de casser le cache à chaque appel.
Prompt système et GEO : ce qu'il décide de votre visibilité
Quand ChatGPT, Gemini ou Perplexity cherchent sur le web avant de répondre, c'est leur prompt système qui dicte le nombre de sources à consulter, la façon de les résumer et la forme des citations. Vous n'avez aucune prise sur ce texte, mais vous avez prise sur ce qu'il trouve.
Les écarts entre moteurs en découlent directement. Nos relevés montrent que ChatGPT cite en moyenne 15,4 sources par réponse contre 3,3 pour Gemini. Ce n'est pas une différence de modèle, c'est une différence de consigne. Être cité par le second demande donc une page bien plus nette que pour le premier.
Deux conséquences pratiques pour vos contenus. D'abord, l'ordre compte : l'étude Digital-m sur les citations montre que 44,2 % des citations de ChatGPT proviennent du premier tiers d'un article. Ensuite, la concision paie : dans son analyse de 1,2 million de résultats publiée le 16 février 2026, Kevin Indig décrit une IA qui lit « comme un rédacteur en chef pressé, pas comme un étudiant patient ». Une consigne qui impose un résumé court favorise mécaniquement les passages les plus autonomes.
C'est tout l'objet du travail mené par notre agence GEO : rendre une page lisible par une machine à qui l'on a ordonné d'aller vite.
Comment écrire un prompt système efficace pour votre entreprise
Si vous déployez un assistant interne, un chatbot de site ou un agent de support, vous écrivez votre propre prompt système. Les recommandations officielles de Mistral AI, parmi les plus détaillées du marché, convergent avec ce que nous observons sur le terrain.
Les sept règles qui fonctionnent
- Commencer par le rôle et la tâche : Mistral recommande littéralement la formule « You are a role, your task is to task ». Un modèle sans rôle improvise.
- Structurer en sections : le prompt doit être compréhensible par quelqu'un qui n'a aucun contexte. Utilisez du Markdown ou des balises de type XML pour délimiter les blocs.
- Bannir les termes flous : « mieux », « beaucoup », « rapidement » n'ont aucun sens mesurable. Donnez des seuils chiffrés.
- Éliminer les contradictions : sur un prompt long, préférez un arbre de décision à une liste d'exceptions qui s'annulent.
- Ne pas demander de compter : un LLM compte mal les mots, parce qu'il manipule des tokens. Fournissez plutôt des nombres de caractères en entrée.
- Limiter la longueur de sortie : chaque token généré coûte et ralentit la réponse. Bornez explicitement.
- Tester à chaque changement de modèle : un réglage calibré pour GPT-5.5 ne se comporte pas pareil sur GPT-6 Astra, Gemini 4 ou Mistral Large 4. Mistral le dit noir sur blanc : itérez et évaluez.
Les trois erreurs qui reviennent le plus souvent
La première consiste à empiler les interdictions. Un texte composé à 80 % de « ne fais pas » produit un assistant timide et évasif. Écrivez ce que vous voulez, pas seulement ce que vous craignez.
La deuxième est d'y glisser des données confidentielles. Un prompt système n'est pas un coffre-fort : il peut être extrait par des formulations habiles. Tarifs internes, marges, noms de clients n'y ont pas leur place.
La troisième est de l'écrire une fois pour toutes. Les modèles évoluent tous les deux à trois mois et le comportement dérive. Nos formations GEO certifiées Qualiopi consacrent un module entier à cette hygiène de maintenance, parce que c'est là que la plupart des projets d'IA interne se dégradent silencieusement.
Ce qu'il faut retenir
Le prompt système est le texte invisible que tout LLM lit avant votre question. Il fixe le ton, les refus, le format et les informations de contexte, sans modifier le modèle lui-même. Anthropic est le seul grand éditeur à le publier intégralement, avec 4 000 mots pour Claude Opus 5.5 le 22 septembre 2026, contre 349 mots en juillet 2024. OpenAI préfère documenter ses principes dans le Model Spec, Google et Mistral s'en tiennent à la documentation technique, xAI a publié les siens sur GitHub après l'incident du 14 mai 2025.
Trois points à garder en tête. Les instructions obéissent à une hiérarchie stricte, plateforme avant développeur avant utilisateur. Il consomme du contexte et du budget, jusqu'à 11 % de la fenêtre dans le cas mesuré sur Claude 4. Et dans les moteurs de réponse, c'est lui qui décide combien de sources sont lues avant qu'une réponse ne soit produite, ce qui place votre contenu dans une compétition dont vous ne voyez pas les règles.
Vous déployez un assistant IA, ou vous voulez savoir pourquoi vos pages ne remontent pas dans les réponses génératives ? Demandez votre audit GEO à Digital-m : nous passons au crible vos contenus, vos prompts système et votre visibilité réelle dans ChatGPT, Gemini, Perplexity et Mistral.
Et vous, avez-vous déjà lu le prompt système de l'assistant IA que vous utilisez tous les jours ? Dites-le nous en commentaire !Sources et références
- Anthropic - Claude system prompts, release notes officielles (consulté le 19 octobre 2026)
- Anthropic - Prompt système de Claude Opus 5.5 (22 septembre 2026)
- Anthropic - Prompt système de Claude Opus 3 (12 juillet 2024)
- OpenAI - Sharing the latest Model Spec (12 février 2025)
- OpenAI - Model Spec, version en ligne 2026-08-18
- OpenAI - Text generation, rôles developer, user et assistant (consulté le 19 octobre 2026)
- Google - Gemini API, paramètre system_instruction (consulté le 19 octobre 2026)
- Mistral AI - Prompting, bonnes pratiques du rôle system (consulté le 19 octobre 2026)
- xAI - Dépôt public grok-prompts sur GitHub (mai 2025)
- Drew Breunig - Comparing system prompts across Claude versions (3 juin 2025)
- Kevin Indig, Growth Memo - The science of how AI pays attention (16 février 2026)
- Digital-m - 44 % des citations de ChatGPT viennent du premier tiers de vos articles
Questions fréquentes sur le prompt système
Quelle est la différence entre un prompt système et un prompt utilisateur ?
Le prompt système est écrit en amont par l'éditeur ou par l'entreprise qui intègre l'IA, il s'applique à toute la conversation et il est relu à chaque message. Le prompt utilisateur est votre question ponctuelle. En cas de conflit, la documentation d'OpenAI indique que les instructions développeur passent avant celles de l'utilisateur.
Peut-on voir le prompt système de ChatGPT ou de Gemini ?
Non, pas officiellement. OpenAI publie son Model Spec, qui décrit les principes de comportement sans livrer le texte exact, et Google documente le paramètre system_instruction de son API sans dévoiler celui de l'application Gemini. Des dépôts communautaires diffusent des versions obtenues par ingénierie inverse, mais elles ne sont ni vérifiées ni garanties à jour.
Le prompt système consomme-t-il des tokens payants ?
Oui. Il est recompté à chaque appel, comme n'importe quel texte en entrée. Un prompt système de 4 000 mots représente environ 5 300 tokens en anglais. Les fournisseurs appliquent toutefois une remise via le cache de prompt sur la partie stable du contexte, à condition que le prompt système soit placé au tout début de la requête et qu'il ne contienne aucune valeur variable.
Quelle longueur doit faire un bon prompt système ?
Il n'existe aucune longueur officielle recommandée. Pour un chatbot de PME, quelques centaines de mots structurés en sections suffisent généralement. Au-delà, le risque de contradictions internes augmente et Mistral AI recommande alors de passer à un arbre de décision plutôt qu'à une liste d'exceptions. La règle utile reste la clarté avant le volume.
Un prompt système protège-t-il mes données confidentielles ?
Non. Un prompt système peut être extrait par des formulations habiles, une famille de techniques connue sous le nom de prompt injection. Tarifs internes, marges, noms de clients et identifiants ne doivent jamais y figurer. Les informations sensibles se gèrent côté serveur, dans un outil appelé par le modèle, pas dans ses instructions.