Pré-entraînement d'un LLM : comment l'IA apprend ?
45 000 milliards de tokens. C'est le corpus annoncé par DeepSeek pour son modèle V4.1 Flash, publié le 9 septembre 2026, avant qu'il ne produise sa toute première phrase. Ce chiffre vertigineux correspond à une seule étape de la fabrication d'une IA, la plus longue et la plus chère : le pré-entraînement. C'est là que le modèle apprend la langue, les faits, les raisonnements et, accessoirement, ce qu'il sait de votre entreprise. Tout ce qui vient après, l'affinage et l'alignement, ne fait que polir cette matière brute. Comprendre cette étape, c'est comprendre pourquoi une IA connaît certains sites et pas d'autres, pourquoi elle s'arrête à une date donnée, et pourquoi le secteur commence sérieusement à manquer de texte. Démontage, chiffres à l'appui.
-
- Dernière modification
24 octobre 2026 - 10 minutes de lecture
Le pré-entraînement, c'est quoi exactement ?
Le pré-entraînement est la phase durant laquelle un modèle de langage apprend à prédire le mot suivant sur un immense corpus de texte, sans aucune supervision humaine et sans aucune consigne. C'est la phase fondatrice : elle représente l'écrasante majorité du calcul consommé par un modèle et elle fixe presque tout ce qu'il saura. À titre d'ordre de grandeur, le jeu de données utilisé pour l'affinage qui suit représente généralement moins de 1 % du volume du pré-entraînement.
Le modèle ne mémorise pas des pages. Il ajuste des milliards de paramètres, c'est-à-dire des poids numériques, pour minimiser son erreur de prédiction. Un token (l'unité de découpage du texte, environ trois quarts de mot en français) entre, une probabilité sur le token suivant sort. Répétez l'opération des milliers de milliards de fois et vous obtenez une représentation statistique du langage. Nous avons détaillé ce découpage dans notre article sur les tokens des LLM.
- Ce que le pré-entraînement produit : un modèle brut, capable de continuer n'importe quel texte, mais incapable de suivre une instruction ou de refuser une demande dangereuse.
- Ce qu'il coûte : l'essentiel du budget. Les chiffres détaillés plus bas situent les modèles ouverts récents entre 8 et 10 millions d'euros, et les modèles de pointe fermés bien au-delà.
- Ce qu'il fige : la connaissance du monde à une date donnée, ce qui explique la fameuse date de coupure des LLM.
Horizon GEO • La newsletter
Comprendre les LLM, sans jargon
Chaque semaine, un mécanisme des IA expliqué simplement (contexte, embeddings, raisonnement…) et l’actu des modèles qui compte.
1 e-mail par semaine • Désinscription en 1 clic
Prédire le mot suivant, des milliers de milliards de fois
L'objectif d'apprentissage tient en une ligne : masquer le token suivant et demander au modèle de le deviner. Cette tâche, triviale en apparence, oblige le réseau à encoder la grammaire, les faits, les relations entre entités et des formes de raisonnement, simplement parce que ce sont les seuls moyens de bien prédire.
Le coût de calcul se résume lui aussi à une formule, posée par Jared Kaplan et ses coauteurs d'OpenAI en 2020 : il faut environ 6 opérations en virgule flottante par paramètre et par token. Un FLOP, pour floating point operation, est l'unité de mesure du calcul. Multipliez 6 par le nombre de paramètres et par le nombre de tokens, vous obtenez le budget de calcul du pré-entraînement. Cette formule permet aux chercheurs d'Epoch AI de reconstituer la facture de modèles dont les éditeurs ne disent rien.
Exemple concret avec le modèle DeepSeek V4.1 Flash : 748 milliards de paramètres au total mais seulement 16 milliards activés à chaque token, grâce à une architecture dite mixture of experts. Epoch AI en déduit un budget de 4,32 × 10²⁴ FLOP, soit 6 × 16 milliards × 45 000 milliards. La distinction entre paramètres totaux et paramètres actifs est désormais centrale, comme nous l'expliquions dans notre article sur les paramètres des LLM.
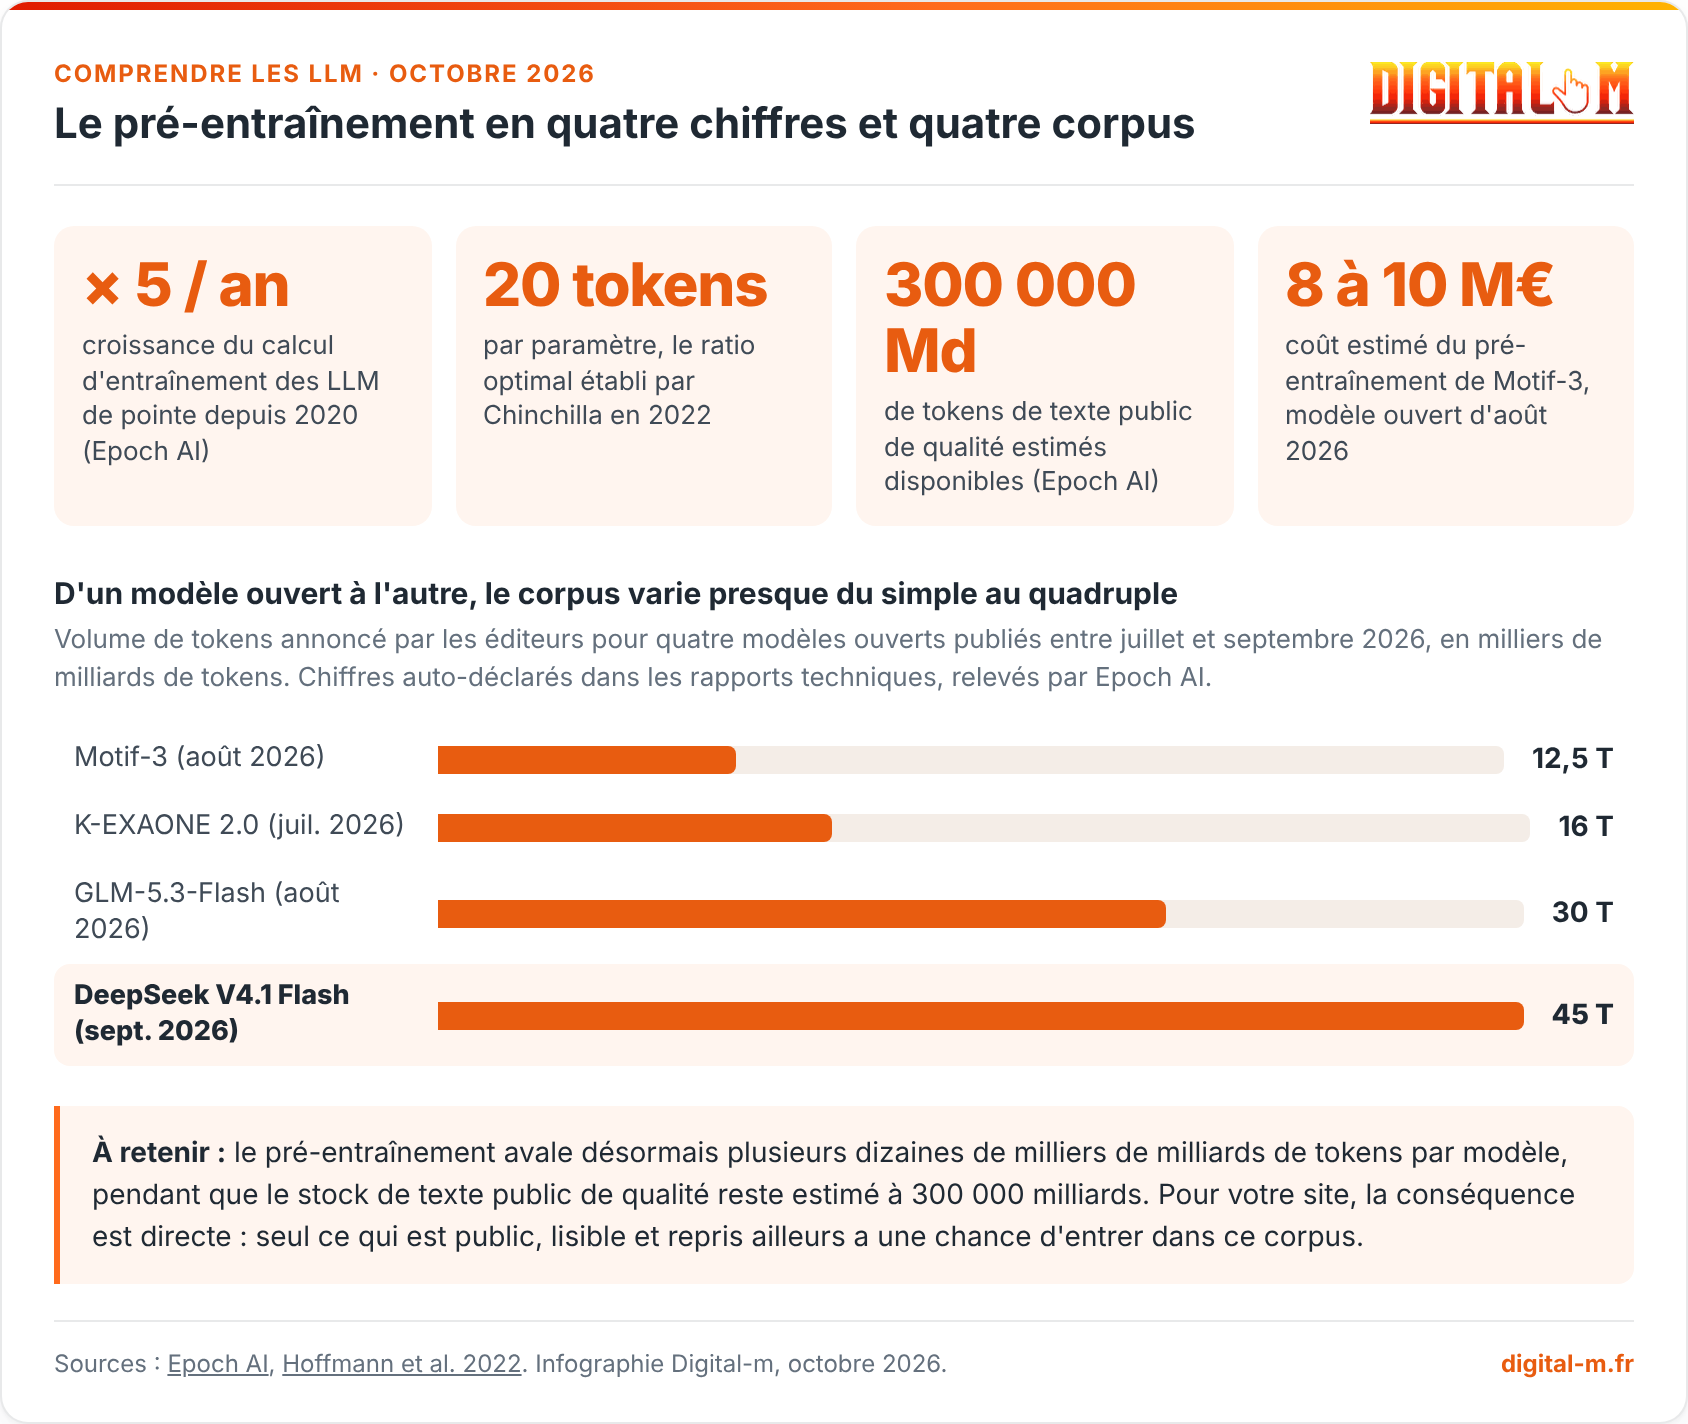
Le pré-entraînement en quatre chiffres et quatre corpus

- × 5 / an croissance du calcul d'entraînement des LLM de pointe depuis 2020 (Epoch AI)
- 20 tokens par paramètre, le ratio optimal établi par Chinchilla en 2022
- 300 000 Md de tokens de texte public de qualité estimés disponibles (Epoch AI)
- 8 à 10 M€ coût estimé du pré-entraînement de Motif-3, modèle ouvert d'août 2026
D'un modèle ouvert à l'autre, le corpus varie presque du simple au quadruple
Volume de tokens annoncé par les éditeurs pour quatre modèles ouverts publiés entre juillet et septembre 2026, en milliers de milliards de tokens. Chiffres auto-déclarés dans les rapports techniques, relevés par Epoch AI.
À retenir : le pré-entraînement avale désormais plusieurs dizaines de milliers de milliards de tokens par modèle, pendant que le stock de texte public de qualité reste estimé à 300 000 milliards. Pour votre site, la conséquence est directe : seul ce qui est public, lisible et repris ailleurs a une chance d'entrer dans ce corpus.
Télécharger l'infographie (PNG)
Combien de texte faut-il ? Les corpus de 2026 en chiffres
Les éditeurs de modèles ouverts documentent leurs corpus, ce que les laboratoires fermés ne font plus. Quatre modèles publiés entre juillet et septembre 2026 donnent la mesure du moment : Motif-3 annonce environ 12 500 milliards de tokens, K-EXAONE 2.0 de LG AI Research en revendique 16 000, GLM-5.3-Flash de Z.ai parle d'un « corpus multimodal de 30 000 milliards de tokens », et DeepSeek V4.1 Flash monte à 45 000 milliards.
Ces volumes sont auto-déclarés par leurs auteurs dans les rapports techniques, sans vérification par un tiers indépendant. Epoch AI, organisme de recherche spécialisé dans la mesure des progrès de l'IA, les relève et les recoupe avec les architectures publiées, mais ne peut pas auditer les corpus eux-mêmes.
Pour les modèles fermés, il faut se contenter d'estimations. Epoch AI évalue le pré-entraînement de GPT-6 Astra, sorti le 3 septembre 2026, à environ 9,4 × 10²⁶ FLOP, avec un intervalle allant de 5 × 10²⁶ à 2 × 10²⁷. L'organisme note que le modèle aurait été entraîné sur au moins 100 000 puces GB200 à Abilene, au Texas. Anthropic, Google DeepMind, Meta et Mistral ne publient aucun chiffre de calcul ou de corpus pour leurs modèles récents.
Les lois d'échelle : de Kaplan à Chinchilla
Les lois d'échelle décrivent comment la performance d'un modèle s'améliore quand on augmente ses paramètres, ses données et son calcul. Deux articles scientifiques ont structuré tout le secteur.
2020 : Kaplan et la course aux paramètres
Jared Kaplan et ses coauteurs publient en janvier 2020 un travail fondateur qui conclut que, à budget de calcul fixé, il vaut mieux faire grossir le modèle plus vite que le corpus. C'est la justification théorique de la course aux milliards de paramètres qui a suivi.
2022 : Chinchilla rebat les cartes
Jordan Hoffmann et son équipe de DeepMind démontrent en mars 2022 que Kaplan se trompait sur le dosage. À budget égal, paramètres et tokens doivent croître dans des proportions égales. La règle pratique retenue par la profession : environ 20 tokens d'entraînement par paramètre. Des réplications publiées depuis, notamment celles de Pearce et Song et de Porian et ses coauteurs en 2024, attribuent l'écart à trois erreurs méthodologiques de l'étude de 2020, dont le fait de ne pas compter les paramètres de la couche d'embedding.
2026 : le sur-entraînement est devenu la norme
Dans les faits, plus personne ne suit Chinchilla à la lettre. Les éditeurs pratiquent le sur-entraînement (overtraining), c'est-à-dire qu'ils nourrissent un modèle plus petit avec beaucoup plus de données que l'optimum théorique. Epoch AI relève ainsi que Llama 3-70B a été entraîné environ dix fois au-delà du point Chinchilla. La raison est économique : un modèle plus petit coûte moins cher à faire tourner ensuite, des millions de fois par jour. Chinchilla optimisait l'entraînement, le marché optimise l'inférence.
Combien coûte un pré-entraînement ?
Les montants publics sont rares. Le cas le mieux documenté de 2026 est celui de Motif-3, publié le 7 août 2026 : son éditeur annonce 768 puces B200 mobilisées pendant une centaine de jours, soit environ 1,84 million d'heures de GPU. Epoch AI en estime le coût entre 8 et 10 millions d'euros, sur la base d'un tarif de location de 5 à 6 dollars l'heure de GPU, converti au taux de référence de la Banque centrale européenne du 22 octobre 2026 (1 euro pour 1,1205 dollar).
À l'échelle de l'infrastructure, les ordres de grandeur changent de nature. Epoch AI évalue le plus grand centre de données IA connu, Colossus 2 à Memphis, à environ 1,1 million d'équivalents H100, et chiffre à près de 34 milliards d'euros l'investissement initial d'un centre de données d'un gigawatt.
Deux tendances mesurées par Epoch AI éclairent la trajectoire. Le calcul d'entraînement des modèles de pointe augmente d'un facteur 5 par an depuis 2020, soit un doublement tous les 5,2 mois. Le coût d'entraînement, lui, progresse d'un facteur 3,5 par an, soit un doublement tous les 7 mois. Sur la période 2010 à mai 2024, les chercheurs Ben Cottier, Robi Rahman et leurs collègues avaient mesuré une croissance de 4,1 fois par an pour l'ensemble des modèles notables, et de 5,3 fois par an pour les dix plus gros.
Sur la consommation énergétique du pré-entraînement, soyons clairs : aucun chiffre fiable et vérifiable n'est publié par les grands laboratoires. Les données disponibles portent sur l'inférence, pas sur l'entraînement. Nous ne donnerons donc pas d'estimation, faute de source solide.
Le mur des données : va-t-on manquer de texte ?
C'est la question la plus structurante du moment. En juin 2024, l'équipe de Pablo Villalobos chez Epoch AI a estimé le stock de texte public de qualité à environ 300 000 milliards de tokens, avec un intervalle de confiance à 90 % allant de 100 000 à 1 million de milliards.
Leur conclusion : si la tendance se poursuit, ce stock serait entièrement exploité entre 2026 et 2032, avec un intervalle de confiance de 80 %. En régime strictement optimal au sens de Chinchilla, le stock suffirait jusqu'à un budget de 5 × 10²⁸ FLOP, niveau attendu vers 2028. Mais avec un sur-entraînement d'un facteur 5, l'épuisement glisse vers 2027, et à un facteur 100 il était déjà atteint en 2025.
Deux précisions d'honnêteté intellectuelle. D'abord, cette étude date de 2024 et n'a pas été mise à jour publiquement depuis : sa fenêtre 2026-2032 est donc partiellement derrière nous. Ensuite, une première version de 2022 prévoyait un épuisement dès 2024, prévision révisée à la hausse grâce au filtrage du web et à la réutilisation des mêmes données sur plusieurs époques d'entraînement.
Les contournements existent et sont déjà en production : données synthétiques générées par d'autres modèles, répétition contrôlée du corpus, exploitation massive de la vidéo et de l'audio, accords de licence avec des éditeurs de presse. Aucun ne règle le problème de fond, à savoir que le texte humain de qualité est une ressource finie.
Et après ? Les étapes qui transforment un modèle brut en assistant
Un modèle fraîchement pré-entraîné est inutilisable tel quel : il continue les textes au lieu de répondre aux questions. Deux étapes le transforment en assistant.
- L'affinage supervisé : on montre au modèle des milliers d'exemples de bonnes réponses à des instructions. Ce jeu de données représente généralement moins de 1 % du corpus de pré-entraînement. C'est le mécanisme que nous détaillons dans notre article sur le fine-tuning.
- L'alignement : par apprentissage par renforcement sur retours humains, par IA constitutionnelle chez Anthropic ou par optimisation directe des préférences. Cette étape façonne le comportement, les refus et le ton. Nous l'avons décortiquée dans notre article sur RLHF, Constitutional AI et DPO.
- Les techniques de compression : distillation, quantization, élagage. Elles réduisent la taille du modèle final sans refaire le pré-entraînement, qui reste l'étape la plus coûteuse.
Ordre de grandeur à garder en tête : le pré-entraînement concentre l'essentiel du calcul, tout le reste se joue dans la marge. C'est pour cette raison qu'un modèle ne « réapprend » pas le monde quand il est mis à jour : il est réaligné, rarement repré-entraîné de zéro.
Ce que le pré-entraînement change pour votre visibilité
Cette mécanique a des conséquences très concrètes pour une PME qui veut exister dans les réponses de ChatGPT, Gemini, Le Chat de Mistral ou Perplexity.
- Ce qui est privé n'entre jamais : un contenu derrière un formulaire, un intranet ou un mot de passe n'a aucune chance de figurer dans un corpus de pré-entraînement.
- La reprise compte plus que la publication : un fait repris par plusieurs sites a bien plus de poids statistique qu'un fait publié une fois sur une page isolée.
- La date de coupure vous protège et vous pénalise : un modèle pré-entraîné en 2025 ignore votre déménagement de 2026, sauf s'il va chercher l'information en direct sur le web au moment de répondre.
- Le texte brut gagne : un chiffre écrit en toutes lettres dans un paragraphe se retient mieux qu'un chiffre enfermé dans un graphique ou une image.
Dans nos formations GEO, la question qui revient à chaque session est toujours la même : « comment fait-on pour entrer dans l'entraînement de ChatGPT ? ». La réponse honnête est qu'on ne le contrôle pas. En revanche, on contrôle totalement ce que les moteurs vont chercher au moment de répondre, et c'est là que se joue 100 % du travail de visibilité utile, comme nous le montrons dans nos missions d'agence GEO.
Ce qu'il faut retenir
Le pré-entraînement est l'étape où un modèle apprend à prédire le mot suivant sur des dizaines de milliers de milliards de tokens, et il concentre l'essentiel du calcul et du coût. Sa facture se calcule avec une formule simple, environ 6 FLOP par paramètre et par token, et son dosage optimal suit la règle Chinchilla de 20 tokens par paramètre, aujourd'hui volontairement dépassée pour réduire le coût d'usage.
Les corpus récents vont de 12 500 à 45 000 milliards de tokens selon les modèles ouverts documentés, pendant que le stock de texte public de qualité est estimé à 300 000 milliards. L'étau se resserre, et les données synthétiques prennent le relais, avec les risques de dérive que cela suppose.
Pour vous, l'enjeu n'est pas d'entrer dans le prochain corpus de pré-entraînement, objectif que personne ne peut vous garantir. Il est d'être trouvable et citable au moment où le moteur cherche une réponse. Nos formations GEO certifiées Qualiopi traitent précisément cette distinction, et notre équipe peut auditer votre visibilité dans les moteurs génératifs : parlons de votre projet.
Saviez-vous que l'IA que vous utilisez tous les jours a lu plus de texte qu'aucun humain n'en lira jamais ? Dites-le nous en commentaire !Sources et références
- Epoch AI - Notable AI Models, base de données des modèles et de leur calcul d'entraînement (mise à jour du 16 octobre 2026)
- Epoch AI - Machine Learning Trends, croissance du calcul et des coûts d'entraînement (mise à jour du 5 février 2026)
- Epoch AI - Training compute of frontier AI models grows by 4-5x per year, Jaime Sevilla et Edu Roldán (28 mai 2024)
- Epoch AI - Will we run out of data? Limits of LLM scaling based on human-generated data, Pablo Villalobos et al. (6 juin 2024)
- arXiv - Scaling Laws for Neural Language Models, Jared Kaplan et al. (janvier 2020)
- arXiv - Training Compute-Optimal Large Language Models, Jordan Hoffmann et al. (mars 2022)
- arXiv - Resolving Discrepancies in Compute-Optimal Scaling of Language Models, Tomer Porian et al. (juin 2024)
- arXiv - Beyond Chinchilla-Optimal: Accounting for Inference in Language Model Scaling Laws, Nikhil Sardana et Jonathan Frankle (décembre 2023)
Questions fréquentes sur le pré-entraînement des LLM
Quelle différence entre pré-entraînement et fine-tuning ?
Le pré-entraînement apprend la langue et les connaissances générales sur un corpus gigantesque, sans supervision. Le fine-tuning, ou affinage, ajuste ensuite ce modèle sur un jeu de données beaucoup plus petit, généralement moins de 1 % du volume initial, pour lui apprendre un comportement, un ton ou un domaine. Le premier coûte des millions d'euros, le second peut coûter quelques centaines d'euros sur un modèle ouvert.
Combien de tokens faut-il pour entraîner un LLM ?
La règle Chinchilla, publiée par DeepMind en 2022, recommande environ 20 tokens d'entraînement par paramètre du modèle. En pratique, les éditeurs vont bien au-delà pour réduire le coût d'usage : les modèles ouverts publiés entre juillet et septembre 2026 annoncent de 12 500 à 45 000 milliards de tokens, pour des tailles de modèle très variables. Ces volumes sont auto-déclarés par les éditeurs dans leurs rapports techniques.
Mon site peut-il entrer dans le corpus d'entraînement d'une IA ?
C'est possible si votre contenu est public, accessible aux robots d'exploration et repris ailleurs sur le web, mais aucun éditeur ne publie la liste de ses sources et personne ne peut vous le garantir. Méfiez-vous des prestataires qui promettent l'inverse. L'objectif réaliste est différent : être trouvable et citable au moment où le moteur génératif va chercher une information en direct, ce qui se travaille, se mesure et se pilote.
Va-t-on vraiment manquer de données pour entraîner les IA ?
L'étude de référence, publiée par Pablo Villalobos et son équipe chez Epoch AI en juin 2024, estime le stock de texte public de qualité à environ 300 000 milliards de tokens et situe son épuisement entre 2026 et 2032. Cette estimation n'a pas été actualisée publiquement depuis. Les laboratoires contournent déjà la limite avec des données synthétiques, de la vidéo, de l'audio et des accords de licence, sans que l'on sache encore si la qualité des modèles en souffre.
Pourquoi un LLM ne connaît-il pas l'actualité récente ?
Parce que le pré-entraînement est figé dans le temps. Le corpus est collecté à une date donnée, puis le modèle est entraîné pendant des semaines ou des mois. Tout ce qui s'est passé après cette collecte lui est inconnu, sauf s'il dispose d'un accès à la recherche web au moment de répondre. C'est ce mécanisme, et non une limite de mémoire, qui explique les réponses périmées sur les sujets d'actualité.