Données synthétiques : l'IA s'entraîne-t-elle sur l'IA ?
40 % du mélange d'entraînement de Phi-4, le modèle à 14 milliards de paramètres publié par Microsoft, est constitué de texte qu'aucun humain n'a jamais écrit. Ces données synthétiques sont générées par d'autres modèles d'intelligence artificielle, puis réinjectées dans l'apprentissage. L'idée inquiète autant qu'elle intrigue : une IA nourrie d'IA finit-elle par tourner en rond ? La recherche a tranché, et la réponse est plus nuancée que les titres alarmistes. Une équipe de Meta a entraîné près de 1 000 variantes de modèles pour mesurer l'effet exact. Résultat : bien dosé, le synthétique accélère l'entraînement de 5 à 10 fois. Mal dosé, il dégrade tout. Voici ce que montrent les chiffres, expliqué simplement.
-
- Dernière modification
8 novembre 2026 - 9 minutes de lecture
Qu'est-ce qu'une donnée synthétique pour un LLM ?
Une donnée synthétique est un texte produit par un modèle d'intelligence artificielle, puis utilisé pour en entraîner un autre. Elle s'oppose à la donnée naturelle, écrite par des humains et récupérée sur le web, dans des livres ou dans des archives.
Trois grandes familles existent aujourd'hui, et la recherche montre qu'elles n'ont pas du tout les mêmes effets :
- La reformulation : un modèle réécrit une page web existante dans un style plus propre, proche d'une encyclopédie. L'information de départ reste humaine, seule la formulation est générée.
- Le format questions-réponses : le même contenu est transformé en paires de questions et de réponses, un format qui ressemble à l'usage réel d'un assistant.
- Le manuel généré : le modèle écrit de toutes pièces des chapitres pédagogiques avec exercices, sans partir d'un document source. C'est la famille la plus risquée.
Le mot « token » revient sans cesse dans ces travaux : il désigne le fragment de texte, souvent quelques caractères, que le modèle manipule comme unité de base. Nous l'expliquons en détail dans notre article consacré au pré-entraînement d'un LLM, l'étape où ces données sont avalées par milliers de milliards.
Horizon GEO • La newsletter
Comprendre les LLM, sans jargon
Chaque semaine, un mécanisme des IA expliqué simplement (contexte, embeddings, raisonnement…) et l’actu des modèles qui compte.
1 e-mail par semaine • Désinscription en 1 clic
Quelle part de l'entraînement est déjà synthétique ?
Chez Microsoft, le modèle Phi-4 affiche 40 % de données synthétiques dans son mélange d'entraînement, soit 290 milliards de tokens uniques réutilisés 13,8 fois en moyenne, sur un pré-entraînement total d'environ 10 000 milliards de tokens. Le rapport technique précise que les jeux générés représentent environ 400 milliards de tokens produits au total.
Le résultat est spectaculaire sur certains tests : Phi-4, avec ses 14 milliards de paramètres, dépasse GPT-4o, le modèle qui a servi à générer une partie de ses données, sur le test de raisonnement scientifique GPQA (56,1 contre 50,6) et sur le test de mathématiques MATH (80,4 contre 74,6). L'élève bat le professeur sur deux épreuves précises. Sur onze autres mesures du même tableau, dont MMLU et HumanEval, GPT-4o reste devant. Ces scores sont ceux publiés par Microsoft, donc un test maison non vérifié par un tiers indépendant.
Du côté des modèles ouverts, Qwen3 revendique 36 000 milliards de tokens de pré-entraînement en 119 langues, avec des données générées par les versions précédentes de la famille : Qwen2.5 pour le texte général, Qwen2.5-Math pour les mathématiques et Qwen2.5-Coder pour le code. La part exacte de synthétique n'a pas été publiée.
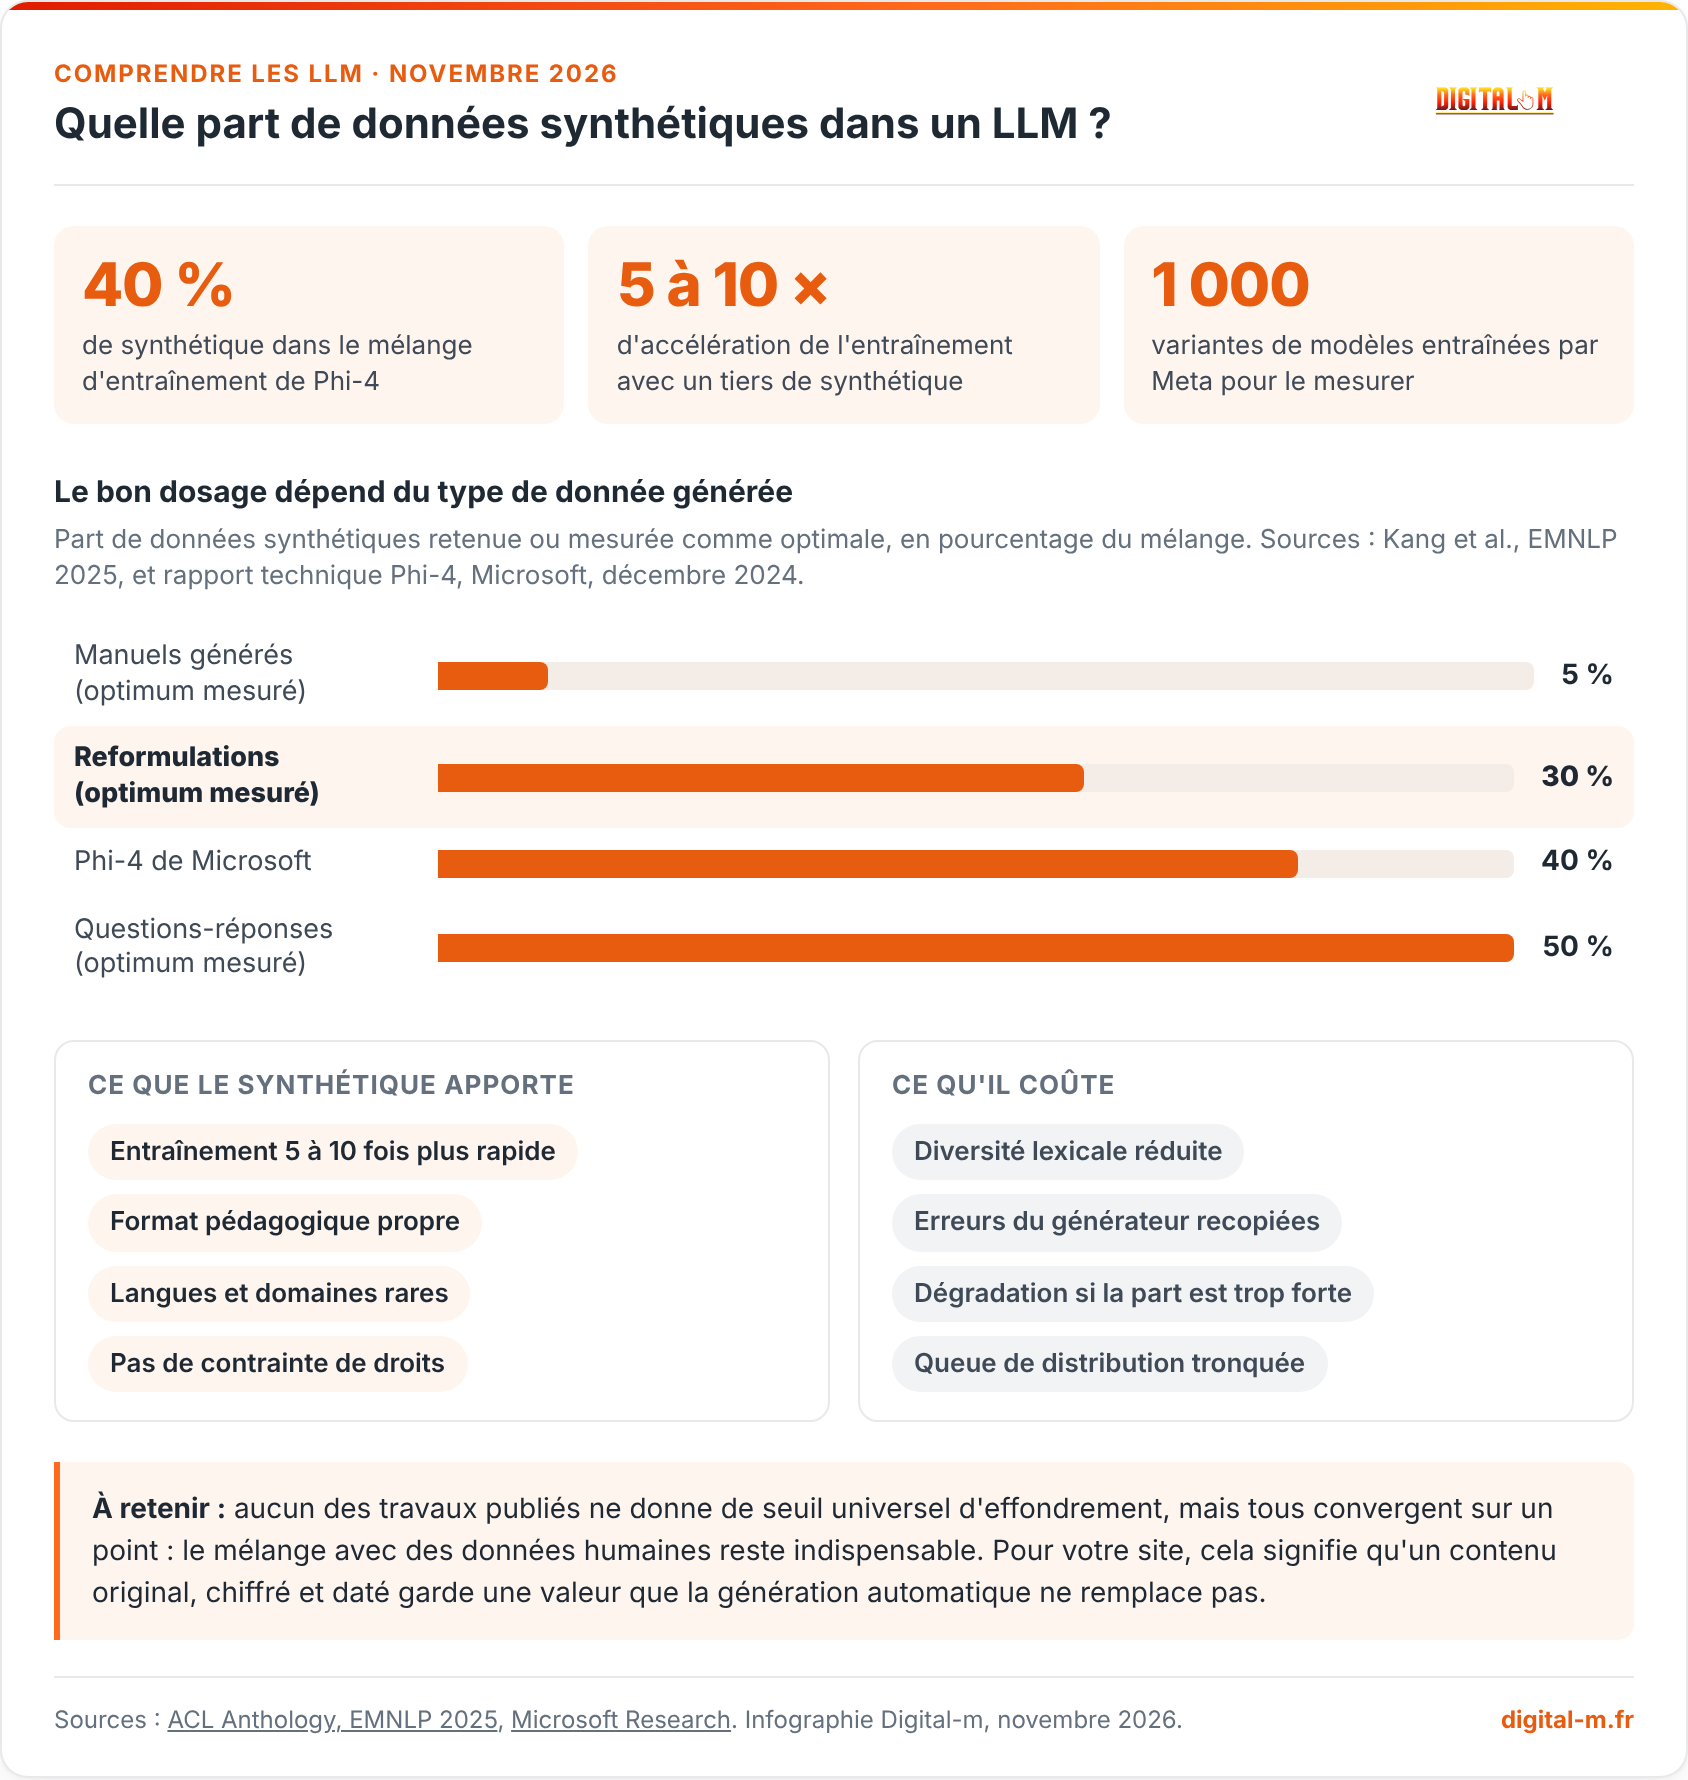
Quelle part de données synthétiques dans un LLM ?

- 40 % de synthétique dans le mélange d'entraînement de Phi-4
- 5 à 10 × d'accélération de l'entraînement avec un tiers de synthétique
- 1 000 variantes de modèles entraînées par Meta pour le mesurer
Le bon dosage dépend du type de donnée générée
Part de données synthétiques retenue ou mesurée comme optimale, en pourcentage du mélange. Sources : Kang et al., EMNLP 2025, et rapport technique Phi-4, Microsoft, décembre 2024.
Ce que le synthétique apporte
Ce qu'il coûte
À retenir : aucun des travaux publiés ne donne de seuil universel d'effondrement, mais tous convergent sur un point : le mélange avec des données humaines reste indispensable. Pour votre site, cela signifie qu'un contenu original, chiffré et daté garde une valeur que la génération automatique ne remplace pas.
Télécharger l'infographie (PNG)
Pourquoi ça marche : le gain mesuré par Meta
Un mélange composé d'un tiers de données synthétiques et de deux tiers de données web naturelles atteint le même niveau de performance 5 à 10 fois plus vite qu'un entraînement sur données web seules. Ce chiffre vient d'une étude menée par Feiyang Kang et ses coauteurs, affiliés à FAIR chez Meta, à Virginia Tech et à Cerebras Systems, présentée à la conférence EMNLP 2025 en novembre 2025.
Le protocole donne la mesure de l'effort : environ 1 000 variantes de modèles entraînées depuis zéro, jusqu'à 3 milliards de paramètres, sur des jeux allant jusqu'à 200 milliards de tokens, pour plus de 100 000 heures de calcul sur cartes graphiques. Autant dire qu'il ne s'agit pas d'une intuition de laboratoire.
L'explication tient à la propreté du texte. Une page web brute contient des menus, des mentions légales, des phrases bancales et des répétitions. Une reformulation générée conserve l'information et supprime le bruit. Le modèle apprend donc plus par token lu. C'est exactement la logique de la distillation d'un LLM, où un gros modèle transmet sa connaissance à un plus petit.
L'effondrement des modèles : le risque réel, et sa vraie forme
Le terme « model collapse », ou effondrement de modèle, désigne la dégradation progressive d'un modèle réentraîné en boucle sur ses propres productions. Les travaux d'Elvis Dohmatob, Yunzhen Feng, Pu Yang, François Charton et Julia Kempe, présentés à la conférence ICML 2024, lui donnent une forme précise : il s'agit d'un changement de loi d'échelle.
Traduisons. Normalement, plus on ajoute de données, plus l'erreur du modèle baisse selon une courbe régulière, ce que les chercheurs appellent une loi d'échelle. Quand les données générées remplacent les données humaines, cette courbe atteint un plateau et cesse de progresser, quelle que soit la quantité ajoutée.
La cause est subtile et mérite d'être comprise. Un modèle qui génère du texte tronque naturellement les événements rares, à cause des réglages d'échantillonnage comme le top-p, qui limite le choix aux mots les plus probables, et la température, qui règle le degré de hasard. Nous détaillons ces deux paramètres dans notre article sur la façon dont un LLM choisit ses mots. Les formulations rares, les cas particuliers et les compétences marginales disparaissent donc génération après génération.
Point rassurant mis en évidence par la même équipe : mélanger ne serait-ce qu'une petite part de données humaines fraîches restaure la progression. Le phénomène est spectaculaire, les auteurs parlent de « grokking », cette reprise brutale de l'apprentissage après un long plateau. Mais plus les données réelles sont rares, plus ce plateau dure longtemps.
Toutes les données synthétiques ne se valent pas
Le dosage optimal varie du simple au décuple selon le type de texte généré : environ 30 % pour des reformulations de pages web, autour de 50 % pour du format questions-réponses sur les petites configurations, mais souvent moins de 5 % pour des manuels générés de toutes pièces.
Les manuels synthétiques utilisés seuls produisent la perte la plus élevée de toute l'étude Meta, nettement au-dessus de celle obtenue avec des pages web brutes. Les auteurs notent que ces résultats ressemblent aux prédictions théoriques de l'effondrement de modèle. L'explication est logique : un texte inventé sans document source hérite de toutes les approximations du générateur, sans aucun ancrage factuel pour les corriger.
C'est aussi par ce mécanisme que les erreurs se propagent. Un générateur qui se trompe sur une date ou un chiffre inscrit cette erreur dans des milliers d'exemples d'entraînement, et elle devient une croyance du modèle suivant. Le sujet rejoint directement celui des hallucinations des LLM, à cette différence près que l'erreur n'est plus accidentelle : elle est apprise.
Un générateur plus gros ne fait pas de meilleures données
Contre toute attente, utiliser un modèle de 70 milliards de paramètres pour générer les données d'entraînement ne donne pas de meilleurs résultats qu'un modèle de 8 milliards. L'équipe de Meta a comparé trois générateurs de la famille Llama 3, à 3, 8 et 70 milliards de paramètres, sur environ 200 modèles élèves.
Le passage de 3 à 8 milliards améliore nettement la qualité. Le passage de 8 à 70 milliards n'apporte rien, et pour les reformulations de haute qualité, le plus gros générateur fait même sensiblement moins bien. Une leçon d'économie pour les laboratoires : la facture de génération peut être divisée par huit sans perte.
Et la théorie, que dit-elle ?
Un préprint publié sur arXiv le 16 septembre 2026 par Matteo Marchi, João Pedro Silvestre, Bahman Gharesifard et Paulo Tabuada, de l'UCLA et de Queen's University, conclut que la proportion de données humaines nécessaire pour éviter l'effondrement serait plus élevée que ne le suggéraient les travaux précédents. Précision d'honnêteté : ce texte ne contient aucune expérience, il s'agit d'un résultat purement mathématique, et il n'a pas encore été évalué par les pairs à la date de publication de cet article.
Qui produit encore de la donnée humaine ?
La question devient économique. La fermeture de la plateforme d'annotation Amazon Mechanical Turk, que nous avions analysée dans notre article sur la fin de Mechanical Turk, illustre le basculement : l'annotation de masse à bas coût disparaît au profit d'experts rémunérés et de génération automatique. Les données humaines de qualité deviennent la ressource rare.
Ce que ça change pour votre contenu et votre visibilité
Si les données humaines originales deviennent rares et précieuses pour les laboratoires, elles le deviennent aussi pour votre visibilité dans les réponses d'IA. Un contenu qui apporte une information qu'aucun modèle ne peut inventer, un chiffre de terrain, un test, une méthode éprouvée, occupe une place que la génération automatique ne comble pas.
Chez Digital-m, nous constatons la même chose côté éditorial : les pages de nos clients qui se font citer par ChatGPT, Gemini, Mistral ou Perplexity sont presque toujours celles qui contiennent une donnée propriétaire, un retour d'expérience daté ou un tarif en euros vérifiable. Les pages qui résument ce que tout le monde dit déjà n'apportent rien de nouveau au modèle, et ne sont pas retenues.
Trois réflexes concrets découlent de ce constat :
- Publiez vos propres chiffres : un sondage interne, un relevé de prix, une mesure de performance sur vos projets. C'est ce qui n'existe nulle part ailleurs.
- Datez et sourcez tout : une affirmation vérifiable vaut mieux qu'une formule générale, pour le lecteur comme pour le moteur.
- Relisez humainement ce que vous générez : un contenu produit par IA et publié sans vérification reproduit exactement le problème décrit plus haut, à l'échelle de votre site.
Ce travail d'ancrage factuel est au centre de notre accompagnement GEO, où nous aidons les entreprises à transformer ce qu'elles savent en contenu réellement citable.
Ce qu'il faut retenir
Les données synthétiques occupent déjà 40 % du mélange d'entraînement de Phi-4 et une part non publiée de celui de Qwen3. Bien dosées, elles accélèrent l'entraînement de 5 à 10 fois selon l'étude Meta présentée à EMNLP 2025. Mal dosées, elles font plafonner les performances, un phénomène que les chercheurs décrivent comme un changement de loi d'échelle plutôt que comme un effondrement brutal.
Trois enseignements à mémoriser. Le type de donnée générée compte plus que la quantité, avec un optimum autour de 30 % pour des reformulations et sous les 5 % pour des manuels inventés. Un générateur plus gros ne produit pas de meilleures données au-delà de 8 milliards de paramètres. Et le mélange avec des données humaines fraîches reste la condition de la progression, ce qui rend le contenu original plus stratégique que jamais.
Vous produisez du contenu avec l'aide de l'IA et vous vous demandez ce qui est réellement repris par les moteurs génératifs ? Demandez un audit de visibilité IA, ou formez vos équipes avec notre formation GEO certifiée Qualiopi, qui consacre un module entier à la production de contenu réellement citable.
Utilisez-vous déjà l'IA pour produire une partie de vos contenus, et comment vérifiez-vous ce qu'elle écrit ? Dites-le nous en commentaire !Sources et références
- ACL Anthology - Demystifying Synthetic Data in LLM Pre-training: A Systematic Study of Scaling Laws, Benefits, and Pitfalls, Kang et al., EMNLP 2025 (novembre 2025)
- arXiv - Phi-4 Technical Report, Microsoft Research (12 décembre 2024)
- arXiv - A Tale of Tails: Model Collapse as a Change of Scaling Laws, Dohmatob et al., ICML 2024 (10 février 2024)
- arXiv - Preventing Model Collapse: A Fisher-Rao Perspective on the Dynamics of Training with Synthetic Data, Marchi et al. (16 septembre 2026, préprint non évalué par les pairs)
- Kili Technology - Data Story: A Deep Dive into Qwen 3's Data Pipeline (2 février 2026)
Questions fréquentes sur les données synthétiques des LLM
Les IA actuelles s'entraînent-elles vraiment sur du contenu généré par IA ?
Oui, et à grande échelle. Microsoft indique que 40 % du mélange d'entraînement de Phi-4 est synthétique, soit environ 290 milliards de tokens uniques. L'équipe Qwen décrit un pipeline où Qwen2.5, Qwen2.5-Math et Qwen2.5-Coder génèrent manuels, questions-réponses et extraits de code pour entraîner Qwen3. La plupart des grands laboratoires ne publient toutefois pas la part exacte de synthétique dans leurs modèles.
Qu'est-ce que l'effondrement de modèle, ou model collapse ?
C'est la dégradation d'un modèle réentraîné en boucle sur ses propres productions. Les travaux présentés à ICML 2024 par Dohmatob et ses coauteurs le décrivent comme un changement de loi d'échelle : l'erreur cesse de diminuer quand on ajoute des données, et atteint un plateau. La cause est la troncature des événements rares par les réglages d'échantillonnage, qui appauvrit progressivement la diversité du texte généré.
Quelle proportion de données synthétiques est acceptable ?
Aucun seuil universel n'a été démontré. L'étude Meta présentée à EMNLP 2025 mesure un optimum autour de 30 % pour des reformulations de pages web, environ 50 % pour du format questions-réponses sur les petites configurations, et souvent moins de 5 % pour des manuels générés sans document source. Le type de donnée pèse donc plus que la quantité, et ces mesures portent sur des modèles de 100 millions à 3 milliards de paramètres.
Pourquoi un générateur plus puissant ne produit-il pas de meilleures données ?
L'étude Meta a comparé des générateurs Llama 3 de 3, 8 et 70 milliards de paramètres sur environ 200 modèles élèves. Le gain entre 3 et 8 milliards est net, mais il disparaît ensuite, et le générateur de 70 milliards fait même moins bien sur les reformulations de haute qualité. L'hypothèse avancée est qu'un très gros modèle produit un texte plus uniforme, donc moins varié, ce qui appauvrit l'apprentissage.
Faut-il arrêter d'utiliser l'IA pour écrire ses contenus web ?
Non, mais la leçon des laboratoires s'applique à votre site. Un texte généré puis publié sans vérification reproduit les erreurs de son générateur et n'apporte aucune information nouvelle. Les pages qui se font citer par les moteurs génératifs sont celles qui contiennent une donnée propriétaire, un retour d'expérience daté ou un chiffre vérifiable. Utilisez l'IA pour la forme, gardez la main sur le fond.