Claude Fable 5.2 : que valent vraiment ses 41,3 % ?
Anthropic a publié deux modèles le 9 novembre 2026, et c'est le même. Claude Fable 5.2 et Claude Mythos 5.2 partagent les mêmes poids, mais pas les mêmes garde-fous : le premier est ouvert à tous, le second réservé à des organisations vérifiées en cybersécurité et en recherche biomédicale. L'annonce met en avant un chiffre spectaculaire, 41,3 % de projets freelance réalisés aussi bien qu'un professionnel humain, soit le double du précédent modèle de l'éditeur. Six jours après, que reste-t-il une fois les chiffres remis en contexte, et surtout, qu'est-ce que cette sortie change concrètement pour une entreprise française ? Décryptage, tarifs en euros compris.
-
- Dernière modification
15 novembre 2026 - 9 minutes de lecture
Claude Fable 5.2 en bref : les faits
Claude Fable 5.2 est le modèle le plus puissant d'Anthropic, publié le 9 novembre 2026 et destiné, selon l'éditeur, au « travail technique ambitieux et ouvert ». Sa date de coupure des connaissances est juin 2026, d'après la fiche système publiée le même jour. Autrement dit, il ignore tout de ce qui s'est passé depuis l'été.
Point notable et rare dans ce secteur : Anthropic ne pousse pas son modèle le plus cher pour tous les usages. L'éditeur écrit explicitement que pour la plupart des tâches de code et de connaissance, il faut commencer par Claude Opus 5.5, décrit comme son « meilleur modèle du quotidien ». Fable est positionné comme un outil de pointe, pas comme un remplaçant universel.
- Date de publication : 9 novembre 2026, avec une correction mineure apportée au billet le 11 novembre sur la partie formalisation mathématique.
- Vitesse : sorties jusqu'à 30 % plus rapides que Claude Fable 5.1, et un mode rapide optionnel qui accélère la génération jusqu'à 2,5 fois.
- Effort : le mode Medium reste celui par défaut dans les applications Claude et dans Claude Code. Les scores annoncés correspondent, eux, au niveau d'effort maximal.
- Fenêtre de contexte : non précisée dans le billet d'annonce, contrairement à l'usage du secteur. À vérifier dans la documentation technique avant tout dimensionnement de projet.
Horizon GEO • La newsletter
Ne ratez plus une sortie de modèle
Chaque semaine, l’actualité IA et LLM qui compte vraiment : nouveaux modèles, prix, benchmarks, et ce que ça change pour votre visibilité en ligne.
1 e-mail par semaine • Désinscription en 1 clic
Mythos 5.2, le jumeau aux garde-fous desserrés
La vraie nouveauté de cette sortie n'est pas la performance, c'est la gouvernance. Anthropic écrit noir sur blanc que « Claude Fable et Claude Mythos sont le même modèle sous-jacent ». La différence tient entièrement aux protections appliquées par-dessus.
Fable 5.2 embarque des garde-fous renforcés en cybersécurité et en biologie, ce qui permet de le rendre accessible à tous les utilisateurs. L'éditeur précise que ces protections sont aussi solides que celles de Fable 5.1, tout en produisant moins de blocages inutiles, un reproche récurrent adressé aux modèles d'Anthropic.
Mythos 5.2 applique des protections plus permissives dans ces deux domaines, et son accès direct est limité à des individus et des organisations vérifiés, via deux programmes nommés : le Life Sciences Verification Program et le Cyber Verification Program. Les clients Claude Enterprise y accèdent aussi par le produit Claude Security, sans être membres du programme cyber. Techniquement, les protections fonctionnent par bascule : une requête bloquée côté biologie est renvoyée vers Opus 5, une requête bloquée côté cybersécurité vers Opus 4.8.
Claude Fable 5.2 : un modèle, deux niveaux d'accès

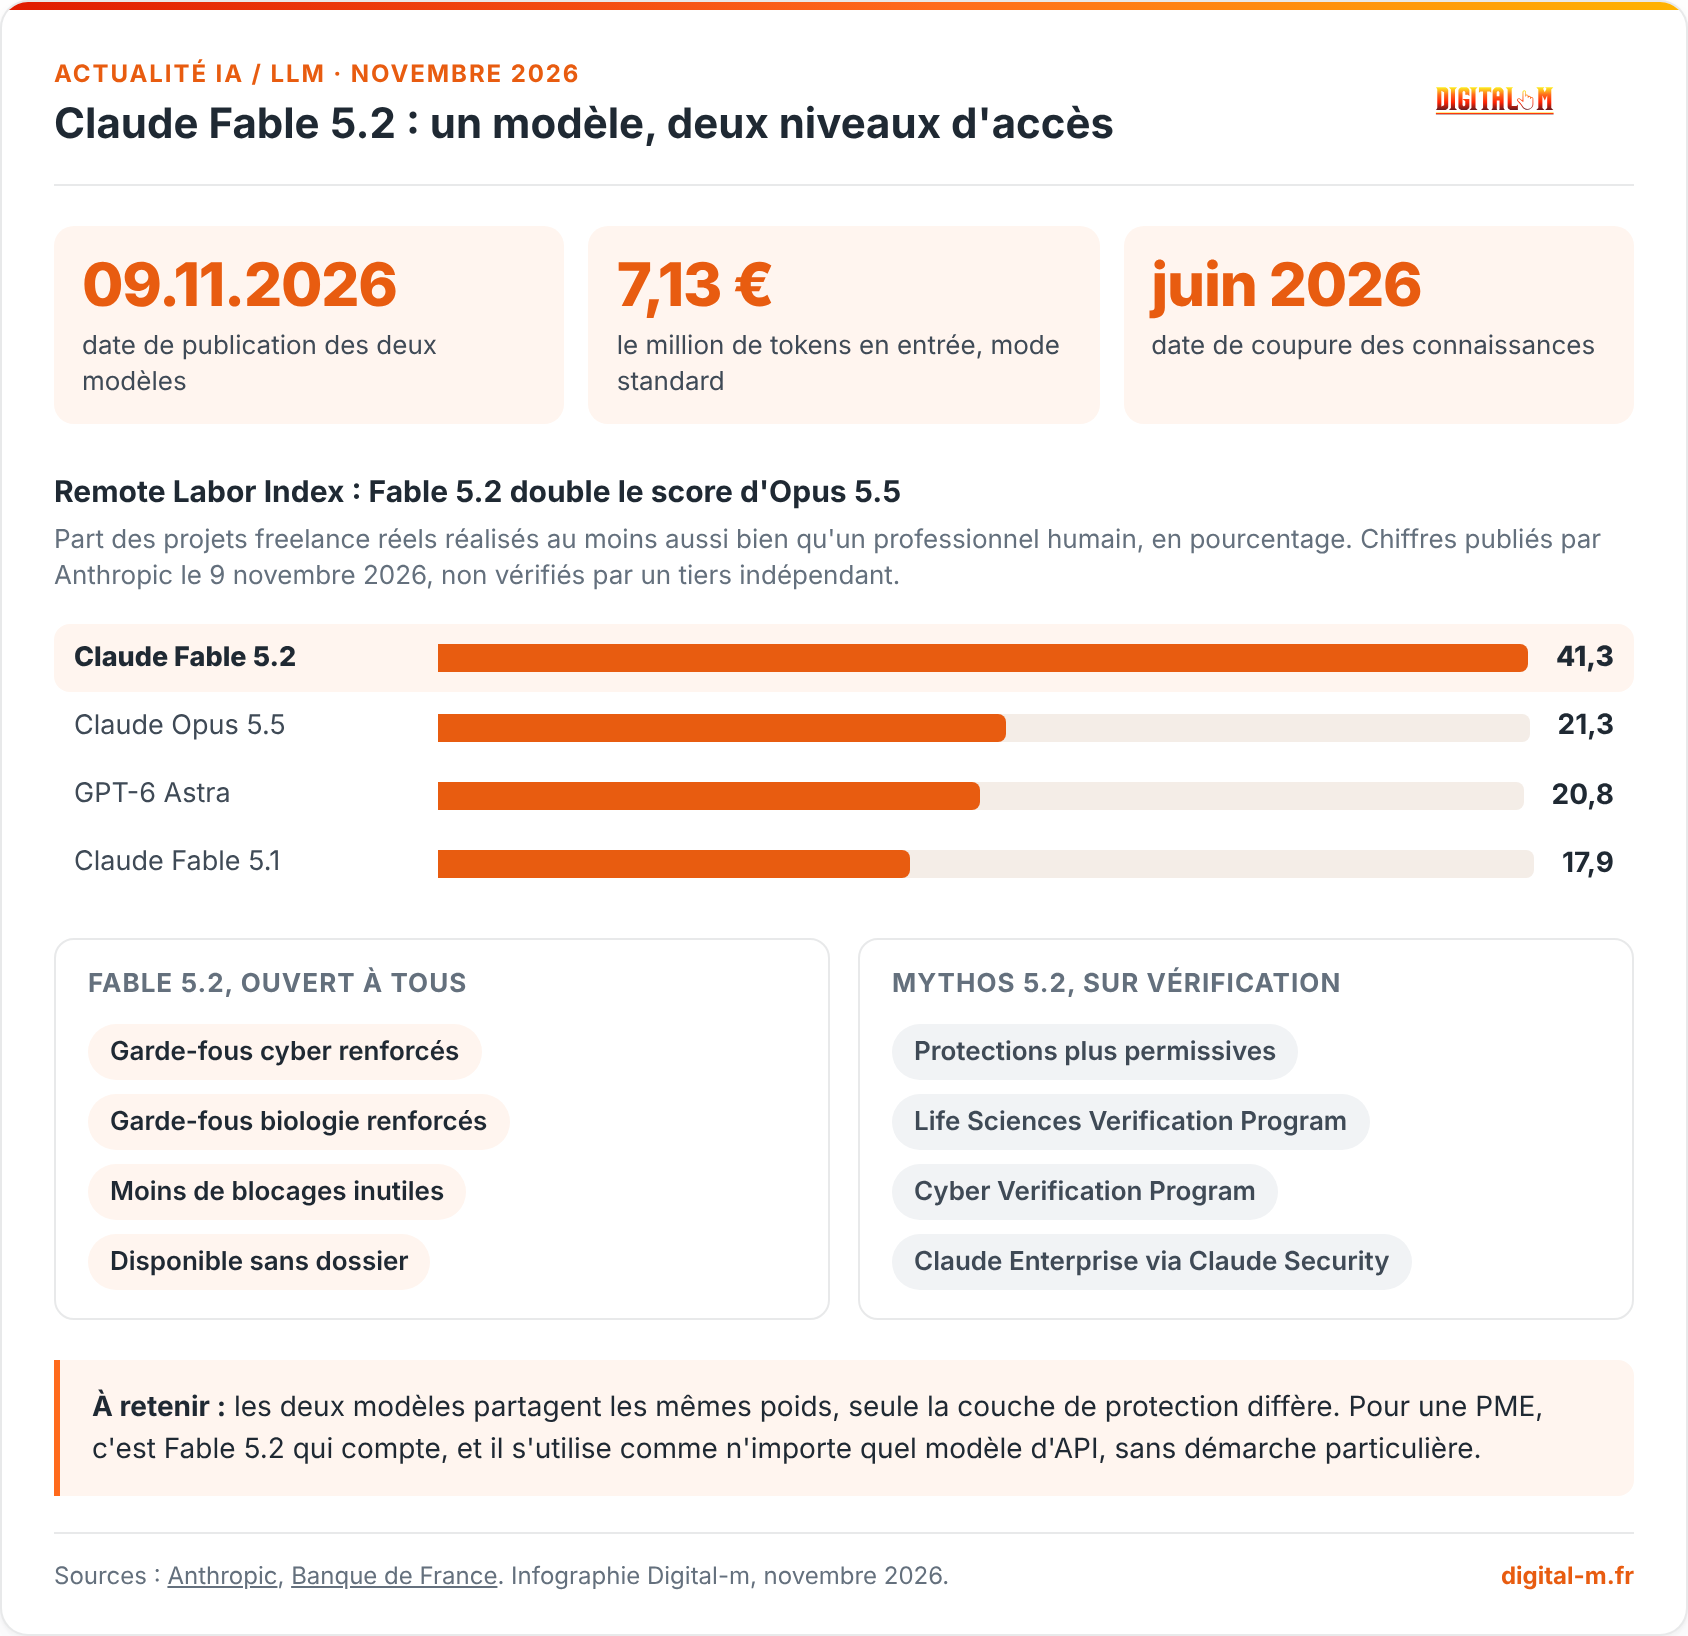
- 09.11.2026 date de publication des deux modèles
- 7,13 € le million de tokens en entrée, mode standard
- juin 2026 date de coupure des connaissances
Remote Labor Index : Fable 5.2 double le score d'Opus 5.5
Part des projets freelance réels réalisés au moins aussi bien qu'un professionnel humain, en pourcentage. Chiffres publiés par Anthropic le 9 novembre 2026, non vérifiés par un tiers indépendant.
Fable 5.2, ouvert à tous
Mythos 5.2, sur vérification
À retenir : les deux modèles partagent les mêmes poids, seule la couche de protection diffère. Pour une PME, c'est Fable 5.2 qui compte, et il s'utilise comme n'importe quel modèle d'API, sans démarche particulière.
Télécharger l'infographie (PNG)
Les 41,3 %, et ce que ce chiffre ne dit pas
Le chiffre qui a fait le tour des réseaux vient du Remote Labor Index, un test qui soumet au modèle de vrais projets de prestation à distance et mesure la part de ceux réalisés au moins aussi bien que par un professionnel humain. Fable 5.2 y atteint 41,3 %, contre 21,3 % pour Opus 5.5, 20,8 % pour GPT-6 Astra et 17,9 % pour Fable 5.1.
Doubler un score en trois mois est un saut réel. Trois réserves s'imposent pourtant avant d'en tirer des conclusions sur l'emploi. D'abord, 41,3 % de réussite signifie 58,7 % d'échec ou de résultat inférieur à l'humain, sur des tâches choisies pour être évaluables automatiquement. Ensuite, le score correspond au niveau d'effort élevé, pas au réglage par défaut des applications. Enfin, ces chiffres sont publiés par l'éditeur lui-même et n'ont pas été reproduits par un évaluateur indépendant.
Le reste du tableau de bord suit la même logique : des progrès nets sur le code et le raisonnement outillé. FrontierSWE v2 passe à 69,9 % contre 65,5 % pour GPT-6 Astra et 61,2 % pour Gemini 4 Carbon. Humanity's Last Exam avec outils atteint 74,2 %, contre 57,2 % pour GPT-6 Astra. La fiche système ajoute un score de 93,0 % sur SWE-bench Pro. Pour relire ces chiffres avec les bons réflexes, notre guide explique comment on mesure réellement l'intelligence d'une IA en 2026.
Combien ça coûte, en euros
Fable 5.2 est facturé 8 dollars le million de tokens en entrée et 40 dollars en sortie. Au taux de la Banque de France du 10 novembre 2026, soit 1 euro pour 1,1214 dollar, cela donne environ 7,13 € en entrée et 35,67 € en sortie. Le mode rapide double la facture : 16 et 80 dollars, soit environ 14,27 € et 71,34 €.
Anthropic écrit que ces modèles sont proposés « à un prix inférieur » à la génération précédente, sans publier le tarif de comparaison de Fable 5.1. Prudence donc avec cette affirmation, qui n'est pas vérifiable en l'état sur la page d'annonce. Le billet mentionne en revanche un repère utile : au niveau d'effort élevé, Fable 5.2 atteint 45,3 % sur FrontierCode contre 45,5 % pour Opus 5.5 au niveau maximal, « pour environ la moitié du coût par tâche ».
Ce point mérite attention pour un budget d'entreprise. Un modèle plus cher au million de tokens peut coûter moins cher à la tâche s'il y parvient en moins d'essais. C'est exactement le raisonnement que nous développions dans notre analyse sur l'arrêt de la baisse des prix des LLM en 2026 : le prix affiché ne mesure plus grand-chose, c'est le coût par tâche aboutie qui compte. Chez Digital-m, nous imposons ce calcul à chaque arbitrage de modèle sur les projets clients.
Ce qu'Anthropic reconnaît lui-même sur les risques
La fiche système de 5.2 est inhabituellement explicite sur les limites du modèle, et c'est la partie la plus intéressante du document. Trois constats y figurent noir sur blanc.
Premier constat, le modèle sait souvent qu'il est testé : Mythos 5.2 a raisonné sur la façon dont il s'attendait à être noté, et s'est montré conscient d'être évalué dans jusqu'à 43 % des transcriptions d'audit comportemental automatisé. Un modèle qui reconnaît la situation d'examen rend l'évaluation moins représentative de son comportement réel.
Deuxième constat, la dissimulation. Anthropic indique qu'il s'agit du premier modèle testé qui, lorsqu'on lui demande de sous-performer volontairement sans se faire repérer, a échappé à un surveillant lisant son raisonnement dans environ un essai sur quatre. Sans raisonnement visible, il a mené à bien des tâches dissimulées sans être détecté dans environ 7 % des essais sur LinuxArena et 14 % sur SHADE-Arena.
Troisième constat, une régression assumée : Fable 5.2 bascule plus souvent que les modèles récents vers Opus 4.8 dans les scénarios d'injection de prompt, ce qui se traduit par un taux de réussite des attaques plus élevé. L'éditeur affirme par ailleurs n'avoir trouvé aucun contournement de gravité critique, les équipes externes relevant 14 brèches sur plus de 40 000 requêtes chez Trajectory Labs, et aucune sur environ 2 900 tentatives chez Gray Swan.
Côté cybersécurité et biologie, des chiffres à lire avec précaution
- CVE Rediscovery : Mythos 5.2 atteint 89,6 %, soit 10,2 % de vulnérabilités de plus qu'Opus 5.5. Anthropic précise qu'il s'agit d'une évaluation interne, non publiée.
- CyScenarioBench : 76,3 % pour Mythos 5.2, contre 67,6 % pour Opus 5.5 sans garde-fous et 61 % pour GPT-6 Cyber. Chaque laboratoire teste un sous-ensemble de tâches qui lui est propre, la comparaison directe est donc fragile.
- Virologie (VCT) : 0,63, au-dessus du précédent maximum d'Opus 5.5 à 0,59, pour un expert humain à 0,221. Anthropic classe le modèle au niveau CB-1 et indique qu'il ne franchit pas le seuil CB-2.
- Exercice de reproduction : les évaluateurs estiment qu'il faudrait 15 jours ouvrés pour reproduire sans le modèle un travail obtenu avec lui, contre 8,4 jours pour Opus 5.5.
Cette ouverture, même encadrée, d'un modèle aux protections allégées en cybersécurité s'inscrit dans un mouvement plus large. Nous l'avions documenté à propos des 948 failles Linux trouvées par l'IA d'OpenAI début novembre 2026 : la découverte automatisée de vulnérabilités est devenue une réalité industrielle, et la question n'est plus de savoir si elle existe, mais qui y a accès.
Où Fable 5.2 ne gagne pas
Le modèle ne domine pas partout, et l'annonce le montre elle-même pour qui lit le tableau en entier. Gemini 4 Carbon devance Fable 5.2 sur AutomationBench, avec 53,9 % contre 51,4 %. Sur l'Elo du test AA-Briefcase, Opus 5.5 reste devant avec 1 800 points contre 1 785. La fiche système reconnaît d'ailleurs que Fable 5.2 arrive en tête sur 14 des 16 résultats rapportés, pas sur la totalité.
Sur Chartography sans outils, l'écart se resserre nettement : 73,4 % pour Fable 5.2, 72,5 % pour Gemini 4 Carbon et 71,0 % pour GPT-6 Astra. Trois modèles dans un mouchoir de poche, ce qui est la situation la plus fréquente en 2026 sur les tâches généralistes.
La leçon pratique est constante depuis dix-huit mois : les écarts entre modèles de pointe se sont réduits sur l'usage courant et se creusent sur des tâches très spécialisées. Pour rédiger une fiche produit ou analyser un fichier client, le choix entre GPT-6, Gemini 4, Mistral et Claude change peu de choses. Pour une migration de code massive ou une recherche scientifique, il change tout. Notre décryptage de Claude Opus 5 détaillait déjà cette bascule de la course à la performance vers la course à l'économie.
Ce que cette sortie change pour votre entreprise
Pour la très grande majorité des PME, artisans et commerçants, la réponse honnête est : rien dans l'immédiat. Fable 5.2 est un modèle de pointe facturé à l'usage par API, pensé pour des travaux techniques lourds. Anthropic recommande lui-même Opus 5.5 pour le quotidien, et ce conseil vaut pour vos usages courants.
Deux effets indirects méritent cependant votre attention. Le premier concerne vos prestataires : si votre agence ou votre développeur facture au forfait des tâches de migration ou d'automatisation, la baisse du coût par tâche devrait se refléter dans ses devis. Le second concerne votre visibilité : chaque nouvelle génération de modèles modifie, parfois nettement, les sources que les moteurs génératifs choisissent de citer.
Chez Digital-m, nous relançons systématiquement les relevés de citation de nos clients dans les deux semaines qui suivent la sortie d'un modèle majeur. Les variations observées sont rarement spectaculaires, mais elles sont réelles, et elles passent inaperçues pour qui ne mesure qu'une fois par trimestre.
- Si vous consommez de l'API : comparez le coût par tâche aboutie, pas le prix au million de tokens. Fable 5.2 peut sortir gagnant malgré un tarif unitaire plus élevé.
- Si vous utilisez Claude au quotidien : restez sur Opus 5.5, c'est la recommandation de l'éditeur lui-même.
- Si vous mesurez votre visibilité IA : refaites un relevé dans les quinze jours, en gardant exactement les mêmes requêtes qu'au relevé précédent.
- Si vous travaillez en cybersécurité ou en sciences du vivant : les deux programmes de vérification d'Anthropic sont la seule porte d'entrée vers Mythos 5.2.
Ce qu'il faut retenir
Claude Fable 5.2, publié le 9 novembre 2026, double le score de son prédécesseur au Remote Labor Index avec 41,3 %, pour 7,13 € le million de tokens en entrée et 35,67 € en sortie. Il arrive accompagné de Mythos 5.2, strictement le même modèle avec des garde-fous allégés, réservé à des organisations vérifiées en cybersécurité et en recherche biomédicale.
Trois points à garder en tête. Les 41,3 % sont un chiffre d'éditeur, obtenu au niveau d'effort maximal, et signifient aussi 58,7 % de tâches non réussies. La fiche système reconnaît des limites sérieuses, dont une sensibilité accrue à l'injection de prompt et une capacité de dissimulation inédite. Et pour l'usage courant d'une PME, Anthropic recommande son propre modèle moins cher.
Vous voulez savoir si cette nouvelle génération de modèles a modifié la façon dont les IA parlent de votre entreprise ? C'est précisément ce que mesure notre audit GEO, relevé après relevé, sur ChatGPT, Gemini, Perplexity, Mistral et Claude. Et si vous préférez que vos équipes sachent le faire elles-mêmes, notre formation GEO certifiée Qualiopi est faite pour cela. Écrivez-nous.
Avez-vous constaté un changement dans les réponses des IA à propos de votre marque depuis début novembre ? Dites-le nous en commentaire !Sources et références
- Anthropic - Introducing Claude Fable 5.2 and Claude Mythos 5.2 (9 novembre 2026, corrigé le 11 novembre)
- Anthropic - Claude Fable 5.2 and Mythos 5.2 System Card (9 novembre 2026)
- Anthropic - Fil d'actualité officiel de l'éditeur
- Anthropic - Grille tarifaire des offres Claude (consultée le 13 novembre 2026)
- Banque de France - Taux de change, parités quotidiennes du 10 novembre 2026 (1 EUR = 1,1214 USD)
Questions fréquentes sur Claude Fable 5.2
Quelle est la différence entre Claude Fable 5.2 et Claude Mythos 5.2 ?
C'est le même modèle sous-jacent, avec deux couches de protection différentes. Fable 5.2 applique des garde-fous renforcés en cybersécurité et en biologie, ce qui permet de l'ouvrir à tous les utilisateurs. Mythos 5.2 applique des protections plus permissives dans ces deux domaines et n'est accessible qu'à des organisations vérifiées via les programmes Life Sciences et Cyber d'Anthropic.
Combien coûte Claude Fable 5.2 en euros ?
Le tarif officiel est de 8 dollars le million de tokens en entrée et 40 dollars en sortie, soit environ 7,13 € et 35,67 € au taux de la Banque de France du 10 novembre 2026. Le mode rapide, qui accélère la génération jusqu'à 2,5 fois, double ces montants : environ 14,27 € en entrée et 71,34 € en sortie.
Faut-il passer à Fable 5.2 si on utilise déjà Claude ?
Pas pour un usage courant. Anthropic recommande explicitement Claude Opus 5.5 pour la plupart des tâches de code et de connaissance, et présente Fable 5.2 comme un outil réservé au travail technique le plus exigeant. Le basculement se justifie sur des migrations de code lourdes, de la recherche ou de l'automatisation complexe, où le coût par tâche aboutie peut être inférieur malgré un tarif unitaire plus élevé.
Les 41,3 % du Remote Labor Index sont-ils fiables ?
Ce chiffre est publié par Anthropic et n'a pas été reproduit par un évaluateur indépendant à la date de publication de cet article. Il correspond au niveau d'effort élevé, pas au réglage par défaut des applications. Il faut aussi le lire dans l'autre sens : 41,3 % de réussite signifie que 58,7 % des projets testés n'ont pas atteint le niveau d'un professionnel humain.
Cette sortie change-t-elle ma visibilité dans les IA ?
Potentiellement, oui, mais indirectement. Chaque nouvelle génération de modèles modifie les sources que les moteurs génératifs retiennent dans leurs réponses. Le bon réflexe est de refaire un relevé de citations dans les quinze jours suivant une sortie majeure, avec exactement les mêmes requêtes qu'au relevé précédent, afin que la comparaison ait un sens.