Tableaux et GEO : l’IA lit-elle vraiment vos données ?
94,7 % contre 62,5 %. C’est l’écart de fiabilité d’un même modèle de langage selon que la réponse tient dans une seule cellule de votre tableau ou qu’il faut croiser plusieurs critères pour la trouver. Le chiffre vient du benchmark TeleTables, publié par le centre de recherche de Huawei et construit sur 2 220 tableaux techniques. Il dit quelque chose d’utile à toute entreprise qui publie des comparatifs, des grilles tarifaires ou des fiches techniques : un tableau est l’un des formats les plus citables par ChatGPT, Gemini ou Perplexity, mais seulement s’il est construit pour être lu par une machine. Mal structuré, il devient une zone d’incertitude que les moteurs génératifs contournent. Voici ce que mesure la recherche, et les règles concrètes qui en découlent pour votre GEO.
-
- Dernière modification
16 novembre 2026 - 9 minutes de lecture
Un tableau est-il vraiment un bon format pour être cité par l’IA ?
Oui, à condition qu’il soit un vrai tableau HTML et que chaque réponse se lise dans une seule cellule. Un tableau donne au modèle ce qu’aucun paragraphe ne lui donne : une valeur, son unité, sa ligne et sa colonne, donc un fait entier et vérifiable qu’il peut reprendre tel quel dans sa réponse.
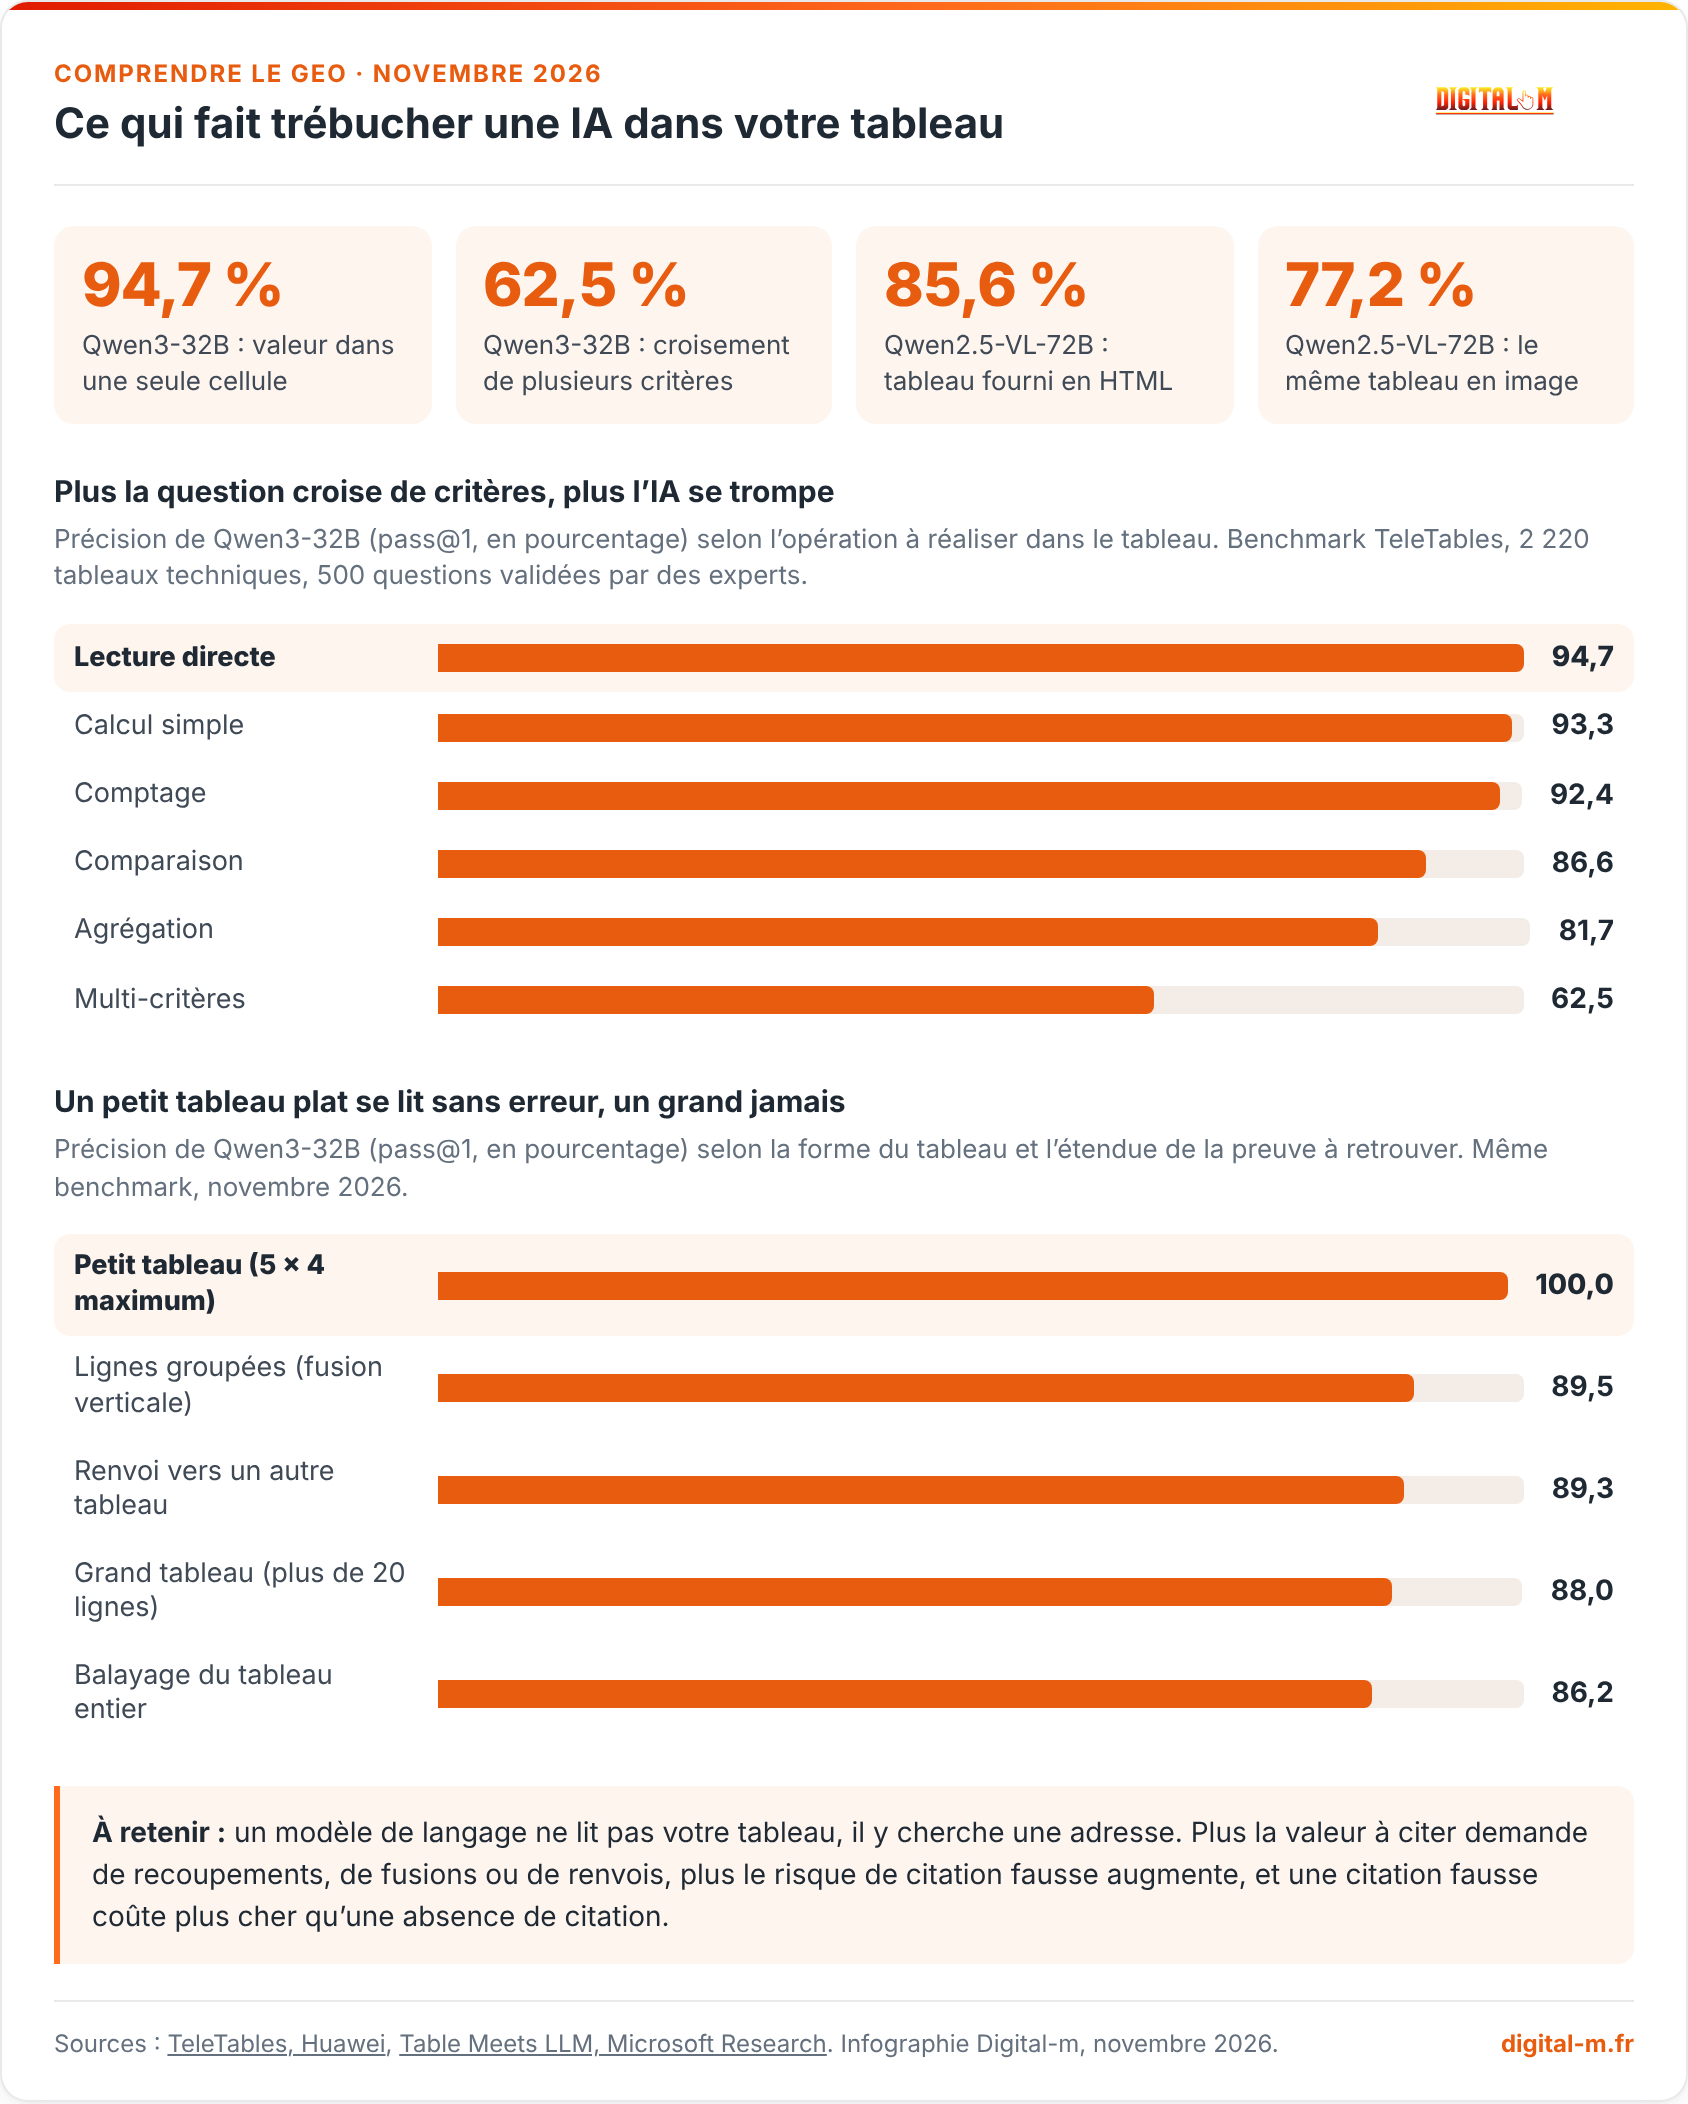
Les chiffres disponibles vont dans le même sens. Sur le benchmark TeleTables, soumis le 5 décembre 2025 par le centre de recherche de Huawei à Boulogne-Billancourt et mis à jour en septembre 2026, le modèle Qwen3-32B répond juste dans 94,7 % des cas lorsque la valeur demandée se trouve dans une cellule unique, et seulement 62,5 % des cas lorsqu’il faut croiser plusieurs critères. Sur les petits tableaux de cinq lignes et quatre colonnes au maximum, le score atteint 100 %. Sur les tableaux de plus de vingt lignes ou huit colonnes, il retombe à 88 %.
L’autre enseignement concerne le format d’affichage. Toujours sur TeleTables, le modèle multimodal Qwen2.5-VL-72B obtient 85,6 % de bonnes réponses quand le tableau lui est fourni en HTML, contre 77,2 % quand le même tableau lui est fourni en image. Huit points de précision partent dans la capture d’écran.
- Le format gagnant : le tableau HTML natif, avec une ligne d’en-têtes et une valeur par cellule.
- Le format perdant : le tableau exporté en image, invisible pour la majorité des moteurs qui travaillent sur le texte.
- La bonne taille : plutôt plusieurs petits tableaux thématiques qu’un seul grand tableau à vingt lignes.
- La bonne question : celle dont la réponse tient dans une cellule, pas celle qui oblige à recouper trois colonnes.
Horizon GEO • La newsletter
Être cité par ChatGPT, Gemini et Perplexity
Chaque semaine, nos analyses GEO, les chiffres qui comptent et les changements des moteurs IA, directement dans votre boîte mail.
1 e-mail par semaine • Désinscription en 1 clic
Ce que ces benchmarks mesurent, et ce qu’ils ne mesurent pas
Soyons précis, parce que c’est le point que la plupart des contenus GEO escamotent : ces travaux mesurent la capacité d’un modèle à répondre à une question sur un tableau qu’on lui a déjà donné. Ils ne mesurent pas la probabilité qu’un moteur de recherche aille chercher votre page et la cite. Ce sont deux étapes différentes de la même chaîne.
Cette nuance ne retire rien à leur utilité. Dans un moteur génératif, votre tableau finit nécessairement dans le contexte du modèle avant d’être résumé. S’il s’y perd, la citation n’a pas lieu, ou pire, elle a lieu avec la mauvaise valeur. Autrement dit, ces benchmarks mesurent le dernier mètre, celui qui décide si votre chiffre ressort juste.
Trois sources servent de base à cet article, et aucune n’est un test commercial d’éditeur d’outil. TeleTables porte sur 2 220 tableaux issus de treize spécifications techniques de téléphonie mobile, ce qui est un corpus plus aride que vos pages web, donc une limite à garder en tête. Table Meets LLM, publié par Microsoft Research et présenté à la conférence WSDM 2024, a introduit le benchmark SUC et ses sept tâches de lecture de tableaux. LTEM, mis en ligne sur arXiv le 21 octobre 2026 par l’université nationale de Chungnam et EurekaAI, compare six façons d’écrire un tableau pour un modèle de langage.
Un dernier repère, côté moteurs cette fois. L’étude du Wix Studio AI Search Lab, relayée par Search Engine Land sur 75 000 réponses d’IA et plus d’un million de citations, place les listicles à 21,9 % des citations, les articles à 16,7 % et les pages produit à 13,7 %. Les tableaux n’y forment pas une catégorie à part : ils vivent à l’intérieur de ces formats, et c’est précisément pour cela qu’ils méritent un soin particulier.
Ce qui fait trébucher une IA dans votre tableau

- 94,7 % Qwen3-32B : valeur dans une seule cellule
- 62,5 % Qwen3-32B : croisement de plusieurs critères
- 85,6 % Qwen2.5-VL-72B : tableau fourni en HTML
- 77,2 % Qwen2.5-VL-72B : le même tableau en image
Plus la question croise de critères, plus l’IA se trompe
Précision de Qwen3-32B (pass@1, en pourcentage) selon l’opération à réaliser dans le tableau. Benchmark TeleTables, 2 220 tableaux techniques, 500 questions validées par des experts.
Un petit tableau plat se lit sans erreur, un grand jamais
Précision de Qwen3-32B (pass@1, en pourcentage) selon la forme du tableau et l’étendue de la preuve à retrouver. Même benchmark, novembre 2026.
À retenir : un modèle de langage ne lit pas votre tableau, il y cherche une adresse. Plus la valeur à citer demande de recoupements, de fusions ou de renvois, plus le risque de citation fausse augmente, et une citation fausse coûte plus cher qu’une absence de citation.
Télécharger l’infographie (PNG)
Pourquoi le HTML gagne et pourquoi l’image perd
Le HTML gagne parce qu’il nomme explicitement les relations entre les cellules. Une balise d’en-tête dit « ceci est un titre de colonne », un attribut de fusion dit « cette cellule couvre trois lignes ». Le modèle n’a pas à devenir devin : la structure est écrite dans le code.
Table Meets LLM a chiffré cet avantage dès 2024. Sur les sept tâches du benchmark SUC, testées avec GPT-3.5, le HTML devance de 6,76 points le texte à simples séparateurs, le style tabulation ou point-virgule. L’écart est spectaculaire sur une tâche en particulier : la détection de la taille du tableau, où le HTML atteint 67 % contre 42 % pour le texte séparé. Les auteurs avancent une hypothèse, sans la démontrer : les modèles ont été massivement entraînés sur du code et des pages web, donc le HTML leur est familier.
Le papier LTEM d’octobre 2026 confirme la hiérarchie sur une tâche de génération de tableau, où le HTML obtient un score de 0,913 contre 0,549 pour le Markdown. Il rappelle aussi le revers : le HTML est le format le plus coûteux en tokens, les unités de texte que facture et traite un modèle. Dans ses mesures, un tableau pèse 392 tokens en HTML contre 149 en CSV. TeleTables aboutit au même constat, avec un Markdown qui consomme 42 % de tokens en moins que le HTML pour une précision voisine.
Pour vous, la conclusion est simple : vous publiez du HTML, vous n’avez rien à convertir. Le vrai sujet, c’est l’image. Google est explicite dans sa documentation sur les fonctionnalités IA, mise à jour le 10 décembre 2025 : il faut « s’assurer que le contenu important est disponible sous forme textuelle ». Un tableau exporté en PNG depuis un tableur n’est pas du texte. Il n’existe pas davantage pour un moteur génératif que pour un lecteur d’écran, comme nous le détaillons dans notre analyse de ce que Google et les IA lisent vraiment dans vos images.
| Façon de publier votre tableau | Lisible par un moteur IA | Coût en tokens | Verdict GEO |
|---|---|---|---|
| Tableau HTML natif | Oui, relations explicites | Élevé | Le choix par défaut |
| Markdown converti en HTML | Oui, 42 % de tokens en moins | Faible | Très bon, hors fusions |
| Liste à puces déguisée en tableau | Partiellement | Faible | Acceptable à 2 colonnes |
| Grille construite en CSS | Rarement, structure perdue | Moyen | À éviter |
| Image ou capture d’écran | Non pour les moteurs textuels | Très élevé | À bannir seule |
Les six règles d’un tableau citable
Ces six règles découlent directement des écarts mesurés plus haut. Elles s’appliquent à un comparatif de prestations, à une grille tarifaire comme à un tableau de caractéristiques techniques.
- Une seule ligne d’en-têtes : les en-têtes sur deux niveaux obligent le modèle à reconstruire la hiérarchie. Si vous avez besoin de deux niveaux, faites deux tableaux.
- Une valeur par cellule : pas de « 450 € HT, hors déplacement, à partir de 3 jours » dans une seule case. Trois informations, trois colonnes.
- L’unité dans l’en-tête : écrivez « Prix (€ HT) » et laissez « 450 » dans la cellule. Le modèle récupère l’unité une fois et l’applique à toute la colonne.
- Une phrase d’introduction juste avant : elle donne au tableau son contexte, sa période et sa source. C’est souvent elle qui est citée avec la valeur.
- Aucun renvoi de note : les astérisques renvoyant sous le tableau cassent le lien entre la valeur et sa condition. Intégrez la condition dans une colonne.
- Moins de dix lignes : le score passe de 100 % à 88 % entre un petit tableau et un tableau de plus de vingt lignes. Découpez par thème.
Chez Digital-m, nous auditons régulièrement des sites de PME dont les grilles tarifaires sont pourtant publiques et bien positionnées dans Google, mais qui n’apparaissent jamais dans les réponses IA. Dans la majorité des cas, le tableau est une image, ou chaque cellule contient trois informations empilées. La correction prend une heure et ne demande aucune refonte.
Cellules fusionnées et en-têtes à deux niveaux : le point de rupture
La fusion de cellules est le moment où un tableau cesse d’être une grille et devient un dessin. Le papier LTEM l’identifie comme le point de bifurcation décisif : à partir de la fusion, les formats légers comme le Markdown ou le CSV ne peuvent plus exprimer la structure du tout, et même le HTML ne fait que la décrire sans la résoudre. Le modèle doit reconstruire lui-même la position réelle de chaque cellule.
Les chiffres de TeleTables cadrent le risque sans l’exagérer. Les lignes groupées par fusion verticale descendent à 89,5 % de bonnes réponses, contre 93,2 % pour une valeur isolée dans une cellule unique. Ce n’est pas un effondrement, c’est une érosion : environ une réponse sur dix devient incertaine. Dans ce corpus, 28,4 % des tableaux ont des en-têtes sur plusieurs niveaux et 13,1 % des lignes groupées, ce qui en fait un défaut très répandu.
Le cas particulier du tableau de prix
Le tableau tarifaire concentre tous les pièges : une colonne fusionnée pour la famille de prestation, un astérisque pour la TVA, une mention « sur devis » qui remplace un chiffre. C’est aussi le tableau que vos prospects demandent le plus souvent à ChatGPT ou à Perplexity. Nos accompagnements en GEO commencent souvent par la remise à plat de cette seule page, parce que son rendement est immédiat.
Que faire d’un tableau déjà fusionné
Ne le supprimez pas, dédoublez-le. Un tableau à en-têtes fusionnés se découpe presque toujours en deux ou trois tableaux plats, chacun précédé d’un titre explicite. Vous gagnez sur les deux tableaux de bord : le modèle lit mieux, et le lecteur humain aussi.
Ce qui se perd quand votre tableau tombe dans un chunk
Les moteurs génératifs ne récupèrent pas vos pages entières, ils les découpent en passages de quelques centaines de mots avant de les comparer à la question. Un tableau de vingt lignes a donc toutes les chances d’être coupé en deux, et la seconde moitié arrive alors sans sa ligne d’en-têtes : des chiffres sans nom de colonne.
C’est la raison technique qui rend la règle des dix lignes bien plus importante qu’elle n’en a l’air. Un tableau court tient dans un seul passage, en-têtes comprises, et reste donc interprétable hors contexte. Nous détaillons cette mécanique dans notre guide pour découper votre contenu en passages autosuffisants.
Deux réflexes limitent les dégâts. D’abord, répéter l’information critique dans la phrase qui précède le tableau, par exemple « les tarifs ci-dessous sont exprimés en euros hors taxes, au 16 novembre 2026 ». Ensuite, donner à chaque tableau un titre de section propre, pour que le découpage se fasse sur une frontière logique plutôt qu’au milieu des données.
Les erreurs que nous voyons le plus souvent sur les sites de PME
Ces cinq erreurs reviennent dans presque chaque audit, toutes catégories d’activité confondues. Aucune ne demande de compétence technique avancée pour être corrigée.
- Le tableau en image : exporté depuis Excel ou Canva, parfois avec un texte alternatif vide. Invisible pour les moteurs textuels, et huit points de précision perdus même pour les modèles qui voient les images.
- Le faux tableau en blocs : construit avec des colonnes du constructeur de pages, il paraît aligné à l’écran mais ne contient aucune balise de tableau. La structure n’existe que visuellement.
- La cellule fourre-tout : prix, délai, condition et exception dans la même case. Le modèle doit découper une phrase au lieu de lire une valeur.
- L’unité absente : des nombres nus, sans euro, sans pourcentage, sans mètre carré. Le modèle devine, donc se trompe.
- Le tableau non daté : une grille tarifaire sans date de mise à jour, que les moteurs écartent au profit d’une source datée. Le même réflexe vaut pour vos propres données chiffrées.
Précisons une chose, parce que la confusion est fréquente : ajouter du balisage schema autour de votre tableau ne réglera rien. Google indique noir sur blanc qu’aucune donnée structurée particulière n’est nécessaire pour apparaître dans ses fonctionnalités IA, et nous avons déjà montré pourquoi le balisage schema n’est pas le levier GEO que l’on croit. Ce qui compte, c’est la structure du texte visible.
Ce qu’il faut retenir
Un tableau est l’un des rares formats où vous contrôlez entièrement la précision de ce qu’une IA pourra citer. La recherche de 2024 à 2026 converge sur trois points : le HTML natif est le format le mieux lu, l’image fait perdre huit points de précision, et un tableau court et plat approche les 100 % de lecture correcte quand un grand tableau fusionné plafonne à 88 %.
Les gestes à faire tiennent sur un coin de table : une ligne d’en-têtes, une valeur par cellule, l’unité dans l’en-tête, moins de dix lignes, pas de fusion, une date. Ce sont des corrections de trente minutes par page, pas un chantier. Et contrairement à beaucoup de leviers GEO, leur effet est vérifiable : reposez la question à ChatGPT, Gemini, Mistral ou Perplexity dans trois semaines et comparez la valeur citée.
Vous voulez savoir si vos tableaux sont lisibles par les moteurs génératifs ? Demandez un audit de visibilité GEO à notre équipe, ou formez votre rédacteur interne avec notre formation GEO certifiée Qualiopi. Nous repartons toujours de vos pages réelles, pas d’une liste de bonnes pratiques génériques.
Et vous, combien de vos tableaux sont encore de simples captures d’écran ? Dites-le nous en commentaire !Sources et références
- arXiv - TeleTables, benchmark Huawei sur l’interprétation des tableaux par les LLM (soumis le 5 décembre 2025, version 2 du 4 septembre 2026)
- arXiv - Table Meets LLM : Can Large Language Models Understand Structured Table Data ?, Microsoft Research, WSDM 2024 (17 février 2024)
- Microsoft Research - Improving LLM understanding of structured data and exploring advanced prompting methods (7 mars 2024)
- arXiv - LTEM : LLM-Friendly Table-Enhanced Markdown for Table Understanding and Generation (21 octobre 2026)
- Google Search Central - AI features and your website (mise à jour du 10 décembre 2025)
- Search Engine Land - AI citations favor listicles, articles, product pages, étude du Wix Studio AI Search Lab (2026)
Questions fréquentes sur les tableaux et le GEO
Les IA lisent-elles les tableaux HTML ?
Oui, et c’est le format qu’elles lisent le mieux. Sur le benchmark TeleTables, le HTML obtient les meilleurs scores pour la quasi-totalité des modèles testés, parce que son balisage nomme explicitement les relations entre les cellules. Le benchmark SUC de Microsoft Research mesurait déjà en 2024 un avantage de 6,76 points du HTML sur le texte à simples séparateurs.
Faut-il éviter les tableaux en image pour le GEO ?
Oui, du moins jamais seule. Un tableau en PNG ou JPEG n’existe pas pour les moteurs qui travaillent sur le texte, et même un modèle multimodal perd de la précision : 77,2 % de bonnes réponses sur image contre 85,6 % en HTML pour Qwen2.5-VL-72B. Google demande d’ailleurs que le contenu important soit disponible sous forme textuelle. Si vous tenez à l’image, doublez-la d’un vrai tableau HTML.
Combien de lignes un tableau doit-il compter au maximum ?
Visez moins de dix lignes par tableau. Les mesures de TeleTables donnent 100 % de bonnes réponses sur les tableaux de cinq lignes et quatre colonnes au maximum, contre 88 % au-delà de vingt lignes ou huit colonnes. S’ajoute une raison technique : un tableau long est coupé en deux lors du découpage en passages, et la seconde moitié perd sa ligne d’en-têtes.
Les cellules fusionnées pénalisent-elles vraiment les citations ?
Elles dégradent la lecture sans l’empêcher. TeleTables mesure 89,5 % de bonnes réponses sur des lignes groupées par fusion verticale, contre 93,2 % pour une valeur isolée dans une cellule unique, soit environ une réponse sur dix qui devient incertaine. Le papier LTEM d’octobre 2026 identifie la fusion comme le seuil au-delà duquel les formats légers comme le Markdown ne peuvent plus décrire la structure.
Le balisage schema aide-t-il mes tableaux à être cités ?
Non, pas directement. Google écrit dans sa documentation sur les fonctionnalités IA qu’aucune donnée structurée schema.org particulière n’est nécessaire pour apparaître dans AI Overviews ou AI Mode. La seule consigne liée au balisage est qu’il corresponde au texte visible de la page. Travaillez donc la structure du tableau lui-même avant de penser au schema.