Contenu rédigé par IA : les LLM le citent-ils vraiment ?
Onze virgule dix-neuf. C'est le nombre de tirets cadratins pour 10 000 mots relevés par le Pew Research Center dans les pages web publiées début 2026, contre 5,79 trois ans plus tôt. Le signe de ponctuation le plus discret du web a doublé, et il raconte une histoire : 35 % des pages datées d'après le lancement de ChatGPT portent des signes d'écriture par IA. La question que nous posent la plupart des dirigeants que nous accompagnons est donc légitime. Si tout le monde publie du texte généré, les moteurs génératifs continuent-ils de citer du contenu rédigé par IA ? Les études publiées en 2026 par Ahrefs, Semrush et Google apportent une réponse nette, et ce n'est ni « oui » ni « non ». C'est « oui, mais pas celui que vous pensez ».
-

- Dernière modification
11 novembre 2026 - 10 minutes de lecture
Les LLM citent-ils le contenu rédigé par IA ? La réponse en trois chiffres
Oui, les moteurs génératifs citent du contenu rédigé par IA, mais la part de texte généré reste minoritaire dans les pages les mieux exposées. Trois chiffres issus d'une analyse de 331 000 pages publiée par Ahrefs le 27 juillet 2026 cadrent le débat mieux que n'importe quel avis.
- 5,3 % : c'est la part des pages occupant le top 3 de Google que le détecteur d'Ahrefs classe à 100 % de texte généré. Le contenu rédigé par IA de bout en bout n'est donc ni interdit ni invisible.
- 82,2 % : c'est la part des pages du top 3 qui contiennent moins de 50 % de texte généré. La majorité de ce qui est cité et classé reste écrite par des humains, le contenu rédigé par IA n'y occupant qu'une fraction du texte.
- 2 à 3 fois : c'est l'écart d'impressions mesuré dans Google Search Console entre les pages sous 50 % de texte IA et celles au-delà de 80 %. Le contenu rédigé par IA n'est pas puni, il est simplement moins vu.
Autrement dit, la question « l'IA me fait-elle déclasser ? » est mal posée. La bonne question est : qu'est-ce que votre page apporte qu'aucune autre ne contient déjà ? C'est ce critère, et non l'outil qui a tapé les phrases, qui décide de votre présence dans les réponses de ChatGPT, Gemini, Perplexity ou Mistral.
Horizon GEO • La newsletter
Être cité par ChatGPT, Gemini et Perplexity
Chaque semaine, nos analyses GEO, les chiffres qui comptent et les changements des moteurs IA, directement dans votre boîte mail.
1 e-mail par semaine • Désinscription en 1 clic
35 % du web récent porte la trace d'une IA : ce que dit vraiment l'étude Pew
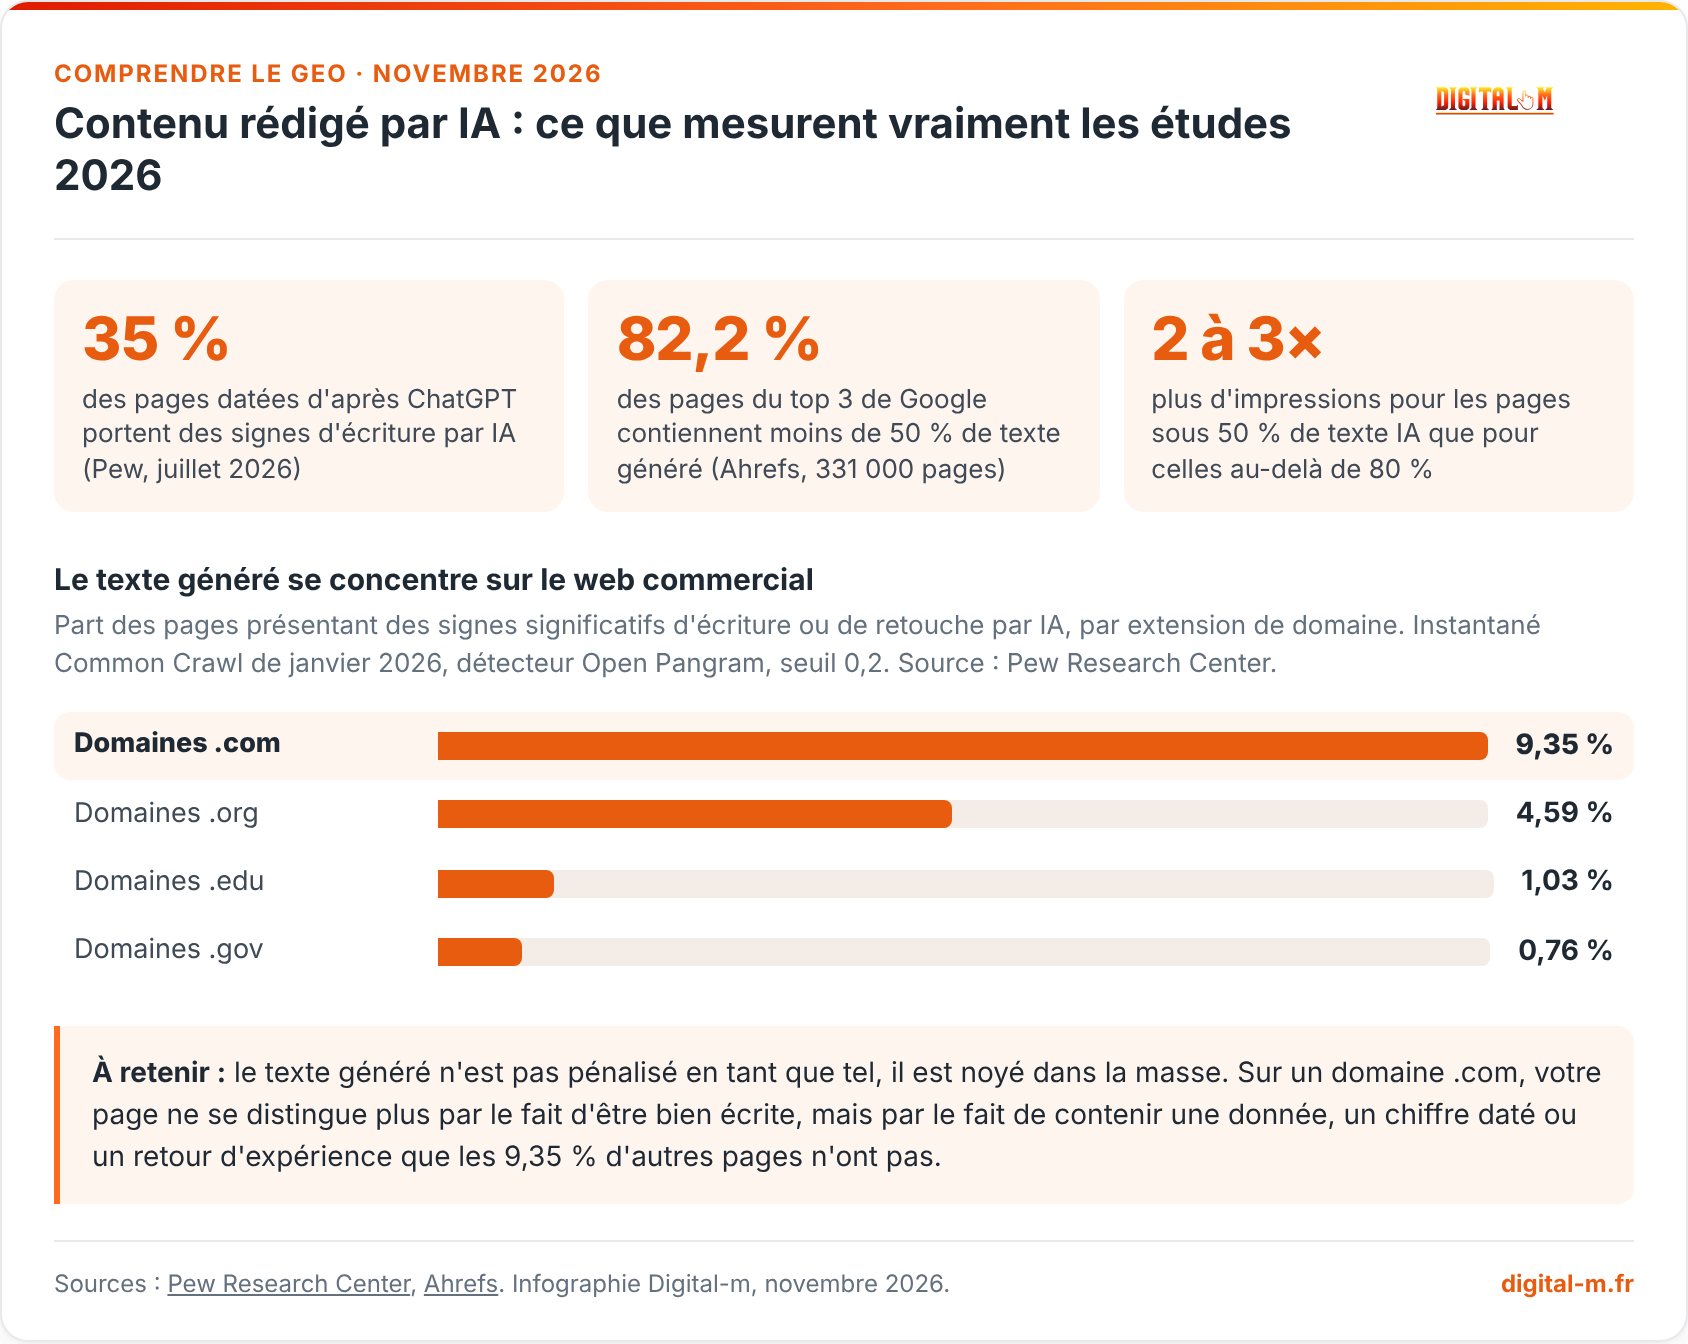
Le Pew Research Center a publié le 20 août 2026 la mesure la plus sérieuse disponible à ce jour sur la part de contenu rédigé par IA en ligne. Résultat principal : dans l'instantané de juillet 2026, 10 % de toutes les pages analysées présentent des signes significatifs d'écriture ou de retouche par IA, et la proportion monte à 35 % si l'on ne retient que les pages dont la date de publication est postérieure au 30 novembre 2022, jour du lancement de ChatGPT.
La méthode mérite d'être connue, parce qu'elle explique la prudence des chiffres. Pew a tiré au hasard 10 000 pages anglophones dans chacun des 49 instantanés mensuels de Common Crawl entre janvier 2021 et juillet 2026, soit 490 000 pages. Chaque texte a été passé dans Open Pangram, un détecteur open-weight (un modèle dont les poids sont publiés, donc inspectable par n'importe qui), qui renvoie un score de 0 à 1. Le seuil retenu est 0,2. Un contrôle sur 62 370 pages avec le détecteur commercial Pangram 3.3 donne un accord de 96 % et un coefficient kappa de Cohen de 0,61.
La concentration géographique du phénomène est frappante. Dans l'instantané de janvier 2026, les domaines en .com affichent 9,35 % de pages marquées, contre 4,59 % pour les .org, 1,03 % pour les .edu et 0,76 % pour les .gov. Le web commercial est donc deux fois plus touché que le web associatif, et dix fois plus que le web universitaire. Si votre site est un .com et vend quelque chose, vous jouez dans le segment le plus saturé.
Les limites que l'étude reconnaît elle-même
Pew est explicite sur ce que ses chiffres ne prouvent pas. Les détecteurs sont probabilistes et produisent des faux positifs, en particulier sur les pages antérieures à 2023. L'échantillon ne couvre que des pages anglophones présentes dans Common Crawl, ce qui sous-représente les sites protégés par abonnement ou connexion. Surtout, la part de 35 % ne porte que sur les 10 à 15 % de pages dont la date est détectable dans le code, et non sur un échantillon aléatoire du web entier. Cette lucidité méthodologique est exactement ce que Google demande désormais à votre propre contenu, et c'est aussi ce qui distingue une source citable d'une source ignorée. À noter que les éditeurs ne restent pas passifs sur l'identification des textes générés : ChatGPT marque désormais ses réponses d'un filigrane textuel.
Contenu rédigé par IA : ce que mesurent vraiment les études 2026

- 35 % des pages datées d'après ChatGPT portent des signes d'écriture par IA (Pew, juillet 2026)
- 82,2 % des pages du top 3 de Google contiennent moins de 50 % de texte généré (Ahrefs, 331 000 pages)
- 2 à 3× plus d'impressions pour les pages sous 50 % de texte IA que pour celles au-delà de 80 %
Le texte généré se concentre sur le web commercial
Part des pages présentant des signes significatifs d'écriture ou de retouche par IA, par extension de domaine. Instantané Common Crawl de janvier 2026, détecteur Open Pangram, seuil 0,2. Source : Pew Research Center.
À retenir : le texte généré n'est pas pénalisé en tant que tel, il est noyé dans la masse. Sur un domaine .com, votre page ne se distingue plus par le fait d'être bien écrite, mais par le fait de contenir une donnée, un chiffre daté ou un retour d'expérience que les 9,35 % d'autres pages n'ont pas.
Télécharger l'infographie (PNG)
Google sanctionne-t-il le contenu rédigé par IA ?
Non, et c'est le titre même de l'étude d'Ahrefs, signée Ryan Law le 27 juillet 2026 : Google ne punit pas le contenu rédigé par IA, il punit le mauvais contenu. Le niveau de texte généré n'est pas neutre, mais son effet est un dégradé, pas un couperet. Le niveau moyen détecté passe de 27,1 % en position 1 à 30,9 % en position 10 : une pente réelle, et très douce.
Le signal le plus utile concerne l'indexation. Les pages contenant moins de 20 % de texte généré sont indexées dans 49,28 % des cas, contre 40,35 % pour celles au-delà de 80 %. L'écart existe, mais il faut le lire dans l'autre sens aussi : quatre pages sur dix massivement générées sont tout de même indexées par Google. Il n'y a donc pas de classifieur binaire qui éjecterait le contenu rédigé par IA.
Deux précautions avant d'utiliser ces chiffres. D'abord, la détection repose sur le détecteur maison d'Ahrefs, non vérifié par un tiers indépendant, et qui ne se déclenche qu'au-delà de 350 mots par page. Ensuite, l'étude est corrélative : Ryan Law écrit lui-même que l'explication la plus probable est qu'un usage croissant de l'IA accompagne une baisse de la qualité, sans qu'aucune causalité ne soit établie. L'étude de Semrush du 1er avril 2026, menée sur 42 000 pages de blog avec le détecteur tiers GPTZero, va dans le même sens : en position 1, la probabilité d'un contenu classé humain est de 80,5 %, contre 10 % pour un contenu classé généré. À partir de la position 5, l'écart se resserre nettement. Si vos pages stagnent sans explication, le problème relève souvent d'une erreur GEO classique plutôt que de l'outil de rédaction.
Le 1er octobre 2026, Google a durci sa consigne sur le contenu rédigé par IA
Google a modifié sa documentation officielle sur l'usage de l'IA génératrice de contenu le 1er octobre 2026, en y intégrant des éléments issus des Search Quality Raters Guidelines. Le changement tient en trois phrases ajoutées, et elles sont sans ambiguïté : il est « critical to manually factcheck and review all AI-generated content », soit vérifier manuellement et relire tout contenu généré avant publication.
Google explique pourquoi : un modèle génératif ne récupère pas des faits, il prédit une suite de mots probable. De là viennent les hallucinations, ces affirmations fausses énoncées avec aplomb. Et la relecture ne s'arrête pas au corps du texte.
- Les métadonnées aussi : balises title, meta descriptions, données structurées et textes alternatifs des images sont explicitement cités, parce qu'ils peuvent apparaître dans les résultats de recherche.
- Le scaled content abuse : produire de nombreuses pages sans valeur ajoutée pour l'utilisateur relève de la politique anti-spam de Google, quel que soit l'outil employé. Les sections 4.6.5 et 4.6.6 des consignes aux évaluateurs servent de grille de lecture.
- La transparence sur la création : Google suggère, sans l'imposer, d'indiquer comment un contenu automatisé a été produit.
- Pour l'e-commerce : Google Merchant Center exige que les images générées portent la métadonnée IPTC DigitalSourceType à la valeur TrainedAlgorithmicMedia, et que les titres et descriptions produits par IA soient fournis séparément et étiquetés comme tels.
Chez Digital-m, nous auditons régulièrement des sites dont les articles sont relus avec soin mais dont les 200 balises title et meta descriptions ont été générées en lot, puis jamais vérifiées. C'est précisément le trou que la mise à jour d'octobre vise, et c'est souvent le correctif le plus rapide à appliquer.
Pourquoi un brouillon d'IA non retravaillé a peu de chances d'être cité
Un contenu rédigé par IA et publié sans retouche a peu de chances d'être cité pour une raison structurelle, et elle n'a rien à voir avec une sanction. Un modèle de langage produit, par construction, une recombinaison de ce qui existe déjà dans ses données. Un brouillon livré tel quel ne contient donc aucune information qu'un moteur génératif ne puisse trouver ailleurs. Or une citation sert à sourcer une affirmation que le modèle ne peut pas produire seul : un chiffre, une date, une méthode, un prix, un retour de terrain.
C'est ce que confirme l'étude GEO: Generative Engine Optimization, menée par des chercheurs de Princeton, de l'IIT Delhi et de Georgia Tech, et présentée à la conférence ACM SIGKDD 2024. En testant des variantes de contenu sur des moteurs génératifs, les auteurs mesurent des gains de visibilité très inégaux selon la modification appliquée.
- +132,4 % : le gain de visibilité obtenu en ajoutant des citations de sources au contenu.
- +89,1 % : le gain obtenu en adoptant un ton plus autoritaire et affirmatif.
- +65,5 % : le gain obtenu en insérant des statistiques pertinentes.
Ces trois leviers ont un point commun : aucun n'est produit par défaut par un modèle à qui l'on demande « écris-moi un article sur X ». Ils supposent une collecte, une vérification et un choix éditorial. C'est aussi la raison pour laquelle les données originales restent l'arme la plus efficace du GEO. Et puisque l'emplacement compte autant que le contenu, rappelons que notre propre analyse montre que 44,2 % des citations de ChatGPT viennent du premier tiers d'un article : votre donnée exclusive n'a rien à faire en conclusion.
Les cinq signaux qui trahissent un contenu rédigé par IA non relu
Les données de Pew sur l'évolution du style web permettent de dresser une liste de marqueurs mesurables. Aucun ne constitue une preuve isolée, Pew le souligne, mais leur accumulation sur un site entier est un signal fiable, pour un lecteur comme pour un évaluateur qualité.
- Le tiret cadratin : sa fréquence est passée de 5,79 à 11,19 occurrences pour 10 000 mots entre janvier 2023 et janvier 2026 dans les pages datées d'après ChatGPT. C'est le marqueur le plus visible, et la raison pour laquelle nous l'avons banni de nos rédactions.
- La virgule d'Oxford : en hausse de 63 % sur la même période, un usage typiquement anglo-saxon qui détonne dans un texte français.
- Le vocabulaire marqueur : Pew identifie une liste de termes dont l'usage a plus que doublé, parmi lesquels « delve », « interplay », « tapestry », « testament », « crucial », « pivotal » et « landscape ». Leurs équivalents français, « paysage », « crucial », « témoignage », « il est essentiel de », suivent la même courbe.
- Le parallélisme négatif : la construction « ce n'est pas seulement X, c'est Y » a presque triplé de fréquence, même si elle reste rare en valeur absolue.
- L'absence de données propres : le signal le plus coûteux. Un article sans chiffre daté, sans source nommée et sans exemple vécu ne donne à aucun moteur génératif de raison de le citer plutôt qu'un autre.
Ce dernier point est celui que nous traitons en priorité dans nos formations GEO : apprendre à produire la donnée que personne d'autre n'a, puis la placer au bon endroit, vaut mieux que publier dix articles corrects de plus.
Trois usages de l'IA, trois résultats en GEO
Tout contenu rédigé par IA ne se vaut pas, parce que tous les usages de l'IA en rédaction ne se valent pas. Voici comment se comportent les trois scénarios que nous rencontrons le plus souvent chez nos clients PME, artisans et commerçants.
| Usage de l'IA | Ce que vous obtenez | Risque principal | Verdict GEO |
|---|---|---|---|
| Génération brute publiée telle quelle | Du volume, vite, à coût marginal quasi nul | Scaled content abuse, erreurs factuelles non détectées, indexation à 40 % | Peu de citations, car aucune information nouvelle à sourcer |
| Génération puis relecture et enrichissement | Un texte exact, structuré, enrichi de vos chiffres et de vos cas clients | Temps de relecture sous-estimé, métadonnées oubliées | Comparable à une rédaction humaine : c'est le scénario majoritaire du top 3 |
| IA en support, rédaction humaine | Recherche accélérée, plan, reformulation, contrôle de cohérence | Coût horaire plus élevé, cadence de publication plus lente | Le plus sûr, surtout sur les sujets où votre expertise est le produit |
Le scénario qui échoue le plus souvent
Ce n'est pas le premier, c'est le deuxième mal exécuté. Une équipe génère quarante articles, en relit cinq sérieusement, et considère le lot comme traité. Les trente-cinq autres partent avec des affirmations non vérifiées et des balises title générées en masse. Le résultat est un site dont la moyenne de qualité baisse pendant que le nombre d'URL augmente, exactement la configuration que Google décrit dans sa politique sur le contenu produit à l'échelle. Si vous avez un doute sur l'état réel de votre site, un audit GEO permet de mesurer la part de vos pages réellement citables avant d'en publier d'autres.
Ce qu'il faut retenir
Les moteurs génératifs citent bien du contenu rédigé par IA, et Google l'indexe. Mais la mesure est sans appel sur un point : ce qui se fait citer, ce n'est pas un texte bien tourné, c'est une information que le modèle ne pouvait pas produire sans vous.
- Le constat : 35 % des pages récentes portent des signes d'écriture par IA (Pew, juillet 2026), mais 82,2 % des pages du top 3 de Google contiennent moins de 50 % de texte généré (Ahrefs, juillet 2026).
- La règle Google : depuis le 1er octobre 2026, la vérification manuelle de tout contenu généré est présentée comme critique, métadonnées comprises.
- Le levier GEO : citer ses sources apporte jusqu'à +132,4 % de visibilité dans les moteurs génératifs selon l'étude GEO présentée à KDD 2024. C'est le geste le plus rentable, et le plus souvent oublié.
- Le réflexe à prendre : avant de publier, posez-vous une seule question. Quelle phrase de cette page un LLM ne pourrait-il écrire sans la lire ? Si la réponse est « aucune », l'article ne sera pas cité.
L'IA est un excellent assistant de rédaction et un très mauvais producteur de preuves. Vous voulez savoir où se situe votre site sur ce curseur ? Demandez un audit GEO à Digital-m, ou formez votre équipe avec notre formation GEO certifiée Qualiopi pour intégrer ces réflexes dès la production.
Et vous, quelle part de votre contenu passe aujourd'hui par une vérification manuelle avant publication ? Dites-le nous en commentaire !Sources et références
- Pew Research Center - How Much of the Internet Is Written With AI? (20 août 2026)
- Pew Research Center - Methodology: Measuring AI authorship on the web (20 août 2026)
- Ahrefs - Google Doesn't Punish AI Content; It Punishes Bad Content (331k Pages Studied), Ryan Law (27 juillet 2026)
- Semrush - Does AI content rank well in search? Survey and data study, Margarita Loktionova (1er avril 2026)
- Google Search Central - Google Search's guidance on using generative AI content on your website (mise à jour du 1er octobre 2026)
- Google Search Central - Spam policies for Google web search : scaled content abuse
- Search Engine Journal - Google Tells Sites To Fact-Check AI Content Before Publishing, Matt G. Southern (1er octobre 2026)
- arXiv - GEO: Generative Engine Optimization, Aggarwal et al., ACM SIGKDD 2024
- Google Merchant Center - Règles relatives au contenu généré par IA
Questions fréquentes sur le contenu rédigé par IA et le GEO
Google pénalise-t-il le contenu rédigé par IA ?
Non, pas en tant que tel : Google ne cible pas le contenu rédigé par IA, il sanctionne le contenu produit en masse sans valeur ajoutée, ce qu'il nomme scaled content abuse, quel que soit l'outil utilisé. L'étude Ahrefs de juillet 2026 montre que 5,3 % des pages du top 3 sont détectées comme intégralement générées, et que 40,35 % des pages massivement générées restent indexées. La documentation Google mise à jour le 1er octobre 2026 demande en revanche une vérification manuelle de tout contenu généré avant publication.
Les LLM comme ChatGPT ou Perplexity détectent-ils le contenu IA avant de citer une page ?
Aucun éditeur, ni OpenAI, ni Google, ni Perplexity, ni Mistral, n'a publié à ce jour de critère de détection du texte généré pour filtrer ses citations. Cette information n'est pas confirmée et rien ne permet de l'affirmer. Ce qui est documenté, en revanche, c'est que les moteurs génératifs privilégient les pages qui apportent une information sourçable, chiffrée et datée. Un contenu généré sans donnée propre échoue donc sur ce critère, pas sur une détection.
Faut-il indiquer qu'un article a été rédigé avec l'aide d'une IA ?
Google le suggère sans l'imposer : sa documentation invite à donner du contexte sur la façon dont un contenu automatisé a été créé. Pour l'e-commerce, c'est en revanche une obligation chez Google Merchant Center, où les images générées doivent porter la métadonnée IPTC DigitalSourceType à la valeur TrainedAlgorithmicMedia. Pour un blog, la mention est surtout un signal de transparence qui sert votre crédibilité auprès des lecteurs.
Quelle part de texte généré est acceptable dans un article ?
Aucun seuil officiel de contenu rédigé par IA n'existe, et Google n'en publie pas. Les données disponibles donnent un repère utile : 82,2 % des pages du top 3 de Google contiennent moins de 50 % de texte détecté comme généré, et le niveau médian en position 1 est de 17,1 % selon Ahrefs. Ce ne sont pas des règles mais des ordres de grandeur. La question à se poser porte sur la part de contenu original, pas sur la part de texte généré.
Les détecteurs de contenu IA sont-ils fiables ?
Modérément, et uniquement à grande échelle. Aucun détecteur ne permet d'affirmer avec certitude qu'une page précise est un contenu rédigé par IA. Pew Research Center obtient 96 % de concordance et un kappa de Cohen de 0,61 entre deux détecteurs, ce qui est correct pour analyser des centaines de milliers de pages, mais insuffisant pour juger un article isolé. Pew écrit d'ailleurs que les classements de pages individuelles ne doivent pas être pris pour des verdicts définitifs. Ne fondez jamais une décision éditoriale sur le score d'un détecteur appliqué à un seul texte.