L'IA accélère-t-elle la recherche scientifique ?
Une intelligence artificielle a devancé des médecins de 47 points sur les cas cliniques les plus difficiles. Aucun patient n'était dans la pièce. Ce décalage résume l'état réel de l'IA scientifique en octobre 2026 : des résultats spectaculaires, obtenus en simulation, dont presque aucun n'a encore passé l'épreuve du laboratoire ou de la clinique. En trois semaines, Microsoft, Google DeepMind, OpenAI et Anthropic ont tous annoncé des percées en médecine, en biologie, en chimie et en observation de la Terre. Deux seulement sont passées par une revue à comité de lecture. Nous avons trié annonce par annonce ce qui est mesuré, ce qui est auto-évalué et ce qui relève encore de la déclaration de dirigeant.
-
- Dernière modification
25 octobre 2026 - 10 minutes de lecture
Ce que l'IA a réellement produit en science en octobre 2026
Quatre annonces structurent le mois : un système multi-agents de Microsoft qui surpasse des médecins sur des cas écrits, des milliers d'agents d'OpenAI lâchés sur un atlas du cerveau de souris, un candidat antibiotique identifié par Google DeepMind, et une carte mondiale des types de forêts publiée par la même équipe. Le partage est net et il mérite d'être posé d'emblée.
- Validé par une revue à comité de lecture : l'étude médicale de Microsoft, publiée dans la revue Science, et la carte forestière ForTy, publiée dans Scientific Data.
- Préprint non encore évalué : le travail d'OpenAI sur les données neurobiologiques, déposé sur bioRxiv le 15 octobre 2026.
- Auto-évaluation d'entreprise : le candidat antimicrobien de Google DeepMind, présenté dans un billet technique, sans publication scientifique.
- Déclaration non vérifiée : la « superintelligence médicale » annoncée par Mustafa Suleyman chez Microsoft, qui est un objectif affiché, pas un résultat.
Aucune de ces quatre annonces ne rapporte de résultat expérimental obtenu en laboratoire ou sur des patients réels. C'est le point le plus important de cet article, et il est rarement en tête des communiqués.
Horizon GEO • La newsletter
L’IA expliquée simplement, chaque semaine
Nos décryptages IA les plus clairs, l’actu des modèles et des cas concrets pour votre entreprise, directement dans votre boîte mail.
1 e-mail par semaine • Désinscription en 1 clic
Médecine : 83 % de bonnes réponses sur les cas les plus difficiles
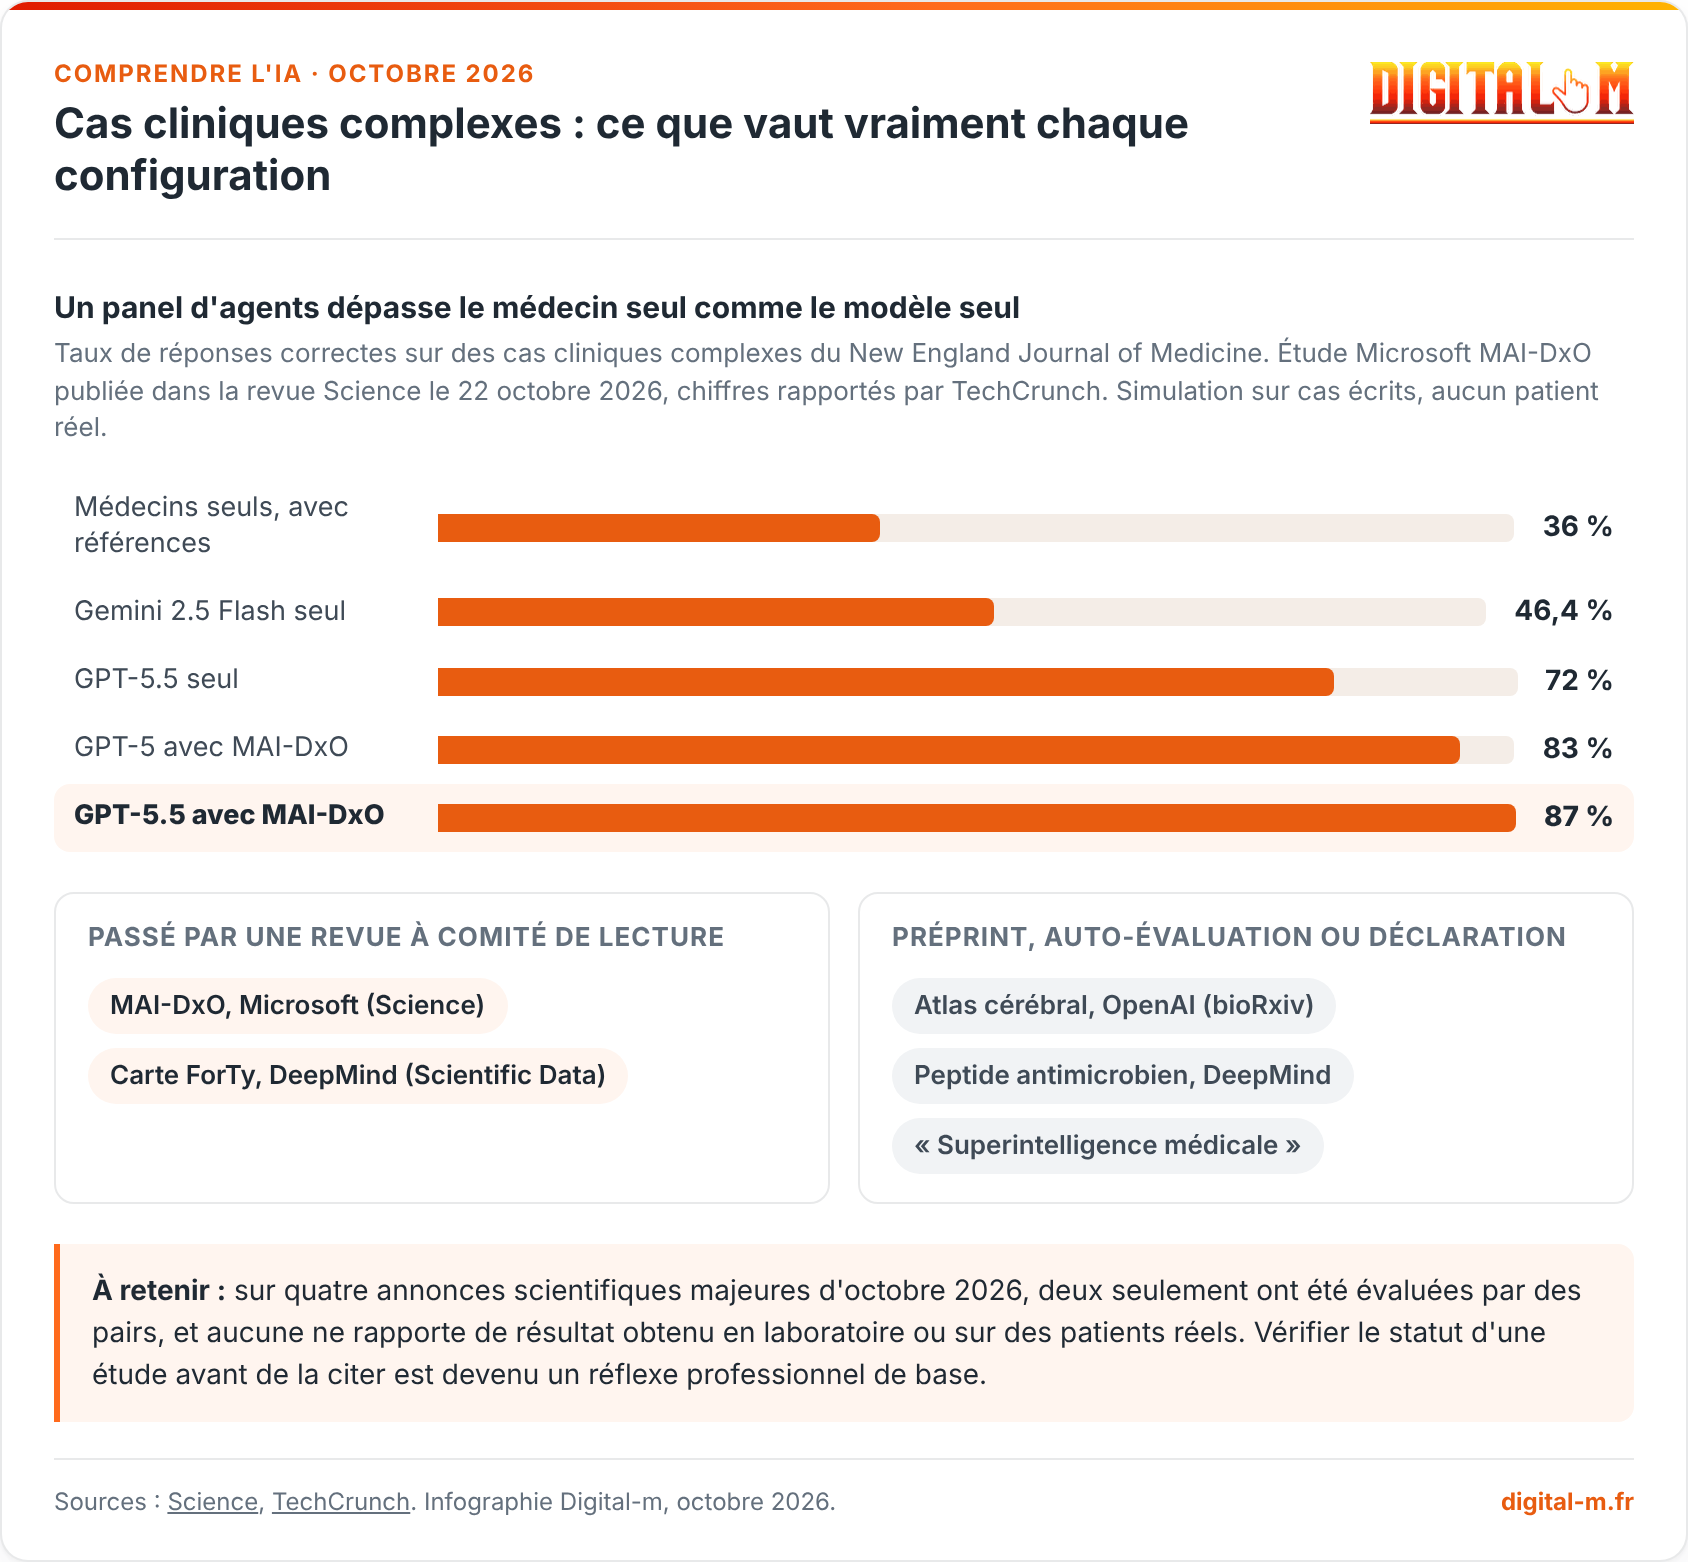
Le 22 octobre 2026, Microsoft a publié dans la revue Science une étude sur MAI-DxO, un système qui fait travailler ensemble plusieurs agents d'IA jouant le rôle d'un panel de médecins. Testé sur des cas cliniques complexes issus du New England Journal of Medicine, le système atteint 83 % de réponses correctes, contre 36 % pour des médecins de premier recours et des internistes travaillant seuls, avec accès à des références.
Le détail des chiffres est instructif, car il montre que l'orchestration compte autant que le modèle. GPT-5 seul obtient 78,9 % pour un coût d'environ 7 500 euros par cas. Avec MAI-DxO, le coût baisse d'environ 2 700 euros et la précision gagne près de 4 points. GPT-5.5 seul plafonne à 72 %, mais atteint près de 87 % une fois orchestré. Gemini 2.5 Flash passe de 46,4 % à près de 69 %.
Trois réserves, que l'étude et sa couverture par TechCrunch posent elles-mêmes. D'abord, les cas de ce niveau sont normalement traités par des spécialistes ou des équipes, qui n'étaient pas dans la comparaison. Ensuite, sur les situations d'urgence, le gain est faible ou nul. Enfin, une large part de la progression vient simplement de modèles sous-jacents plus puissants, pas de l'architecture multi-agents. Une évaluation avec le Beth Israel Deaconess Medical Center de Boston est annoncée, sans résultat disponible.
Cas cliniques complexes : ce que vaut vraiment chaque configuration

Un panel d'agents dépasse le médecin seul comme le modèle seul
Taux de réponses correctes sur des cas cliniques complexes du New England Journal of Medicine. Étude Microsoft MAI-DxO publiée dans la revue Science le 22 octobre 2026, chiffres rapportés par TechCrunch. Simulation sur cas écrits, aucun patient réel.
Passé par une revue à comité de lecture
Préprint, auto-évaluation ou déclaration
À retenir : sur quatre annonces scientifiques majeures d'octobre 2026, deux seulement ont été évaluées par des pairs, et aucune ne rapporte de résultat obtenu en laboratoire ou sur des patients réels. Vérifier le statut d'une étude avant de la citer est devenu un réflexe professionnel de base.
Télécharger l'infographie (PNG)
Biologie : des milliers d'agents lâchés sur un atlas du cerveau
Le 21 octobre 2026, OpenAI a publié avec PerturbAI et le Scripps Research Institute un travail où des milliers d'agents fondés sur son modèle GPT-Rosalind analysent un atlas CRISPR du cerveau de souris couvrant plusieurs millions de cellules. Le traitement aurait pris 32 minutes.
Deux chiffres mesurent l'apport du nombre. À son volume maximal, le dispositif distribué cite plus de 700 références scientifiques, contre 11 pour un agent unique sur la même tâche. Dans des comparaisons en aveugle, des experts humains ont préféré les rapports produits par le collectif d'agents dans 75 % des cas. Attention, le nombre d'experts et de comparaisons n'est pas précisé, et il s'agit d'un test réalisé par l'éditeur lui-même, sans vérification par un tiers indépendant.
Les pistes identifiées, autour des gènes Tsc1 et Tsc2 dans le cervelet et d'un lien entre DCTN1 et le cholestérol, sont des hypothèses. Elles portent sur des données de souris, et le préprint déposé sur bioRxiv n'a pas été évalué par des pairs. Le titre de l'annonce évoque Alzheimer et Parkinson « en minutes plutôt qu'en mois », formulation que le corps du texte ne soutient pas. C'est exactement le type de décalage entre titre et contenu que nous apprenons à repérer dans nos formations, et que l'on retrouve dans beaucoup de communications d'éditeurs sur les benchmarks des LLM.
Antibiotiques : un candidat trouvé par ordinateur, pas encore testé
Le 15 octobre 2026, une équipe de Google DeepMind emmenée par Pengfei Tian et Lucy J. Colwell a présenté un environnement de travail scientifique agentique intégré à Google Antigravity, couplé au modèle ProtNLM qui prédit la fonction biologique d'une séquence d'acides aminés.
Le résultat tient en un candidat : une bactériocine de 97 acides aminés, référencée A0A0U0D591 dans la base UniProt, appartenant à la famille Lactococcin 972 et issue de la bactérie Streptococcus pseudopneumoniae. Son activité contre des pathogènes respiratoires est prédite, pas observée.
L'équipe est honnête sur le statut de ce résultat : la piste est jugée « biologiquement plausible » et « nécessite encore une validation en laboratoire humide », validation qui est en cours. Toutes les vérifications décrites sont informatiques : comparaison de séquences avec BLAST contre la base Swiss-Prot, prédiction de structure avec AlphaFold, recherche de similarité structurale avec Foldseek. Le mécanisme d'action proposé reste une hypothèse tirée de la littérature.
L'enjeu, lui, est réel. L'antibiorésistance est associée à une estimation de 10 millions de décès annuels dans le monde à l'horizon 2050, chiffre externe repris par DeepMind. Trouver des pistes plus vite a donc du sens. Mais entre une séquence plausible et un médicament, il y a des années d'essais, et ce délai n'est indiqué nulle part dans l'annonce.
Climat : la première carte mondiale des types de forêts
Le 22 octobre 2026, Google DeepMind a publié ForTy, une carte mondiale à 10 mètres de résolution qui ne se contente pas de dire où il y a des arbres, mais classe les terres en six catégories définies par la FAO : forêt primaire, forêt naturellement régénérée, forêt plantée, plantation, cultures pérennes et agroforesterie, autres terres. Une série temporelle couvrant 2017 à 2025 l'accompagne, en version préliminaire.
C'est le travail le plus solidement validé du lot. Le modèle a été entraîné sur environ 1,7 million de localisations annotées, puis évalué sur plus de 9 000 sites tirés au hasard, chacun étudié par deux experts indépendants. Résultat : le type de forêt est correct dans 90 % des cas, et la distinction entre forêt et non-forêt dans 95 % des cas. Les données sont publiées sous licence ouverte sur Google Earth Engine, et l'article est paru dans Scientific Data.
Une nuance d'indépendance s'impose malgré tout : le World Resources Institute et l'IIASA, cités comme validateurs du projet, en sont aussi co-auteurs. Et les chiffres de précision concernent la carte 2020, pas la série temporelle, encore en version préliminaire.
Ce que ces annonces ne disent pas
Quatre angles morts reviennent systématiquement dans la communication scientifique des éditeurs d'IA, et il vaut la peine de les nommer.
- Le vide expérimental : aucune des quatre annonces ne rapporte de résultat obtenu en laboratoire ou sur des patients. Les validations sont informatiques, les comparaisons portent sur des cas écrits.
- Les délais absents : aucune annonce n'indique combien de temps sépare la piste de l'application. Pour un antibiotique, l'ordre de grandeur habituel se compte en années.
- Les chiffres d'éditeur : les « 32 minutes » et les « 75 % de préférence » viennent d'un test réalisé par OpenAI sur son propre système. Ce sont des mesures internes, pas des résultats reproduits par un tiers.
- La projection prise pour un fait : Mustafa Suleyman annonce une percée sur les dossiers médicaux « en 2027 » et un système « un ordre de grandeur meilleur d'ici 24 à 36 mois ». Ce sont des objectifs d'entreprise, pas des résultats.
Ajoutons une limite technique de fond. Les modèles qui produisent ces hypothèses restent sujets aux hallucinations, c'est-à-dire à la production d'affirmations plausibles mais fausses. Citer 700 références est impressionnant, encore faut-il que les 700 existent et disent bien ce qu'on leur fait dire. C'est précisément pour cela que la validation humaine et expérimentale reste le seul juge, et qu'elle prend du temps.
Qui paie ? Argent public, argent privé et accès aux modèles
Derrière les publications, un mouvement de financement s'est accéléré en octobre 2026.
- Anthropic et la Genesis Mission : le 8 octobre 2026, l'entreprise annonce un engagement de 134 millions d'euros sur trois ans dans cette initiative fédérale américaine portée par le département de l'Énergie. Claude devient accessible à plus de 15 agences, dont la NASA, les NIH et la NSF, avec des crédits pour plusieurs centaines de projets de recherche.
- Anthropic et les chercheurs invités : le 22 octobre 2026, l'entreprise ouvre un appel à candidatures pour des collaborations de 8 à 12 semaines en sciences du vivant, avec accès gratuit aux modèles, publication des résultats et code en open source, les chercheurs conservant leurs droits sur leurs données.
- OpenAI et la biotech : le 20 octobre 2026, l'entreprise rachète Orchestra Bio, une jeune pousse de quatre ans spécialisée dans les agents IA pour les opérations de biotechnologie. Le montant n'est pas divulgué, la société avait levé environ 17,8 millions d'euros en 2025. L'équipe rejoint la plateforme Rosalind.
Le point à retenir pour une entreprise française : ces investissements orientent la recherche vers les modèles propriétaires de trois ou quatre acteurs américains. Anthropic reconnaît d'ailleurs ouvertement que « les résultats sur la plupart des problèmes ouverts prendront bien plus de temps à valider ». La vitesse promise n'est pas celle de la science, c'est celle de la production d'hypothèses.
Ce qu'une PME peut en retenir dès aujourd'hui
Vous ne faites pas de recherche biomédicale, et nous non plus. Mais la méthode employée dans ces travaux se transpose, et elle est bien plus accessible qu'il n'y paraît.
- Le collectif bat l'individu : le résultat le plus net de ces travaux n'est pas qu'un modèle soit devenu plus intelligent, c'est que plusieurs agents coordonnés font mieux qu'un seul. C'est la logique de l'IA agentique, applicable à une veille concurrentielle ou à un audit de contenus.
- Le coût compte autant que la performance : MAI-DxO gagne des points tout en réduisant la facture. Transposé à une PME, cela veut dire qu'un petit modèle bien orchestré bat souvent un gros modèle mal utilisé.
- La vérification n'est pas optionnelle : la différence entre une piste et un résultat se mesure. C'est aussi vrai pour un diagnostic médical que pour une promesse de gain de temps, sujet que nous avons traité dans notre article sur la productivité de l'IA.
- Le réel reste le juge : c'est aussi la limite des modèles de langage face au monde physique, que nous avons explorée à propos des world models.
Dans nos accompagnements chez Digital-m, nous retrouvons systématiquement le même écueil : une entreprise teste un outil d'IA, constate un résultat impressionnant sur trois exemples, et généralise. Les trois exemples sont le préprint. Le passage à l'échelle, mesuré, est la revue à comité de lecture. Beaucoup de projets d'IA en entreprise s'arrêtent à la première étape.
Ce qu'il faut retenir
Octobre 2026 a été un mois dense pour l'IA scientifique, mais la lecture honnête est nuancée. Deux travaux sur quatre sont passés par une revue à comité de lecture : l'étude médicale de Microsoft dans Science, avec 83 % de bonnes réponses contre 36 % pour des médecins seuls, et la carte forestière ForTy de DeepMind, correcte à 90 % sur le type de forêt. Les deux autres sont un préprint et une auto-évaluation d'entreprise.
Aucun résultat de laboratoire, aucun patient réel, aucun délai d'application annoncé. L'IA accélère donc bien quelque chose, mais pas la science dans son ensemble : elle accélère la production d'hypothèses. La validation, elle, reste au rythme du réel.
Ce réflexe de tri, entre ce qui est mesuré et ce qui est annoncé, est exactement celui que nous transmettons dans nos formations certifiées Qualiopi sur l'IA et le GEO. Si vous voulez faire le point sur vos propres usages de l'IA, sur ce qu'ils vous rapportent réellement et sur votre visibilité dans les moteurs génératifs, échangeons une heure avec notre équipe.
Et vous, quelle annonce d'IA vous a fait lever un sourcil ces dernières semaines ? Dites-le nous en commentaire !Sources et références
- TechCrunch - Microsoft's Mustafa Suleyman says its AI outperforms doctors on hard cases, Rebecca Bellan (22 octobre 2026)
- Science - Étude sur le système MAI-DxO de Microsoft (octobre 2026)
- OpenAI - Using thousands of AI agents to uncover new leads in biological data (21 octobre 2026)
- bioRxiv - Préprint associé au travail OpenAI, PerturbAI et Scripps Research (15 octobre 2026)
- Google DeepMind - Accelerating the search for antimicrobial peptides with Google Antigravity, Pengfei Tian et al. (15 octobre 2026)
- Google DeepMind - Beyond tree cover: mapping the world's forest types, Maxim Neumann et Charlotte Stanton (22 octobre 2026)
- Scientific Data - Article de référence de la carte ForTy (2026)
- Anthropic - Engagement dans la Genesis Mission (8 octobre 2026)
- Anthropic - Open call for guest investigators in the life sciences (22 octobre 2026)
- TechCrunch - OpenAI acquires startup Orchestra Bio, Julie Bort (20 octobre 2026)
Questions fréquentes sur l'IA et la recherche scientifique
L'IA a-t-elle déjà découvert un médicament ?
Non, pas au sens d'un médicament commercialisé qui serait né d'une IA. Ce que l'IA produit aujourd'hui, ce sont des candidats, c'est-à-dire des molécules ou des séquences jugées prometteuses par le calcul. Le candidat antimicrobien présenté par Google DeepMind le 15 octobre 2026 est explicitement en attente de validation en laboratoire. Entre un candidat et un médicament autorisé, il reste les essais précliniques puis cliniques, qui se comptent en années.
Une IA peut-elle remplacer un médecin ?
L'étude publiée dans Science en octobre 2026 montre qu'un système multi-agents dépasse des médecins de premier recours sur des cas cliniques écrits et complexes. Il s'agit d'une simulation sur dossiers, pas d'une prise en charge de patients réels, et les spécialistes auxquels ces cas sont normalement confiés n'étaient pas dans la comparaison. Sur les situations d'urgence, le gain mesuré est faible ou nul. Aucune évaluation clinique sur patients n'a encore été publiée.
Comment savoir si une annonce d'IA est fiable ?
Posez trois questions. Le résultat a-t-il été publié dans une revue à comité de lecture, ou s'agit-il d'un préprint, voire d'un simple billet de blog d'entreprise ? Le chiffre vient-il d'un test réalisé par l'éditeur lui-même ou d'une évaluation indépendante ? Le résultat a-t-il été obtenu en conditions réelles ou en simulation ? En octobre 2026, deux annonces scientifiques majeures sur quatre passaient le premier filtre, aucune ne passait le troisième.
Qu'est-ce qu'un préprint, et pourquoi c'est important ?
Un préprint est un article scientifique déposé publiquement avant toute évaluation par des pairs, sur une plateforme comme bioRxiv ou arXiv. Il permet de diffuser vite, ce qui est précieux, mais aucun relecteur indépendant n'a encore contrôlé la méthode ni les résultats. Un préprint peut être excellent comme il peut être rétracté. La différence tient au statut, pas à la qualité apparente du document, et elle doit toujours être mentionnée quand on cite le travail.
Mon entreprise peut-elle utiliser ces avancées ?
Pas les résultats scientifiques eux-mêmes, mais la méthode, oui. L'enseignement transposable de ces travaux est que plusieurs agents d'IA coordonnés donnent de meilleurs résultats qu'un modèle unique, souvent pour un coût inférieur. Appliqué à une PME, cela concerne la veille concurrentielle, l'analyse de verbatims clients, l'audit de contenus ou le traitement de documents. L'autre enseignement est méthodologique : mesurer le gain réel avant de généraliser un outil à toute l'équipe.