Puces IA maison : que changent Maia, TPU et Trainium ?
En 2026, 27,8 % des serveurs IA livrés dans le monde ne tournent pas sur une puce achetée à Nvidia ou AMD, mais sur un accélérateur conçu par le fournisseur de cloud lui-même. C'est le chiffre de TrendForce, et c'est le plus haut niveau depuis 2023. Le 12 octobre 2026, Microsoft a ajouté une pièce au tableau avec Maia 300, sa troisième génération de puce d'inférence. Google en est à sa septième avec Ironwood, Amazon à sa troisième avec Trainium, Meta construit la sienne avec Broadcom. Ces puces IA maison ne sont pas un détail d'ingénieur : elles décident du prix que vous paierez demain pour un million de tokens, de la vitesse de réponse de votre assistant et de la liberté qu'il vous reste de changer de fournisseur.
-
- Dernière modification
20 octobre 2026 - 9 minutes de lecture
Puces IA maison : de quoi parle-t-on exactement ?
Une puce IA maison est un accélérateur conçu par l'entreprise qui va l'utiliser, et non acheté sur catalogue à un fabricant comme Nvidia ou AMD. Dans le jargon du secteur, on parle d'ASIC (« application-specific integrated circuit », circuit intégré dédié à une application) par opposition au GPU, une puce généraliste capable de tout faire, du jeu vidéo à la recherche scientifique.
La différence tient en une phrase : un GPU est un couteau suisse, un ASIC est un tournevis fabriqué pour une seule vis. Quand cette vis représente des milliards de requêtes par jour, le tournevis gagne.
Quatre géants exploitent aujourd'hui leur propre silicium à grande échelle, et chacun avec une logique différente :
- Google, le pionnier : sept générations de TPU (« tensor processing unit ») depuis 2015, dont Ironwood, aussi appelée TPU7x, désormais vendue sur Google Cloud.
- Amazon, le discret : Inferentia puis Trainium, dont la troisième génération est passée en disponibilité générale le 2 décembre 2025.
- Microsoft, le retardataire pressé : Maia 300, annoncée le 12 octobre 2026, destinée à faire tourner Copilot, GitHub, Teams et Microsoft Foundry.
- Meta, l'autarcique : MTIA, développée avec Broadcom, utilisée uniquement en interne et jamais revendue sous forme de cloud.
Horizon GEO • La newsletter
L’IA expliquée simplement, chaque semaine
Nos décryptages IA les plus clairs, l’actu des modèles et des cas concrets pour votre entreprise, directement dans votre boîte mail.
1 e-mail par semaine • Désinscription en 1 clic
Pourquoi les géants du cloud conçoivent leurs propres puces
Trois raisons expliquent ce mouvement, et aucune n'est idéologique. La première est financière : TrendForce estime que les neuf plus gros fournisseurs de cloud dépenseront plus de 886,7 milliards de dollars en investissements en 2026, soit environ 791 milliards d'euros au taux de référence de la Banque centrale européenne du 15 octobre 2026 (1 euro pour 1,1208 dollar). Quand une ligne budgétaire atteint ce niveau, concevoir sa propre puce coûte moins cher que d'acheter celle des autres.
La deuxième raison est technique et beaucoup moins connue : l'inférence, c'est-à-dire la phase où le modèle répond à votre question, est limitée par la mémoire, pas par la puissance de calcul. Chaque token généré oblige la puce à relire l'intégralité de l'état du modèle. Résultat : la bande passante mémoire compte davantage que les téraflops, et c'est précisément là que les concepteurs d'ASIC poussent leurs curseurs.
La troisième raison est électrique. Un rack Maia 300 consomme 167 kilowatts, et Microsoft a renoncé en octobre 2026 à son data center de Loughton au Royaume-Uni faute de raccordement électrique suffisant avant le milieu des années 2030. La performance par mégawatt devient donc l'unité de compte, un sujet que nous avons détaillé dans notre article sur la consommation énergétique de l'IA.
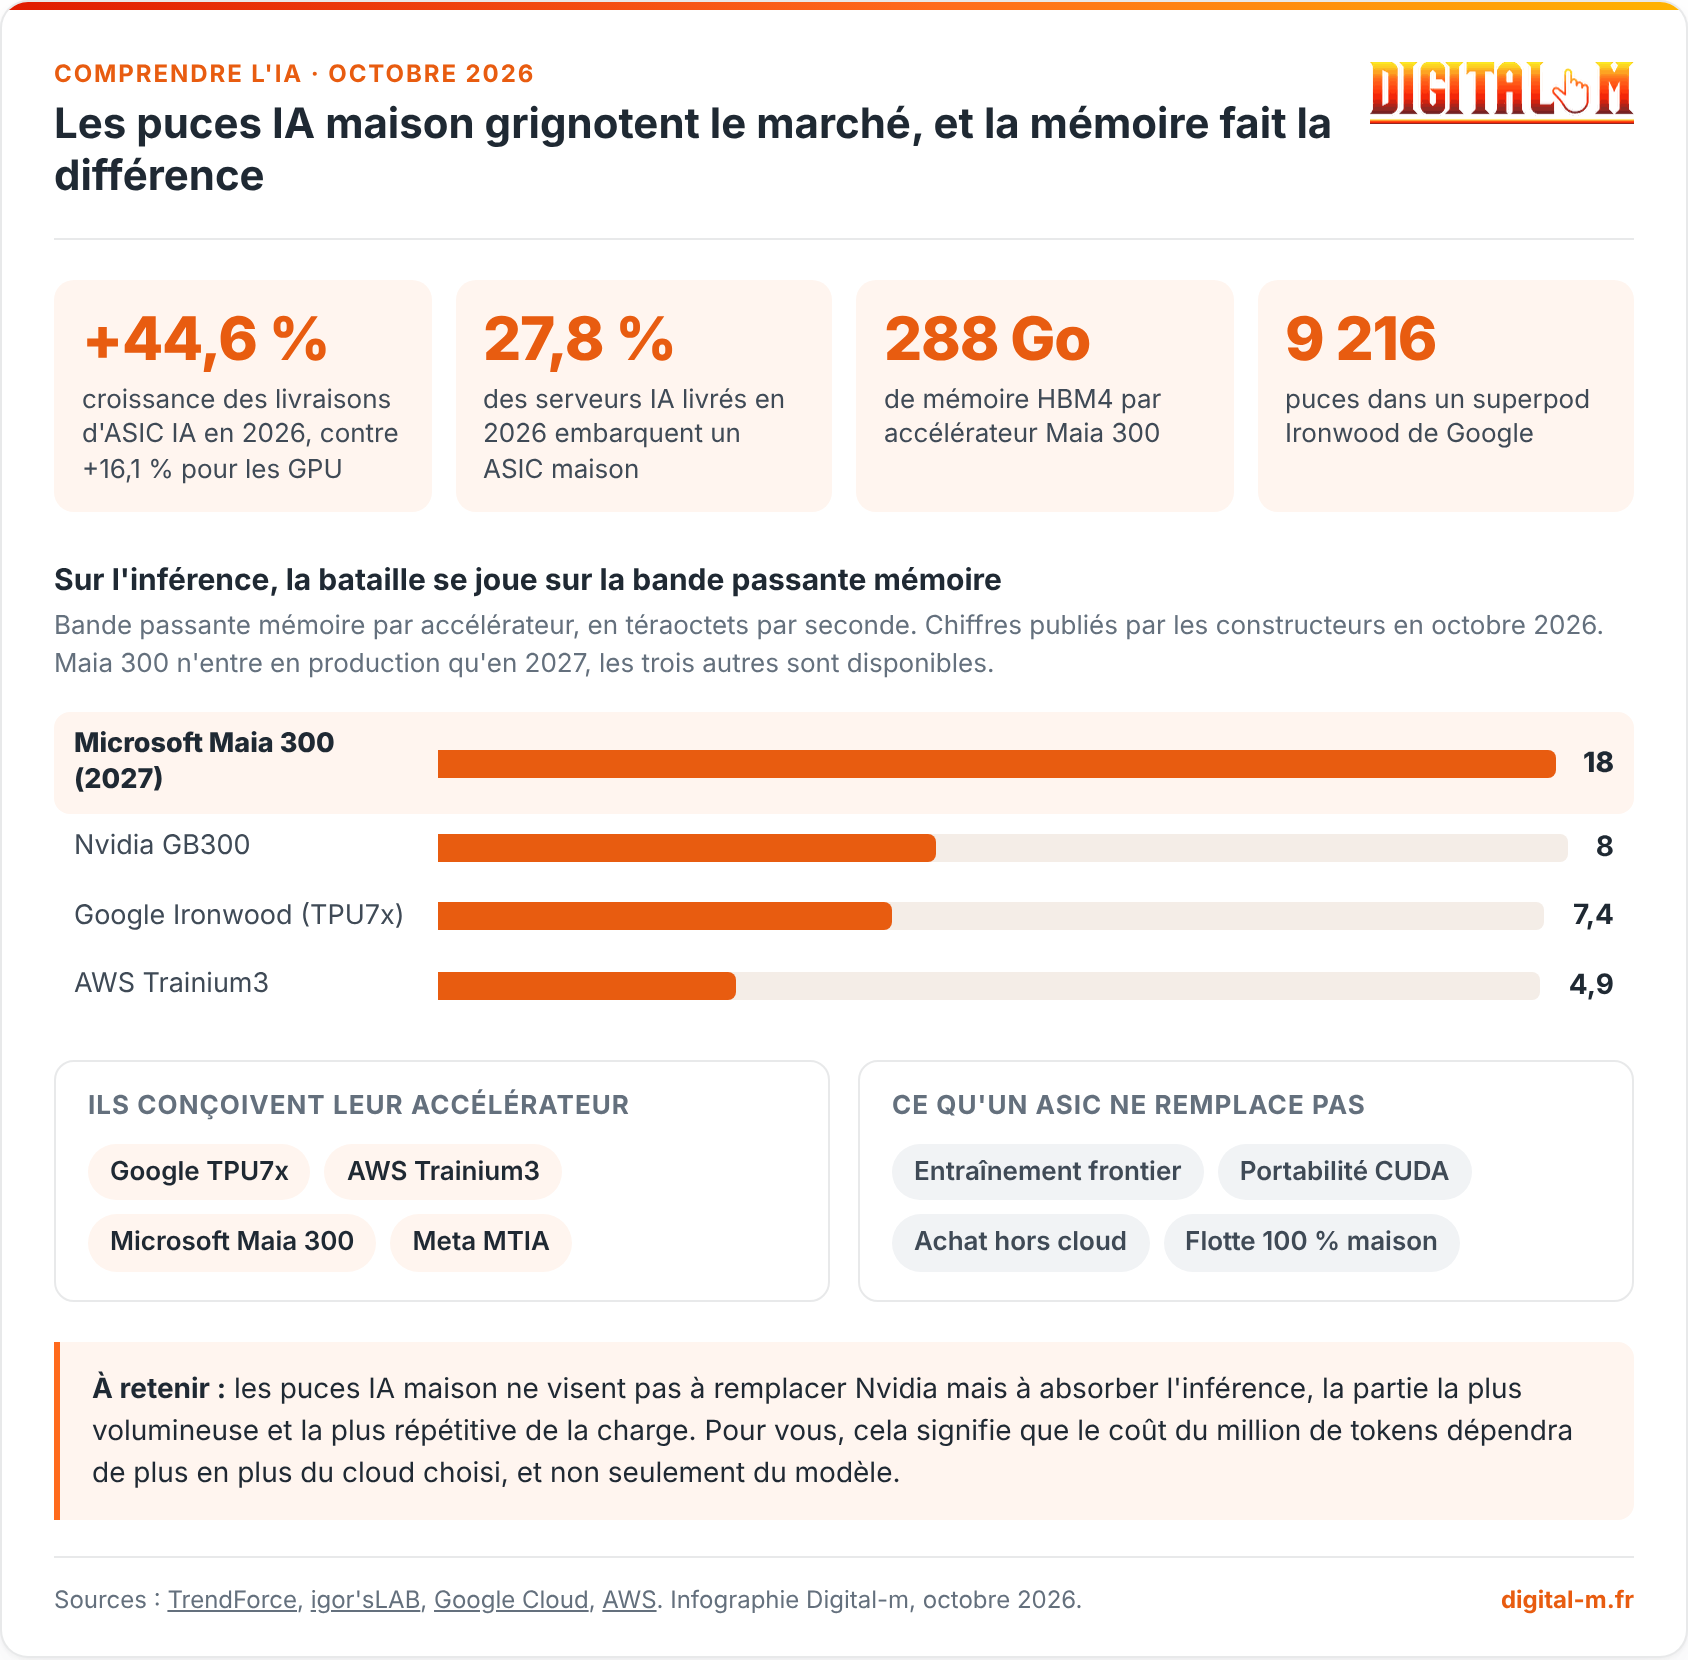
Les puces IA maison grignotent le marché, et la mémoire fait la différence

- +44,6 % croissance des livraisons d'ASIC IA en 2026, contre +16,1 % pour les GPU
- 27,8 % des serveurs IA livrés en 2026 embarquent un ASIC maison
- 288 Go de mémoire HBM4 par accélérateur Maia 300
- 9 216 puces dans un superpod Ironwood de Google
Sur l'inférence, la bataille se joue sur la bande passante mémoire
Bande passante mémoire par accélérateur, en téraoctets par seconde. Chiffres publiés par les constructeurs en octobre 2026. Maia 300 n'entre en production qu'en 2027, les trois autres sont disponibles.
Ils conçoivent leur accélérateur
Ce qu'un ASIC ne remplace pas
À retenir : les puces IA maison ne visent pas à remplacer Nvidia mais à absorber l'inférence, la partie la plus volumineuse et la plus répétitive de la charge. Pour vous, cela signifie que le coût du million de tokens dépendra de plus en plus du cloud choisi, et non seulement du modèle.
Télécharger l'infographie (PNG)
Qui fabrique quoi en 2026 : le panorama chiffré
Quatre programmes de puces IA maison dominent le marché en octobre 2026, et leurs caractéristiques publiées permettent une comparaison directe. Le tableau ci-dessous reprend uniquement les chiffres officiels des constructeurs.
| Puce | Concepteur | Mémoire par puce | Bande passante | Échelle maximale | Statut |
|---|---|---|---|---|---|
| Maia 300 | Microsoft | 288 Go HBM4 | 18 To/s | 12 288 puces par superpod | Production 2027 |
| Ironwood (TPU7x) | 192 Gio HBM | 7,38 To/s | 9 216 puces par superpod | Disponible | |
| Trainium3 | Amazon | 144 Go HBM3e | 4,9 To/s | 144 puces par UltraServer | Disponible |
| MTIA | Meta et Broadcom | Non publié | Non publié | 1 GW de capacité engagée | Déploiement interne |
Deux détails méritent votre attention. Premier point : Google vend désormais ses TPU, et Anthropic s'est engagé sur jusqu'à un million de TPU et plus d'un gigawatt de capacité en 2026. Les puces IA maison sortent donc du périmètre strictement interne pour devenir une offre commerciale.
Second point : un superpod Ironwood agrège 1,77 pétaoctet de mémoire HBM partagée, reliée par une interconnexion à 9,6 térabits par seconde. Cette capacité à faire travailler des milliers de puces comme une seule explique pourquoi les gros modèles à prix d'appel existent encore.
Maia 300 : ce que Microsoft a annoncé le 12 octobre 2026
Microsoft a présenté Maia 300 le 12 octobre 2026 comme le futur système d'inférence principal de Copilot, GitHub, Teams et Microsoft Foundry. La puce est gravée en 2 nanomètres chez TSMC (procédé N2P), découpée en plusieurs « chiplets » (des blocs de silicium séparés assemblés dans un même boîtier) qui dissocient le calcul de la mémoire et des entrées-sorties.
Les chiffres matériels publiés
Chaque accélérateur embarque 8 piles de HBM4 pour 288 Go et jusqu'à 18 To/s de bande passante, dans une enveloppe de 950 watts. Un rack en aligne 96, pour 167 kilowatts, 27,6 téraoctets de mémoire et environ 1,7 pétaoctet par seconde de bande passante agrégée. Le refroidissement liquide absorbe plus de 80 % de la charge thermique, et un superpod monte à 128 racks, soit 12 288 accélérateurs.
Les promesses de performance, à manier avec prudence
Microsoft annonce jusqu'à 7 fois le débit de tokens d'un rack Maia 200, plus de 2,5 fois la performance par watt au niveau rack, et environ 40 % de tokens supplémentaires par mégawatt face aux « meilleurs systèmes à base de GPU ». Ces chiffres sont des mesures maison, publiées par Microsoft sans protocole détaillé ni vérification par un tiers indépendant. Le site igor'sLAB souligne qu'ils ne sont pas comparables sans conditions de test identiques, le débit dépendant du modèle, de la longueur des entrées et de la cible de latence retenue.
Chez Digital-m, nous auditons régulièrement des infrastructures de PME qui ont basculé un chatbot d'un fournisseur à l'autre sur la foi d'un communiqué : dans la moitié des cas, le gain annoncé fond une fois la charge réelle appliquée. Un comparatif sérieux se fait sur vos propres requêtes, pas sur une diapositive.
ASIC ou GPU : ce que chacun sait faire, et ne sait pas faire
Un ASIC gagne sur l'inférence répétitive et perd sur la flexibilité. Les architectures des puces IA maison privilégient la mémoire plutôt que le calcul brut, ce qui les rend excellentes pour générer des tokens mais inadaptées à l'essentiel de l'entraînement des modèles les plus récents.
Conséquence directe : aucun des quatre géants ne quitte Nvidia. Microsoft décrit Maia comme un ajout dans une flotte mixte qui tourne aussi sur du matériel Nvidia et AMD. Meta, malgré son gigawatt de MTIA engagé auprès de Broadcom jusqu'en 2029, conserve des accords pluri-gigawatts avec Nvidia et AMD, et prévoit de mélanger GPU et accélérateurs maison dans 31 data centers, dont 27 aux États-Unis.
L'autre limite est logicielle. Un modèle optimisé pour CUDA, l'environnement de développement propriétaire de Nvidia, ne se transpose pas gratuitement sur un TPU ou un Trainium. Ce travail d'adaptation, invisible dans les communiqués, explique pourquoi beaucoup d'éditeurs restent sur GPU malgré un prix au token plus élevé.
Ce que les puces IA maison changent pour votre entreprise
Vous n'achèterez jamais de Maia 300 ni de TPU7x, mais vous en subirez les effets sur quatre points très concrets.
- Le prix au million de tokens : l'inférence sur silicium maison coûte moins cher au fournisseur. Rien ne garantit que l'économie vous soit reversée, et l'analyse d'HyperFRAME Research note qu'il est encore impossible de dire si les gains d'efficacité de Maia atteindront les tarifs Azure.
- La latence perçue : plus de bande passante mémoire signifie des réponses plus rapides sur les longs contextes. C'est le facteur dominant de la latence des LLM, bien avant la puissance de calcul.
- La dépendance au cloud : un modèle optimisé pour Trainium tourne bien chez AWS et moins bien ailleurs. Les puces IA maison renforcent l'enfermement propriétaire, exactement là où vous espériez de la concurrence.
- La disponibilité : plus de silicium dédié à l'inférence libère des GPU pour l'entraînement, ce qui réduit mécaniquement la tension décrite dans notre analyse de la pénurie de puces IA.
Le réflexe utile est simple : avant de signer un engagement annuel, demandez à votre prestataire sur quel matériel tourne le modèle que vous consommez, et ce qui se passe si vous voulez partir. Nos équipes posent systématiquement cette question lors d'un audit technique, et la réponse est rarement écrite dans le contrat.
Les chiffres à prendre avec des pincettes
Trois réserves méritent d'être posées noir sur blanc, parce que la communication des constructeurs est généreuse.
Première réserve : tous les gains de performance cités dans cet article sont des tests maison. Microsoft, Google et AWS publient leurs propres mesures, sans vérification indépendante. Les 4,4 fois de Trainium3 face à Trainium2 et les 7 fois de Maia 300 face à Maia 200 relèvent de la même catégorie que les benchmarks de modèles que nous avions passés au crible.
Deuxième réserve : Maia 300 n'existe pas encore commercialement. La production est annoncée pour 2027, et deux facteurs peuvent la retarder, l'allocation des plaques en 2 nanomètres chez TSMC et l'approvisionnement en HBM4. Les détails de déploiement sont attendus à la conférence Microsoft Ignite, du 17 au 20 novembre 2026.
Troisième réserve : les 27,8 % de serveurs IA équipés d'ASIC comptent des livraisons d'unités, pas du chiffre d'affaires. En valeur, Nvidia reste très largement dominant. Confondre les deux mesures conduit à surestimer le basculement en cours.
Ce qu'il faut retenir
Les puces IA maison sont devenues une infrastructure de masse, pas une curiosité : 27,8 % des serveurs IA livrés en 2026 en embarquent une, et leurs livraisons progressent de 44,6 % contre 16,1 % pour les GPU du marché. Google en est à sa septième génération avec Ironwood, Amazon à sa troisième avec Trainium3, Microsoft lance Maia 300 pour une production en 2027, Meta construit MTIA avec Broadcom jusqu'en 2029.
Ce mouvement ne tue pas Nvidia, il redistribue les rôles : l'ASIC prend l'inférence, le GPU garde l'entraînement et la portabilité. Pour une PME, la conséquence tient en une question : votre fournisseur d'IA vous répercutera-t-il ces économies, et à quel prix en termes de liberté de partir ?
C'est exactement le genre d'arbitrage que nous instruisons avec nos clients. Si vous consommez de l'IA au quotidien sans savoir ce que vous payez vraiment, demandez un audit de votre dispositif IA et GEO, ou formez vos équipes avec notre formation GEO certifiée Qualiopi. Un échange de trente minutes suffit souvent à chiffrer l'enjeu.
Et vous, savez-vous sur quel matériel tourne l'IA que votre entreprise utilise tous les jours ? Dites-le nous en commentaire !Sources et références
- igor'sLAB - Microsoft Maia 300 : 288 Go HBM4, 18 To/s et 96 accélérateurs par rack (octobre 2026)
- HyperFRAME Research - Is Maia 300 Really a Chip Announcement, or a Data Center One? (13 octobre 2026)
- Google Cloud - Documentation TPU7x (Ironwood) : spécifications officielles
- Google - 3 things to know about Ironwood, Google's latest TPU
- AWS - Announcing Amazon EC2 Trn3 UltraServers (2 décembre 2025)
- Tech Times - Custom AI Chips Outpace Nvidia GPU Growth in 2026, données TrendForce (26 mai 2026)
- TrendForce via TechJack - Prévision de croissance des serveurs IA et capex des fournisseurs cloud (3 août 2026)
- TechSpot - Meta doubles down on custom AI chips with Broadcom deal through 2029
- SemiAnalysis InferenceX - Fiche technique Nvidia GB300 NVL72
- Banque centrale européenne - Taux de change de référence euro / dollar (15 octobre 2026)
- ActuIA - Veille IA du 19 octobre 2026
Questions fréquentes sur les puces IA maison
Quelle est la différence entre un ASIC et un GPU pour l'IA ?
Un GPU est une puce généraliste, programmable pour de nombreux usages, de l'entraînement de modèles au rendu graphique. Un ASIC est câblé pour une tâche précise, ici faire tourner un modèle de langage déjà entraîné. L'ASIC consomme moins par token généré, mais il perd en flexibilité et ne couvre pas la plupart des travaux d'entraînement.
Les puces IA maison vont-elles faire baisser le prix de ChatGPT ou de Gemini ?
Elles réduisent le coût de production de chaque réponse, mais rien n'oblige le fournisseur à répercuter l'économie. En 2026, l'indice de prix des grands modèles a d'ailleurs cessé de baisser. Les gains d'efficacité servent pour l'instant surtout à absorber la demande, pas à faire baisser les tarifs affichés.
Mistral, OpenAI ou Anthropic ont-ils leurs propres puces ?
Non, ces éditeurs de modèles louent la capacité des fournisseurs de cloud. Anthropic s'est engagé sur jusqu'à un million de TPU Google et plus d'un gigawatt de capacité en 2026, tout en utilisant aussi Trainium chez AWS. Mistral AI s'appuie sur des GPU Nvidia et sur des partenariats d'infrastructure en Europe.
Peut-on acheter un TPU ou un Trainium pour son entreprise ?
Pas sous la forme d'une carte à installer dans un serveur. Ces puces se consomment en location, via Google Cloud pour les TPU et via les instances Trn3 pour Trainium. Google a toutefois commencé à vendre des TPU à des partenaires hébergeant leurs propres data centers, ce qui reste réservé à des volumes très importants.
Faut-il changer de fournisseur d'IA à cause de ces annonces ?
Pas sur la base d'un communiqué. Maia 300 n'entre en production qu'en 2027 et les chiffres publiés sont des tests internes. La bonne démarche consiste à mesurer la latence et le coût réel sur vos propres requêtes, puis à vérifier la clause de réversibilité de votre contrat avant tout engagement pluriannuel.