Biais de position des LLM : pourquoi l'IA oublie le milieu
Collez un rapport de 80 pages dans ChatGPT, posez une question sur un paragraphe situé au milieu : la réponse peut être moins bonne que si vous n'aviez rien collé du tout. Ce n'est pas une anecdote, c'est un résultat mesuré par Nelson Liu et ses coauteurs de Stanford, publié dans la revue TACL en 2024. Les modèles de langage ne lisent pas leur contexte de façon uniforme : ils exploitent beaucoup mieux le début et la fin que le centre. Ce phénomène porte un nom, le biais de position des LLM, et il a une cause technique identifiée dans l'architecture même des transformeurs. Quatre études chiffrées, de 2023 à 2026, en dessinent aujourd'hui les contours précis. Voici ce qu'elles disent, et ce que cela change pour vos prompts comme pour vos contenus.
-
- Dernière modification
18 novembre 2026 - 9 minutes de lecture
Le biais de position des LLM, c'est quoi exactement ?
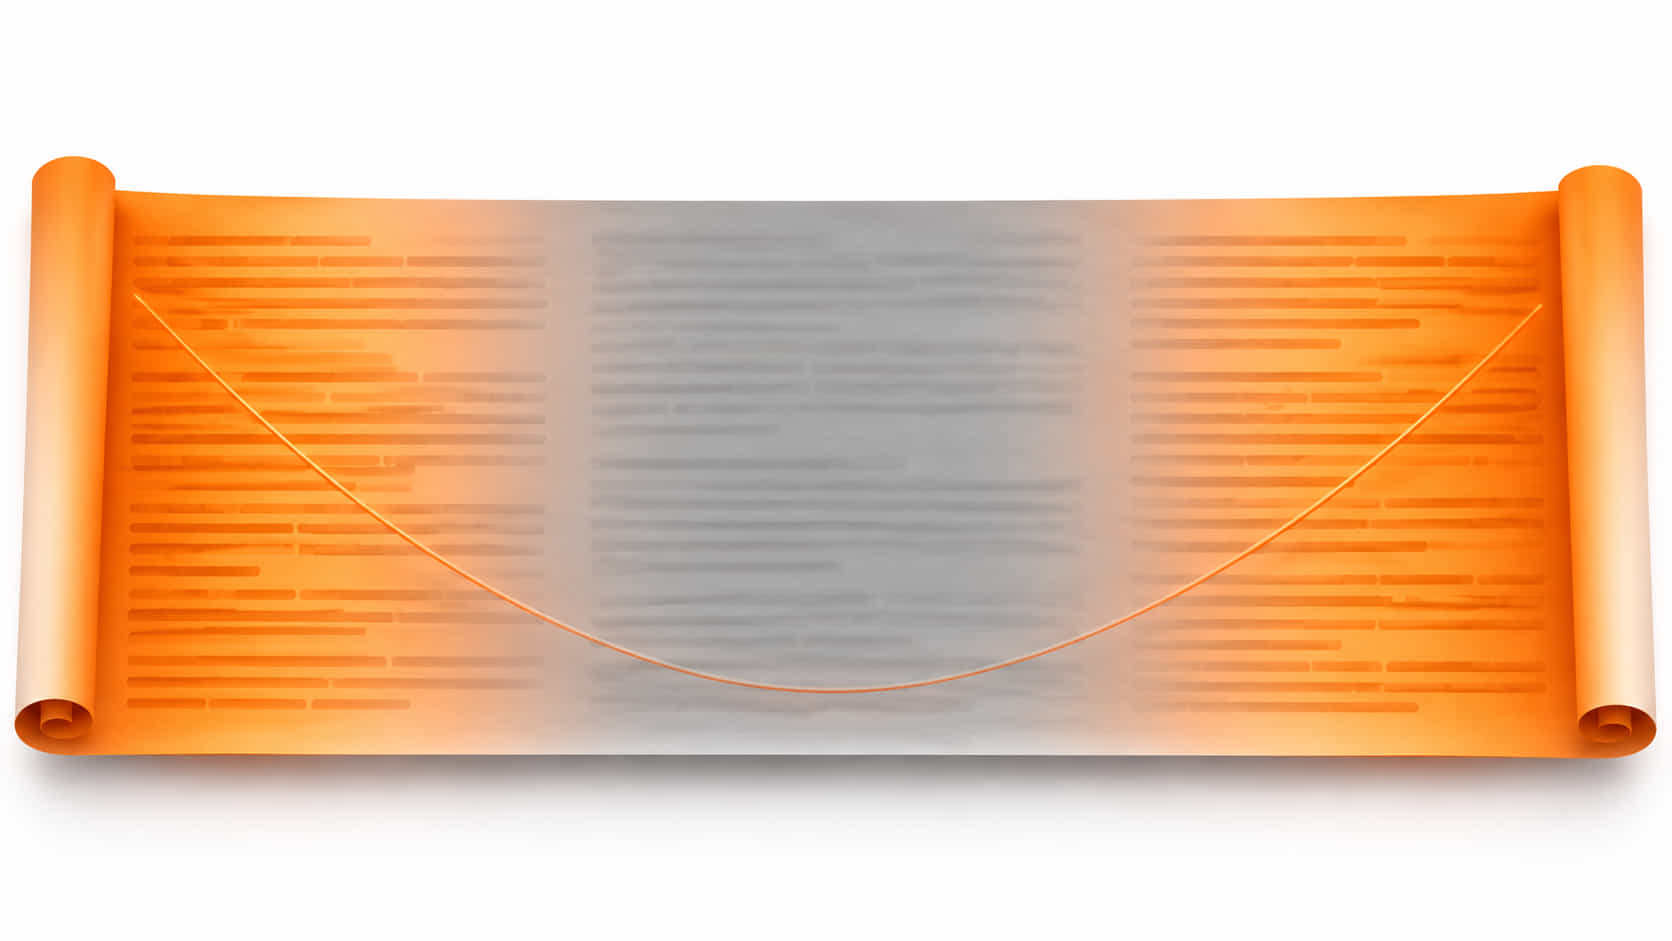
Le biais de position des LLM désigne la tendance d'un modèle de langage à mieux exploiter l'information placée au début et à la fin de son contexte qu'au milieu. La courbe de performance en fonction de la position prend une forme de U : haute aux deux extrémités, creusée au centre.
Le chiffre de référence vient de l'étude « Lost in the Middle » de Nelson F. Liu, Kevin Lin, John Hewitt et Percy Liang (Stanford, UC Berkeley et Samaya AI). Avec 30 documents dans son contexte, GPT-3.5-Turbo répond juste dans 73,4 % des cas quand le document utile est en première position, et seulement 50,5 % quand il est au dixième rang. Soit 22,9 points d'écart, pour une information strictement identique.
Le résultat le plus dérangeant de cette étude tient en une comparaison. Interrogé sans aucun document, uniquement sur ses connaissances internes, GPT-3.5-Turbo atteignait 56,1 %. Avec 20 documents dont le bon placé au milieu, il tombait à 53,8 %. Lui fournir la réponse, mal placée, le rendait donc moins performant que ne rien lui fournir.
- Biais de primauté : le modèle sur-exploite les premiers tokens de son contexte, ceux qu'il a « lus » en premier.
- Biais de récence : il sur-exploite aussi la toute fin, c'est-à-dire ce qui précède immédiatement sa réponse.
- Creux central : entre les deux, la précision chute, parfois sous le niveau d'un modèle privé de toute source.
Ce n'est pas un bug corrigeable par une mise à jour. C'est une conséquence du fonctionnement de l'attention, le mécanisme central des transformeurs qui équipent GPT, Gemini, Claude, Mistral ou Qwen. Chez Digital-m, nous retrouvons ce réflexe dans presque tous les audits de prompts que nous menons pour des PME : les équipes empilent les pièces jointes dans une seule conversation et s'étonnent que la qualité baisse.
Horizon GEO • La newsletter
Comprendre les LLM, sans jargon
Chaque semaine, un mécanisme des IA expliqué simplement (contexte, embeddings, raisonnement…) et l’actu des modèles qui compte.
1 e-mail par semaine • Désinscription en 1 clic
Pourquoi le premier token capte jusqu'à 80 % de l'attention
La cause mécanique du biais de position porte un nom : le puits d'attention (« attention sink », littéralement l'évier où s'écoule l'attention). Dans un transformeur, chaque tête d'attention distribue un budget d'attention entre tous les tokens, ces fragments de mots que le modèle manipule. Or une grande partie de ce budget part sur le premier token de la séquence, qui ne porte presque aucun sens.
L'étude « Why do LLMs attend to the first token? », signée par Federico Barbero, Álvaro Arroyo et leurs coauteurs de l'université d'Oxford, de la National University of Singapore et de Google DeepMind (version d'août 2025), chiffre le phénomène. Sur un prompt typique de Llama 3.1 405B, près de 80 % de la masse d'attention se concentre sur le token de début de séquence, et environ 80 % des têtes d'attention de ce modèle forment un puits marqué.
Pourquoi un tel gaspillage ? Parce que ce n'en est pas un. Les auteurs montrent qu'une tête qui n'a rien à faire envoie son attention vers ce premier token, dont la valeur a une norme très faible : l'opération devient une quasi-non-opération, et la représentation du texte reste intacte. Sans ce mécanisme, l'attention mélangerait indéfiniment les tokens entre eux jusqu'à les rendre indiscernables, un effondrement que les auteurs appellent le « over-mixing ».
Détail décisif pour notre sujet : les puits d'attention sont « nettement plus répandus » dans les modèles entraînés sur de longs contextes, et « quasi inexistants » dans ceux entraînés sur des contextes courts. Autrement dit, plus les fenêtres de contexte s'allongent, plus ce garde-fou se renforce. Le biais de position n'est pas un défaut de jeunesse des LLM, il grandit avec eux.
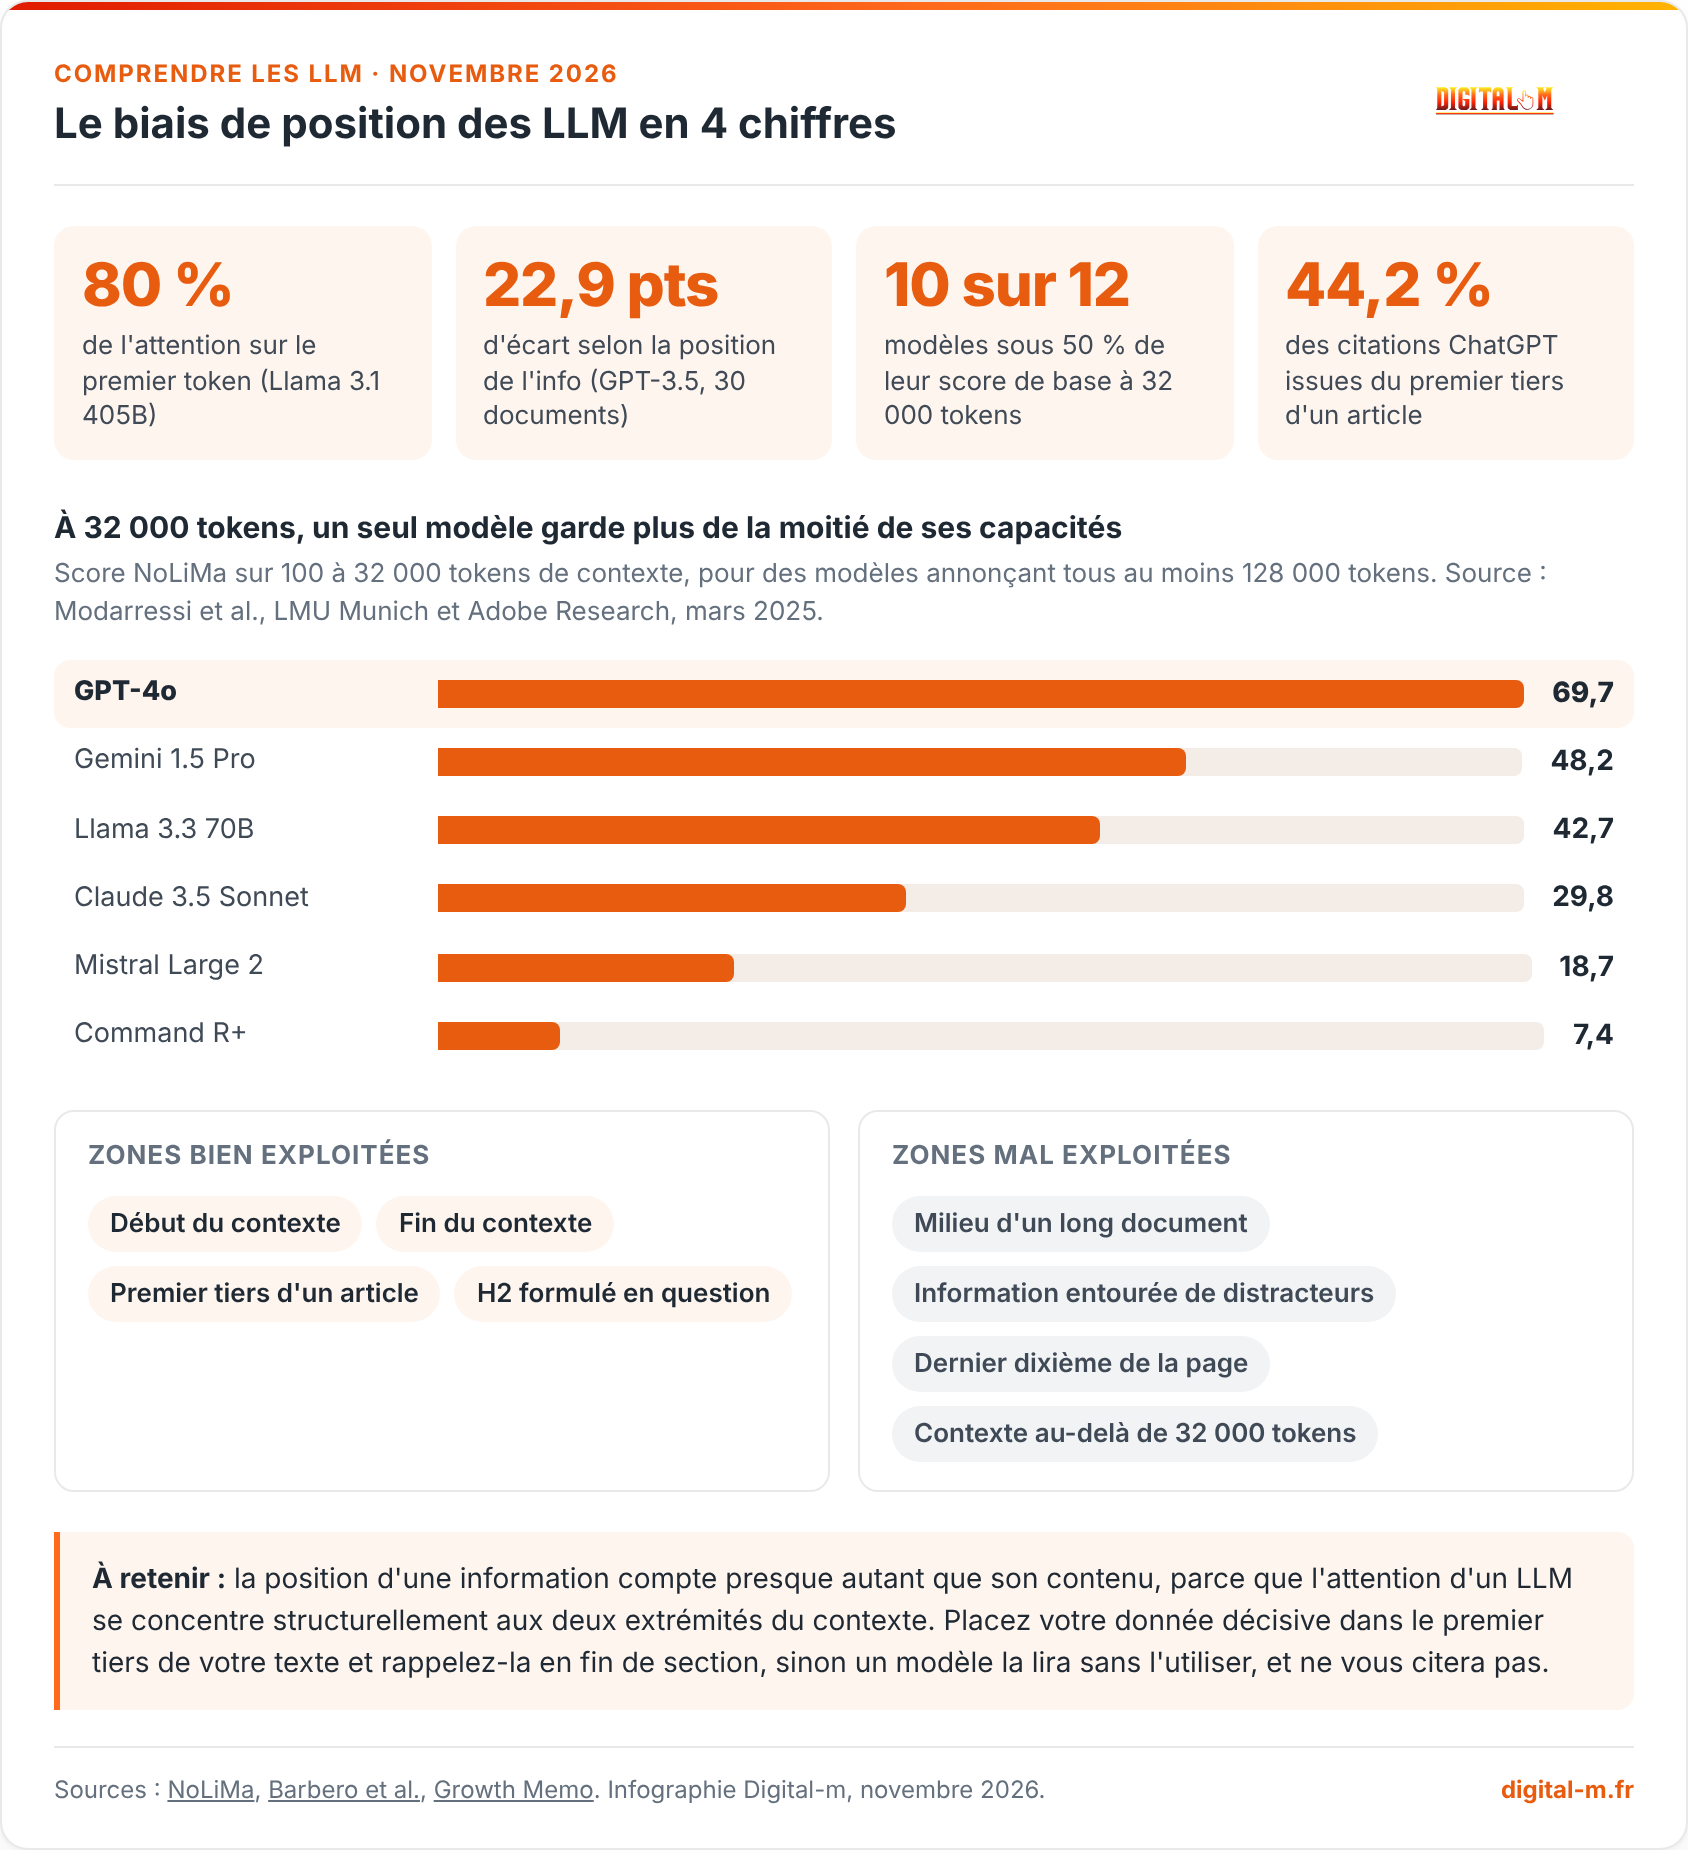
Le biais de position des LLM en 4 chiffres

- 80 % de l'attention sur le premier token (Llama 3.1 405B)
- 22,9 pts d'écart selon la position de l'info (GPT-3.5, 30 documents)
- 10 sur 12 modèles sous 50 % de leur score de base à 32 000 tokens
- 44,2 % des citations ChatGPT issues du premier tiers d'un article
À 32 000 tokens, un seul modèle garde plus de la moitié de ses capacités
Score NoLiMa sur 100 à 32 000 tokens de contexte, pour des modèles annonçant tous au moins 128 000 tokens. Source : Modarressi et al., LMU Munich et Adobe Research, mars 2025.
Zones bien exploitées
Zones mal exploitées
À retenir : la position d'une information compte presque autant que son contenu, parce que l'attention d'un LLM se concentre structurellement aux deux extrémités du contexte. Placez votre donnée décisive dans le premier tiers de votre texte et rappelez-la en fin de section, sinon un modèle la lira sans l'utiliser, et ne vous citera pas.
Télécharger l'infographie (PNG)
« Lost in the middle » : la courbe en U découverte en 2023
L'étude fondatrice sur le biais de position s'appelle « Lost in the Middle: How Language Models Use Long Contexts ». Déposée sur arXiv en juillet 2023, elle a été publiée dans Transactions of the Association for Computational Linguistics en 2024. Son protocole est simple et reproductible.
Les chercheurs partent de 2 655 questions du jeu NaturalQuestions-Open. Pour chacune, ils placent dans le contexte du modèle 10, 20 ou 30 extraits de Wikipédia de 100 tokens maximum. Un seul contient la réponse, les autres sont des distracteurs plausibles. Puis ils déplacent le bon extrait de la première à la dernière position et mesurent la précision.
Voici les résultats avec 30 documents, en pourcentage de réponses exactes selon la position du document utile.
| Modèle | Document en 1re position | Document au milieu | Document en dernière position |
|---|---|---|---|
| GPT-3.5-Turbo (16K) | 73,4 % | 50,5 % | 63,7 % |
| Claude-1.3 | 59,1 % | 54,8 % | 59,9 % |
| LongChat-13B (16K) | 66,9 % | 52,5 % | 55,1 % |
| MPT-30B-Instruct | 51,6 % | 51,2 % | 54,1 % |
Agrandir la fenêtre de contexte ne règle rien
Le constat le plus utile de cette étude est négatif. Les auteurs ont comparé GPT-3.5-Turbo en version 4 000 tokens et en version 16 000 tokens : les deux courbes se superposent presque. Donner plus de place à un modèle ne lui apprend pas à mieux s'en servir. Un rappel utile à l'heure où les éditeurs annoncent des fenêtres de 1 million de tokens, sujet que nous détaillons dans notre article sur le contexte dans les LLM.
Un biais hérité de nos propres textes
L'explication la plus probable est culturelle autant que technique. Les corpus d'entraînement regorgent de textes où l'essentiel figure en tête : dépêches de presse, résumés scientifiques, notes de synthèse. Le modèle a donc appris que le début d'un document concentre l'information utile, et il applique cette heuristique à tout ce qu'on lui soumet.
Fenêtre annoncée contre contexte réellement utilisable
Une fenêtre de 128 000 tokens ne signifie pas qu'un modèle raisonne correctement sur 128 000 tokens. L'étude NoLiMa, menée par Ali Modarressi (LMU Munich) avec Adobe Research et publiée sur arXiv le 26 mars 2025, le démontre sur 12 modèles annonçant tous au moins 128 000 tokens de contexte.
Le verdict est net : à 32 000 tokens, 10 des 12 modèles testés tombent sous 50 % de leur score de référence, mesuré sur des contextes de 250 à 1 000 tokens. GPT-4o, qui obtient 99,3 sur 100 en contexte court, descend à 69,7. Claude 3.5 Sonnet passe de 87,6 à 29,8. Command R+ s'effondre de 90,9 à 7,4.
Pourquoi le test de « l'aiguille dans la botte de foin » ne suffit pas
Les scores rassurants publiés jusque-là venaient d'un test appelé needle in a haystack : on cache une phrase dans un très long texte et on demande au modèle de la retrouver. Le problème, c'est que la question partage presque toujours des mots avec la phrase cachée. Le modèle n'a donc qu'à repérer une correspondance littérale.
NoLiMa chiffre ce biais méthodologique. Le recouvrement lexical entre la question et le passage pertinent, mesuré en ROUGE-1, atteint 0,905 dans le test classique, contre 0,069 dans NoLiMa. Les auteurs forcent le modèle à faire un lien associatif, par exemple relier une ville à un monument puis à une région, sans mot commun. Les scores s'écroulent aussitôt.
- Ce que mesure NoLiMa : la capacité à raisonner sur un long contexte, pas à y faire une recherche par mots-clés.
- Ce que l'étude observe : la performance dépend davantage de la longueur du contexte que de la position exacte de l'information.
- Ce que cela implique : raccourcir un prompt est souvent plus efficace que bien placer l'information dedans.
Le « context rot » : quand ajouter du contexte dégrade la réponse
Le troisième jalon s'appelle « Context Rot », littéralement la pourriture du contexte. Ce rapport technique de Kelly Hong, Anton Troynikov et Jeff Huber, publié par Chroma le 14 juillet 2025, évalue 18 modèles des familles GPT-4.1, Claude 4, Gemini 2.5 et Qwen3. Sa conclusion : la performance se dégrade à mesure que le nombre de tokens d'entrée augmente, sur toutes les tâches testées.
L'expérience la plus parlante concerne les distracteurs, ces passages qui ressemblent à la bonne réponse sans en être une. Un seul distracteur suffit à faire baisser la performance par rapport à un contexte contenant uniquement l'information utile. Avec quatre distracteurs, la chute s'accentue. Et tous ne pèsent pas pareil : certains provoquent à eux seuls l'essentiel de la dégradation.
Le rapport observe aussi des comportements d'éditeur très différents face à l'incertitude. Les modèles Claude affichent les taux d'hallucination les plus faibles et préfèrent s'abstenir. Les modèles GPT produisent les taux les plus élevés, avec des réponses assurées mais fausses. Pour un usage professionnel, cette nuance compte autant que le score brut, comme nous l'expliquions à propos des hallucinations des LLM.
Une précaution d'usage, par honnêteté : Chroma édite une base de données vectorielle, c'est-à-dire précisément un outil qui sert à ne pas tout envoyer au modèle. L'étude n'est pas neutre, même si son protocole et ses données sont publics. Chez Digital-m, nous croisons systématiquement ce type de rapport d'éditeur avec des travaux académiques avant d'en tirer une recommandation client.
Comment écrire vos prompts pour contourner le biais de position
La parade est simple à énoncer : ne comptez jamais sur le milieu de votre contexte. Voici les six réflexes qui changent le plus la qualité des réponses, que vous utilisiez ChatGPT, Gemini, Claude, Mistral ou Perplexity.
- Documents en haut, question en bas : la documentation d'Anthropic recommande de placer les documents de 20 000 tokens et plus au-dessus de la question. Elle annonce jusqu'à 30 % de qualité de réponse en plus quand la question figure à la fin, un chiffre issu de ses propres tests et non vérifié par un tiers indépendant.
- Une question à la fois : cinq questions dans un même message obligent le modèle à répartir son attention. Posez-les l'une après l'autre.
- Découper plutôt qu'empiler : trois prompts de 10 000 tokens battent presque toujours un prompt de 30 000 tokens, puisque la dégradation suit la longueur totale.
- Demander les citations d'abord : faites extraire les passages pertinents avant de demander la synthèse. Anthropic recommande explicitement cette séquence pour les longs documents.
- Repartir d'une conversation neuve : une discussion de 40 échanges place vos consignes initiales au milieu du contexte, donc dans la zone la moins exploitée.
- Vérifier le centre : si la synthèse d'un long document compte, testez une question portant uniquement sur son milieu. C'est le contrôle qualité le plus rapide qui existe.
Ces réflexes valent aussi pour les coûts. Un prompt plus court est un prompt moins cher et plus rapide, deux effets que nous détaillons dans notre article sur la latence des LLM.
Ce que le biais de position change pour votre visibilité dans les IA
Si un LLM exploite mal le milieu de son contexte, il exploite aussi mal le milieu de vos pages. C'est exactement ce que montre l'analyse de 1,2 million de résultats de recherche publiée par le consultant Kevin Indig le 16 février 2026 dans sa newsletter Growth Memo, que nous avons décryptée dans notre étude sur les citations de ChatGPT.
La répartition des citations de ChatGPT selon leur position dans l'article est sans ambiguïté : 44,2 % proviennent du premier tiers, 31,1 % du milieu, 24,7 % du dernier tiers, avec une chute brutale dans les 10 derniers pour cent de la page. Un contenu placé dans le premier tiers a donc environ 2,5 fois plus de chances d'être cité que le reste.
Autre enseignement de cette analyse : 78,4 % des citations liées à une question viennent d'un titre H2 ou H3. Un intertitre formulé en question, suivi immédiatement de sa réponse, crée la continuité sémantique que les moteurs génératifs repèrent le mieux.
- Répondez dès la première phrase : sous chaque H2, donnez la réponse directe avant de développer. C'est la zone que le modèle lit le mieux.
- Placez vos chiffres en haut : définition, donnée clé et conclusion principale dans les deux ou trois premiers paragraphes, jamais réservés à la conclusion.
- Rendez chaque paragraphe autonome : un passage compréhensible hors contexte est un passage citable, parce que le modèle n'a pas besoin du reste pour le reprendre.
- Nommez les entités : marques, modèles, versions, dates et auteurs ancrent votre texte et facilitent sa reprise.
C'est le travail que nous menons au quotidien dans nos missions d'accompagnement GEO : réécrire le premier tiers des pages stratégiques, transformer les intertitres en questions et vérifier ensuite les citations réellement obtenues dans ChatGPT, Gemini et Perplexity.
Ce qu'il faut retenir
Le biais de position des LLM n'est ni une rumeur ni un défaut passager. Quatre travaux convergents le documentent : la courbe en U de Liu et ses coauteurs (TACL, 2024), le puits d'attention à 80 % de Barbero et ses coauteurs (Oxford, NUS, Google DeepMind, 2025), l'effondrement à 32 000 tokens mesuré par NoLiMa (mars 2025) et la dégradation progressive décrite par Chroma (juillet 2025). Tous disent la même chose : un modèle ne lit pas son contexte de façon uniforme, et le milieu paie l'addition.
Pour vos prompts, la règle tient en une phrase : raccourcissez, découpez, et placez l'essentiel aux extrémités. Pour vos contenus, la logique est identique, avec un chiffre à garder en tête, les 44,2 % de citations issues du premier tiers. Vous voulez savoir où se situent aujourd'hui vos informations clés dans vos pages, et ce que les moteurs génératifs en retiennent vraiment ? Demandez un audit GEO, ou formez votre équipe avec notre formation GEO certifiée Qualiopi.
Et vous, avez-vous déjà constaté qu'une IA ignorait une information pourtant présente dans votre document ? Dites-le nous en commentaire !Sources et références
- ACL Anthology - Nelson F. Liu et al., Lost in the Middle: How Language Models Use Long Contexts, TACL (2024)
- arXiv - Lost in the Middle, version préprint et annexes chiffrées (juillet 2023)
- arXiv - Federico Barbero et al., Why do LLMs attend to the first token?, Oxford, NUS et Google DeepMind (août 2025)
- arXiv - Ali Modarressi et al., NoLiMa: Long-Context Evaluation Beyond Literal Matching, LMU Munich et Adobe Research (mars 2025)
- Chroma Research - Kelly Hong, Anton Troynikov, Jeff Huber, Context Rot: How Increasing Input Tokens Impacts LLM Performance (14 juillet 2025)
- Growth Memo - Kevin Indig, The Science of How AI Pays Attention (16 février 2026)
- Anthropic - Claude prompting best practices, section Long context prompting
- Digital-m - 44 % des citations de ChatGPT viennent du premier tiers de vos articles
Questions fréquentes sur le biais de position des LLM
Qu'est-ce que le biais de position d'un LLM ?
C'est la tendance d'un modèle de langage à mieux exploiter l'information située au début et à la fin de son contexte qu'au milieu. La courbe de précision selon la position prend une forme de U. Avec 30 documents, GPT-3.5-Turbo passe de 73,4 % de bonnes réponses quand l'information utile est en tête à 50,5 % quand elle est au centre, selon l'étude Lost in the Middle publiée dans TACL en 2024.
Une grande fenêtre de contexte corrige-t-elle ce biais ?
Non. L'étude NoLiMa de mars 2025 a testé 12 modèles annonçant au moins 128 000 tokens : à 32 000 tokens, 10 d'entre eux tombent sous 50 % de leur score obtenu en contexte court. Les auteurs de Lost in the Middle ont par ailleurs comparé GPT-3.5-Turbo en 4 000 et 16 000 tokens, avec des courbes presque identiques. Une fenêtre annoncée n'est pas une fenêtre réellement exploitable.
Pourquoi le premier token reçoit-il autant d'attention ?
Parce qu'il sert de puits d'attention. Une tête d'attention qui n'a rien d'utile à faire y déverse son budget, ce qui revient à ne rien faire et protège la représentation du texte contre un mélange excessif. Sur un prompt typique de Llama 3.1 405B, près de 80 % de la masse d'attention s'y concentre, selon les travaux de Federico Barbero et ses coauteurs d'Oxford, de la NUS et de Google DeepMind.
Comment limiter l'effet du biais de position dans mes prompts ?
Placez les longs documents en haut du prompt et votre question à la fin, posez une seule question par message, et découpez un gros prompt en plusieurs plus courts. La documentation d'Anthropic recommande cet ordre pour les entrées de 20 000 tokens et plus et annonce jusqu'à 30 % de qualité de réponse en plus, un chiffre issu de ses propres tests. Demandez enfin au modèle d'extraire les passages pertinents avant de rédiger sa synthèse.
Quel impact le biais de position a-t-il sur le GEO ?
Un impact direct sur vos chances d'être cité. L'analyse de 1,2 million de résultats publiée par Kevin Indig en février 2026 montre que 44,2 % des citations de ChatGPT proviennent du premier tiers d'un article, contre 31,1 % du milieu et 24,7 % du dernier tiers. Placez donc définitions, chiffres clés et réponses directes dans les premiers paragraphes, et formulez vos H2 en questions : 78,4 % des citations liées à une question viennent d'un H2 ou d'un H3.