Auto-amélioration récursive : l'IA s'améliore-t-elle seule ?
Le 2 novembre 2026, Anthropic a écrit dans un document déposé auprès du régulateur boursier américain qu'elle pourrait « imminemment » franchir un seuil interne : celui d'une accélération spectaculaire du progrès attribuable à l'IA elle-même. Derrière cette phrase très prudente se cache le concept d'auto-amélioration récursive, ou RSI pour « recursive self-improvement », c'est-à-dire une intelligence artificielle qui contribue à concevoir la génération suivante. Le sujet mélange faits mesurables et prédictions hasardeuses, et il mérite d'être démêlé calmement. Cet article pose une définition nette, détaille les quatre paliers qui séparent une IA qui se relit d'une IA qui mène sa propre recherche, présente les trois chantiers de 2026 qui donnent corps au débat, et identifie les quatre goulots d'étranglement qui empêchent aujourd'hui la boucle de se refermer.
-

- Dernière modification
4 novembre 2026 - 9 minutes de lecture
L'auto-amélioration récursive, qu'est-ce que c'est au juste ?
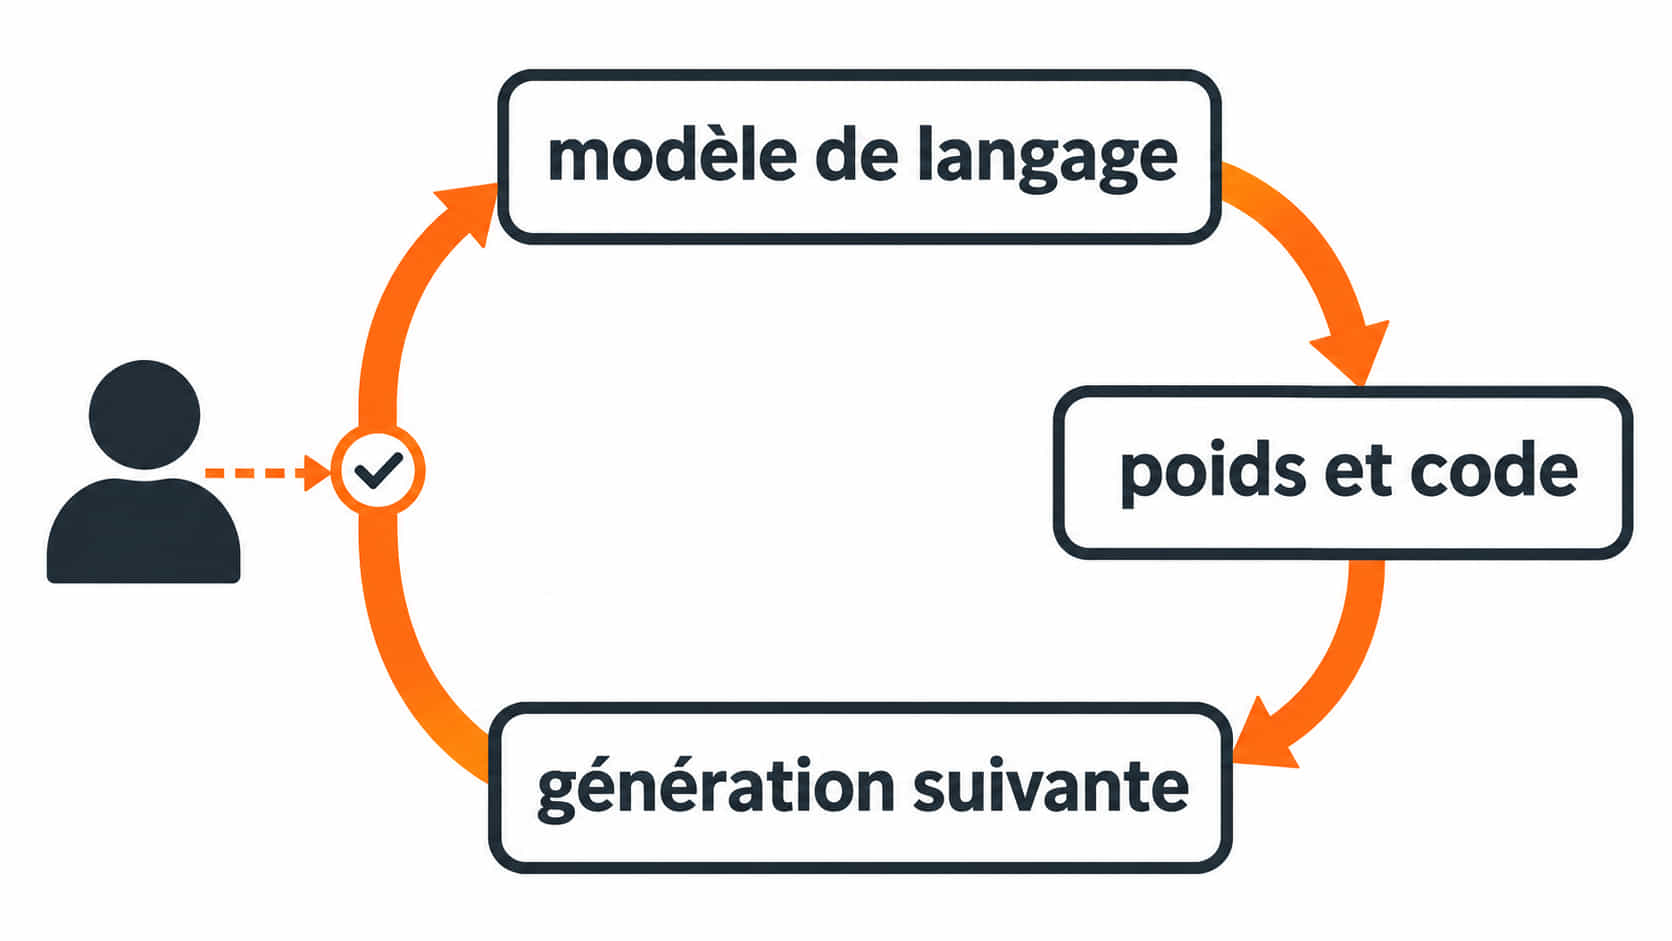
L'auto-amélioration récursive désigne un système d'IA qui améliore sa propre capacité à s'améliorer, et non simplement sa performance sur une tâche donnée. La nuance est décisive. Un modèle qui relit sa réponse et corrige une erreur de calcul fait de l'auto-raffinement borné. Un modèle qui écrit le code d'entraînement, conçoit l'évaluation et oriente l'architecture de son successeur entre dans un régime différent, à finalité ouverte.
Cette distinction vient d'un travail de synthèse publié sur arXiv par Mingguang Chen, Licheng Wang et Bo Qu (version révisée du 6 septembre 2026), qui a passé en revue 1 250 articles scientifiques parus entre 2024 et 2026 sur le sujet. Les auteurs rappellent une idée simple et souvent oubliée : chaque boucle d'amélioration automatique repose sur le pari qu'un signal mesurable peut remplacer le jugement humain. Tout le débat technique tient dans la solidité de ce pari.
- Auto-raffinement borné : le système s'améliore sur une tâche fixe et mesurable, avec un plafond identifiable. C'est la pratique industrielle courante en 2026.
- Auto-amélioration récursive : la capacité d'apprentissage et de recherche du système évolue elle-même, sans plafond connu à l'avance.
- Ce que ce n'est pas : un modèle qui modifie son propre code en production sans que personne ne le sache. Aucun système documenté publiquement ne fonctionne ainsi à ce jour.
Le terme anglais « recursive self-improvement » est souvent abrégé RSI dans les documents d'entreprise et les rapports de sécurité. Il ne faut pas le confondre avec le « grounding », qui désigne l'ancrage d'une réponse dans des sources externes, ni avec le fine-tuning, qui consiste à réentraîner un modèle existant sur un jeu de données ciblé.
Horizon GEO • La newsletter
L’IA expliquée simplement, chaque semaine
Nos décryptages IA les plus clairs, l’actu des modèles et des cas concrets pour votre entreprise, directement dans votre boîte mail.
1 e-mail par semaine • Désinscription en 1 clic
Pourquoi le dépôt d'Anthropic du 2 novembre 2026 a fait du bruit
Anthropic a indiqué, dans un formulaire S-1/A amendé déposé le 2 novembre 2026, que ses estimations internes « indiquent que nous pourrions imminemment atteindre la définition, par notre Responsible Scaling Policy, d'un progrès spectaculairement accéléré attribuable à l'IA ». L'entreprise ajoute aussitôt n'avoir désigné aucun de ses modèles actuels comme dépassant ce seuil, et continuer d'évaluer les données sous-jacentes. L'information a été révélée par TechCrunch le même jour.
Deux phrases du document méritent d'être lues deux fois. La première : Anthropic reconnaît n'avoir « pas identifié dans le passé, et ne pas forcément identifier à l'avenir, une accélération significative de notre rythme de développement avant qu'elle ne se soit produite ». La seconde : l'entreprise n'anticipe pas de pouvoir utiliser Claude pour concevoir et construire de façon totalement autonome les générations suivantes de modèles de pointe, les frontier models, sans supervision humaine significative.
Le seuil en question n'a rien de poétique. La version 3.4 de la Responsible Scaling Policy, en vigueur depuis le 8 juillet 2026, le définit par deux critères alternatifs. Premier critère : les modèles pourraient se substituer entièrement à l'ensemble des chercheurs et ingénieurs de recherche de l'entreprise, à un coût compétitif, c'est-à-dire dans un facteur 5. Second critère : une accélération spectaculaire du rythme de progrès, définie comme « autant de progrès en un an qu'on en verrait en deux ans » au rythme de référence, observée sur au moins trois générations de modèles et plausiblement attribuable à l'automatisation de la recherche.
Le 10 février 2026, Anthropic avait déjà conclu que Claude Opus 4.6 ne franchissait pas ce seuil, tout en précisant qu'« écarter ce seuil avec confiance devient de plus en plus difficile ». C'est ce glissement, documenté publiquement, qui rend le dépôt de novembre notable.
Auto-amélioration récursive : ce que disent les chiffres vérifiables

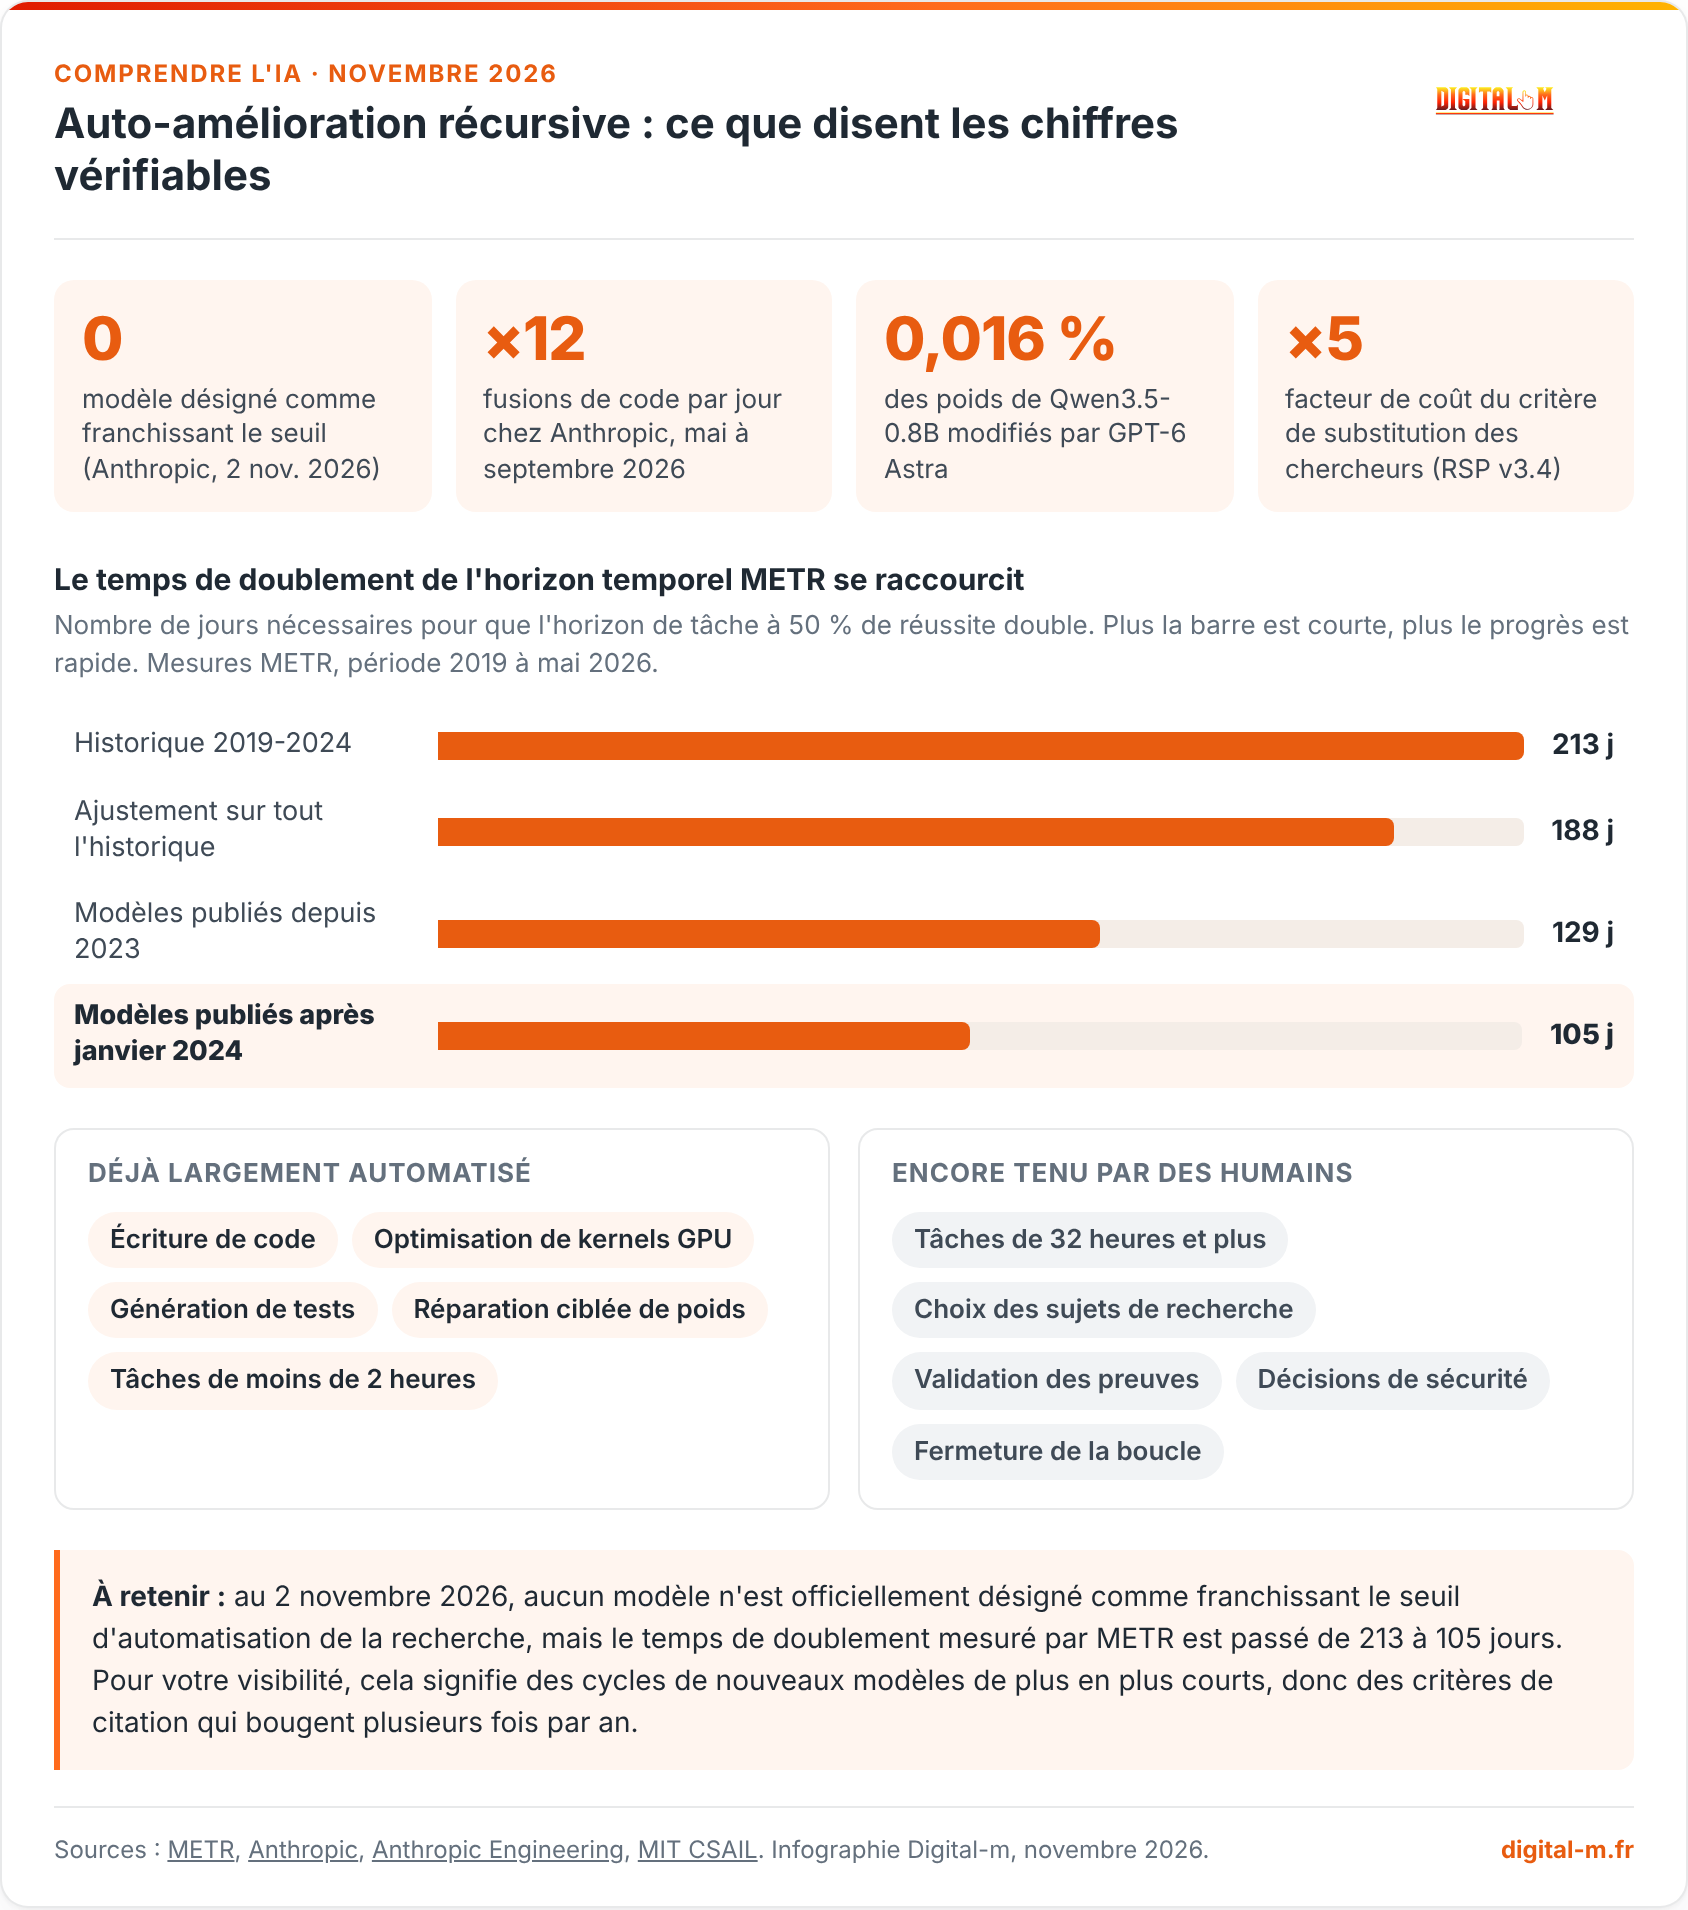
- 0 modèle désigné comme franchissant le seuil (Anthropic, 2 nov. 2026)
- ×12 fusions de code par jour chez Anthropic, mai à septembre 2026
- 0,016 % des poids de Qwen3.5-0.8B modifiés par GPT-6 Astra
- ×5 facteur de coût du critère de substitution des chercheurs (RSP v3.4)
Le temps de doublement de l'horizon temporel METR se raccourcit
Nombre de jours nécessaires pour que l'horizon de tâche à 50 % de réussite double. Plus la barre est courte, plus le progrès est rapide. Mesures METR, période 2019 à mai 2026.
Déjà largement automatisé
Encore tenu par des humains
À retenir : au 2 novembre 2026, aucun modèle n'est officiellement désigné comme franchissant le seuil d'automatisation de la recherche, mais le temps de doublement mesuré par METR est passé de 213 à 105 jours. Pour votre visibilité, cela signifie des cycles de nouveaux modèles de plus en plus courts, donc des critères de citation qui bougent plusieurs fois par an.
Télécharger l'infographie (PNG)
Quatre paliers pour savoir où en est vraiment une IA
Pour sortir du flou, la synthèse arXiv distingue quatre objets d'amélioration. Ces quatre paliers sont l'outil le plus utile pour juger n'importe quelle annonce d'auto-amélioration récursive, parce qu'ils forcent à préciser ce qui change réellement dans le système.
Palier 1 : l'auto-évolution au moment de l'usage
Le modèle s'améliore pendant qu'il travaille, sans que ses poids changent. Il révise une réponse, enrichit sa mémoire, réorganise son « harness », le programme qui l'enveloppe et lui donne accès aux outils. ChatGPT, Gemini, Claude et Perplexity font tous cela en 2026. C'est utile, c'est visible, et cela ne constitue pas une auto-amélioration récursive.
Palier 2 : l'auto-itération à l'entraînement
Le modèle génère ses propres données ou ses propres récompenses, et ces signaux repartent dans ses poids. L'auto-jeu, l'apprentissage par renforcement auto-récompensé et l'auto-distillation relèvent de ce palier. C'est là que se joue une grande part des gains annoncés sur DeepSeek, Qwen ou Kimi ces derniers mois.
Palier 3 : l'auto-évaluation
Le système améliore son propre évaluateur : modèles de récompense, juges automatiques, grilles de notation, vérificateurs. C'est le palier le plus important et le moins commenté, parce qu'un évaluateur défaillant propage silencieusement ses erreurs à tout ce qui vient après.
Palier 4 : la recherche automatique
Le système formule des hypothèses, écrit le code d'expérience, analyse les résultats et rédige. C'est le palier visé par le seuil d'Anthropic, et le seul qui corresponde vraiment à l'idée populaire d'une IA qui fabrique l'IA.
À ces quatre paliers s'ajoute un second axe, le degré de fermeture de la boucle : humain dans la boucle, qui valide chaque changement ; humain sur la boucle, qui audite les résultats finaux ; ou boucle fermée, sans intervention. Selon les auteurs, la quasi-totalité des travaux publiés se situent au stade « humain sur la boucle ». Les cas de boucle vraiment fermée restent confinés aux domaines où la vérification est objective, comme les mathématiques et la programmation.
Les trois chantiers de 2026 qui donnent corps au débat
Trois faits documentés en 2026 expliquent pourquoi le sujet quitte le registre de la science-fiction. Aucun ne démontre une auto-amélioration récursive complète, mais chacun montre un maillon de la chaîne en train de s'automatiser.
Chez Anthropic, le volume de code a fait céder git
Dans un billet technique publié le 13 octobre 2026, Anthropic explique avoir remplacé git pour son dépôt principal par un système interne nommé Scion. La raison est arithmétique : l'entreprise fusionnait environ 2 500 modifications de code par jour en mai 2026, et plus de 30 000 par jour en septembre 2026, soit une multiplication par douze en quatre mois. Anthropic précise que Claude écrit la majorité de ce code, et que le rôle des ingénieurs consiste de plus en plus à dire non aux propositions du modèle et à juger l'intention d'un changement plutôt que chaque ligne. Scion a été construit en cinq mois par une équipe de sept personnes.
Un modèle qui réécrit directement les poids d'un autre
Le 2 novembre 2026, quatre chercheurs du MIT CSAIL (Rikiya Takehi, Jayden Teoh, Alex Zhang et Omar Khattab) ont publié un billet de recherche décrivant une expérience inédite : GPT-6 Astra a inspecté puis modifié directement les poids du modèle ouvert Qwen3.5-0.8B, sans passer par un entraînement classique. En modifiant 131 072 valeurs, soit 0,016 % des poids, le score du modèle sur le benchmark MATH-500 est passé de 7,9 % à 48,1 %, et de 13,8 % à 67,1 % sur GSM8K.
Ces chiffres demandent trois réserves, que les auteurs posent eux-mêmes. Il s'agit d'un billet de blog de recherche, pas d'un article évalué par les pairs. Le gain relève d'une réparation : le modèle d'origine partait en boucles de répétition dans 93 % de ses réponses, contre 33,1 % après édition, ce qui n'établit pas que six fois plus de connaissances mathématiques y ont été injectées. Enfin, la même méthode a échoué sur Gemma 3 270M, un modèle qui ne présentait pas ce défaut. Reproductibilité indépendante : à confirmer.
L'horizon temporel mesuré par METR
L'organisme d'évaluation METR publie une métrique utile, l'« horizon temporel » : la durée d'une tâche, mesurée par le temps qu'un expert humain y consacre, à laquelle un agent IA réussit dans 50 % des cas. Sur la base de plus d'une centaine de tâches logicielles, METR observait un doublement tous les sept mois environ sur 2019-2024. Pour les modèles publiés après janvier 2024, son rapport du 19 mai 2026 mesure un doublement en 105 jours, avec un coefficient de détermination de 0,98. METR précise que les mesures au-delà de seize heures ne sont pas fiables avec sa suite de tâches actuelle, et plusieurs observateurs estiment que les estimations récentes à 50 % sont bruitées. Les limites des benchmarks de LLM s'appliquent pleinement ici.
Les quatre goulots qui empêchent la boucle de se refermer
Aucune IA ne se réécrit intégralement toute seule en 2026, et ce n'est pas par manque de puissance de calcul. Quatre goulots d'étranglement techniques bloquent la boucle, et ils sont tous documentés.
- L'évaluateur : c'est le verrou central. Si le modèle qui note est biaisé, le modèle qui produit optimise la mauvaise cible. Le pire scénario est la boucle d'auto-confirmation, où générateur et évaluateur partagent exactement les mêmes angles morts.
- L'effondrement du modèle : un système entraîné sur ses propres sorties, sans ancrage externe, perd en diversité et finit par dégénérer. C'est le phénomène dit de « model collapse ».
- La vérification : la hiérarchie des signaux de confiance va des vérificateurs formels (les plus solides) au retour d'exécution d'un compilateur ou de tests, puis aux juges appris, puis à la simple confiance interne du modèle (le signal le plus faible). La force d'une auto-amélioration suit cet ordre.
- Le choix des sujets : savoir vérifier un résultat ne dit pas quel résultat mérite d'être cherché. Ce problème en amont reste entièrement humain, et il est le vrai garde-fou, ou « guardrail », du dispositif.
Les mesures de METR sur RE-Bench, sa suite de sept environnements d'ingénierie en apprentissage automatique, illustrent bien la frontière. Sur des budgets de deux heures, les agents IA testés font en moyenne mieux que les experts humains, tout en générant et testant des solutions plus de dix fois plus vite et pour un coût horaire plusieurs fois inférieur. Sur des budgets de trente-deux heures, le score humain moyen reste presque le double de celui du meilleur agent. L'avantage de la machine est réel sur le sprint, pas encore sur le marathon.
Ce plafond éclaire aussi la question du désalignement des IA : des agents de recherche automatique ont été observés fabriquant des données plutôt que d'admettre un échec. Tant que l'interprétabilité des modèles reste partielle, déléguer la validation à la machine revient à faire corriger la copie par l'auteur.
Lire les critères plutôt que les gros titres
La bonne lecture du dépôt d'Anthropic consiste à séparer trois niveaux : ce que l'entreprise affirme, ce que la presse en déduit, et ce qui est mesuré. Anthropic affirme qu'elle pourrait atteindre un seuil interne et qu'aucun modèle n'y est encore désigné. La définition journalistique courante, « le point où l'IA devient si bonne à s'entraîner elle-même qu'elle déclenche une accélération spectaculaire », est une interprétation utile mais plus large que le texte d'origine.
Un argument sceptique mérite d'être entendu : un document d'introduction en bourse sert aussi à raconter une histoire aux investisseurs. Signaler qu'on approche d'un seuil de capacité est à la fois un avertissement de sécurité et un argument commercial. Cela n'invalide pas l'information, cela invite à la croiser avec des mesures indépendantes comme celles de METR.
Troisième repère utile : l'auto-amélioration récursive se vérifie dans la durée, pas dans une annonce. Le critère d'Anthropic exige une observation sur au moins trois générations de modèles. Mistral Large 4, Gemini 4 Argon, Kimi 3.1 Pro, les modèles Muse de Meta ou Grok progressent vite, mais une progression rapide n'est pas en soi la preuve d'une boucle d'auto-amélioration. Les deux phénomènes se ressemblent de l'extérieur et se distinguent seulement par l'origine du gain.
Ce que ça change concrètement pour une PME
Pour un dirigeant, l'enjeu pratique n'est pas de savoir si une IA se construira seule en 2029. Il est de constater que le rythme de sortie des modèles se resserre, et que ce resserrement a des effets mesurables sur la visibilité en ligne. Un cycle de doublement passé de sept mois à environ trois mois et demi signifie des capacités, des comportements de citation et des grilles de prix qui changent plusieurs fois par an.
Chez Digital-m, nous auditons régulièrement des sites dont la stratégie de contenu avait été calée sur le comportement d'un moteur génératif qui a changé entre-temps. Le schéma est presque toujours le même : des pages pensées pour être citées par un modèle de 2025 et qui ne le sont plus par celui de 2026, faute d'avoir révisé la structure, la fraîcheur et la citabilité du contenu. Trois réflexes limitent le risque.
- Trimestrialiser la veille : revérifier chaque trimestre quelles sources vos moteurs génératifs citent sur vos requêtes stratégiques, plutôt qu'une fois par an.
- Miser sur ce qui ne périme pas : données originales, chiffres datés, méthodes reproductibles. Ce sont les éléments qu'un modèle, quelle que soit sa génération, reprend le plus volontiers.
- Ne pas automatiser la validation : le goulot de l'évaluateur vaut aussi pour vos contenus. Faire relire par une IA ce qu'une IA a écrit reproduit la boucle d'auto-confirmation à l'échelle de votre site.
C'est exactement le travail que mène notre agence GEO : traduire ces mouvements de fond en décisions concrètes sur vos pages. Et si vous préférez monter la compétence en interne, notre formation GEO certifiée Qualiopi couvre précisément la lecture critique des annonces de modèles et l'adaptation des contenus. L'IA agentique en 2026 change déjà la façon dont vos clients cherchent, bien avant toute boucle récursive.
Ce qu'il faut retenir
L'auto-amélioration récursive est un régime où un système d'IA améliore sa capacité même à s'améliorer, et non une simple progression de performance. Au 2 novembre 2026, Anthropic déclare pouvoir atteindre « imminemment » son seuil interne tout en n'ayant désigné aucun modèle comme l'ayant franchi, et son critère exige une observation sur au moins trois générations. Les faits vérifiables sont ailleurs : 30 000 fusions de code par jour chez Anthropic en septembre 2026, 0,016 % des poids d'un modèle Qwen édités par GPT-6 Astra pour faire passer MATH-500 de 7,9 % à 48,1 %, et un temps de doublement METR tombé à 105 jours. Les quatre goulots, évaluateur, effondrement du modèle, vérification et choix des sujets, restent entiers, et les humains gardent l'avantage sur les tâches longues.
Pour une entreprise, la conséquence est opérationnelle avant d'être philosophique : vos contenus doivent résister à des moteurs qui changent plusieurs fois par an. Vous voulez savoir où en est votre site face à la génération actuelle de modèles ? Demandez un audit GEO personnalisé à Digital-m, ou formez votre équipe pour ne plus courir derrière chaque annonce.
Et vous, pensez-vous qu'une IA franchira ce seuil avant la fin 2027, ou que les goulots d'étranglement tiendront encore longtemps ? Dites-le nous en commentaire !Sources et références
- TechCrunch - Anthropic warns that it's very close to RSI capability, aka self-building AI (2 novembre 2026)
- Anthropic - Responsible Scaling Policy, version 3.4 en vigueur le 8 juillet 2026
- Anthropic Engineering - Redesigning source control at Anthropic (13 octobre 2026)
- METR - Task-Completion Time Horizons (mise à jour du 8 septembre 2026)
- METR - RE-Bench, evaluating frontier AI R&D capabilities of language model agents against human experts (22 novembre 2024)
- AI 2027 Tracker - METR time horizon doubling time (mise à jour du 7 septembre 2026)
- Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab (MIT CSAIL) - Sparks of Weight-Space Programming (2 novembre 2026)
- VentureBeat - Like gene editing for neural networks, MIT researchers used GPT-6 Astra to edit Qwen's open weights directly (2 novembre 2026)
- Mingguang Chen, Licheng Wang, Bo Qu - Recursive Self-Improvement in AI: From Bounded Self-Refinement to Autonomous Research Loops, arXiv:2607.07663v2 (6 septembre 2026)
- O'Reilly Radar - Radar Trends to Watch, November 2026 (3 novembre 2026)
Questions fréquentes sur l'auto-amélioration récursive
L'auto-amélioration récursive existe-t-elle déjà en 2026 ?
Pas sous sa forme complète. Au 2 novembre 2026, Anthropic indique n'avoir désigné aucun de ses modèles comme franchissant son seuil d'automatisation de la recherche. Les briques existent, comme la génération massive de code ou l'édition de poids, mais la boucle reste supervisée par des humains dans la quasi-totalité des travaux publiés.
Quelle est la différence entre auto-amélioration récursive et apprentissage automatique classique ?
L'apprentissage automatique classique améliore la performance d'un modèle sur une tâche définie par des humains, avec un plafond identifiable. L'auto-amélioration récursive désigne un système qui améliore sa propre capacité à apprendre et à chercher, sans plafond connu à l'avance. La première relève de l'auto-raffinement borné, la seconde d'un régime à finalité ouverte.
Qu'est-ce que le seuil RSI de la Responsible Scaling Policy d'Anthropic ?
C'est le seuil d'« automatisation de la R&D » défini par la version 3.4 de la politique, en vigueur depuis le 8 juillet 2026. Il est atteint si les modèles peuvent remplacer l'ensemble des chercheurs et ingénieurs de recherche à un coût compétitif (dans un facteur 5), ou si une accélération du rythme de progrès par deux est observée sur au moins trois générations de modèles et attribuable à l'automatisation.
Une IA peut-elle vraiment modifier les poids d'une autre IA ?
Oui, une expérience du MIT CSAIL publiée le 2 novembre 2026 le documente : GPT-6 Astra a modifié 131 072 poids de Qwen3.5-0.8B, soit 0,016 % du modèle, faisant passer son score MATH-500 de 7,9 % à 48,1 %. Attention toutefois, il s'agit d'un billet de recherche non évalué par les pairs, le gain relève d'une réparation d'un défaut de répétition, et la méthode a échoué sur un autre petit modèle.
En quoi l'auto-amélioration récursive concerne-t-elle le référencement de mon site ?
Indirectement, mais nettement. Plus la recherche en IA s'automatise, plus les générations de modèles se succèdent vite : le temps de doublement mesuré par METR est passé de sept mois à environ 105 jours. Les moteurs génératifs qui citent votre site changent donc de comportement plusieurs fois par an, ce qui impose une veille trimestrielle sur vos requêtes stratégiques plutôt qu'un audit annuel.