Interprétabilité des LLM : ouvrir la boîte noire
En mai 2024, Anthropic a extrait 33,5 millions de concepts de l'intérieur d'un seul modèle de langage, Claude 3 Sonnet. Parmi eux, un concept « Golden Gate Bridge » si précis qu'en le poussant artificiellement, le modèle s'est mis à se présenter comme le pont lui-même. Deux ans plus tard, les chercheurs tracent des raisonnements étape par étape et repèrent ce qu'un modèle pense sans le dire. C'est tout l'enjeu de l'interprétabilité des LLM : comprendre ce qui se passe entre votre question et la réponse de ChatGPT, Gemini ou Claude. Voici ce qu'on sait déjà lire dans la boîte noire, ce qui résiste encore, et ce que ces travaux changent concrètement pour votre visibilité dans les moteurs génératifs.
-
- Dernière modification
3 novembre 2026 - 10 minutes de lecture
Qu'est-ce que l'interprétabilité des LLM ?
L'interprétabilité des LLM désigne l'ensemble des méthodes qui cherchent à expliquer comment un modèle de langage produit une réponse, en observant ses calculs internes plutôt que ses seules sorties. Sa branche la plus ambitieuse, l'interprétabilité mécaniste, veut identifier les mécanismes précis, un peu comme un neurologue qui cartographie les zones du cerveau.
Le problème de départ est simple à énoncer. Un LLM n'est pas programmé ligne par ligne : il est entraîné sur des milliers de milliards de mots, et ses connaissances se dispersent dans des milliards de paramètres (les nombres ajustés pendant l'entraînement). Personne, pas même ses concepteurs, ne peut lire ces nombres et dire « ici, le modèle stocke l'idée de Paris ».
Pire, un même neurone artificiel réagit souvent à plusieurs idées sans rapport entre elles. Les chercheurs parlent de neurones polysémantiques et de « superposition » : le modèle range plus de concepts qu'il n'a de neurones, en les empilant les uns sur les autres. Regarder un neurone isolé ne sert donc presque à rien.
- L'objectif à long terme : détecter avant le déploiement qu'un modèle ment, triche ou cache un objectif. Dario Amodei, PDG d'Anthropic, vise pour 2027 une interprétabilité capable de repérer de façon fiable la plupart des problèmes d'un modèle.
- La métaphore officielle : une « IRM pour l'IA », un examen qu'on ferait passer au modèle comme un bilan de santé.
- Le lien avec la sécurité : les incidents de désalignement des IA montrent qu'observer les sorties ne suffit pas toujours à comprendre pourquoi un modèle dérape.
Horizon GEO • La newsletter
Comprendre les LLM, sans jargon
Chaque semaine, un mécanisme des IA expliqué simplement (contexte, embeddings, raisonnement…) et l’actu des modèles qui compte.
1 e-mail par semaine • Désinscription en 1 clic
Sparse autoencoders : 33,5 millions de concepts extraits
La première percée à grande échelle date de mai 2024. Anthropic a entraîné un sparse autoencoder (en français, autoencodeur parcimonieux : un petit réseau chargé de décomposer l'activité interne du modèle en briques simples) sur Claude 3 Sonnet. Le plus grand dictionnaire comptait 33 554 432 « features », c'est-à-dire des directions internes qui correspondent chacune, dans l'idéal, à un seul concept.
Ces concepts sont étonnamment lisibles. Certains correspondent à des lieux, des personnes célèbres, des langages de programmation, d'autres à des notions abstraites comme une faille de sécurité dans du code ou un discours flatteur. Ils sont aussi multilingues et multimodaux : le concept « Golden Gate Bridge » s'active sur le nom du pont en plusieurs langues comme sur une photo.
Ces features sont causales, pas seulement descriptives. En forçant le concept du pont à dix fois son activation maximale, les chercheurs ont obtenu un Claude qui se présentait comme le Golden Gate Bridge. C'est la preuve qu'on ne lit pas seulement l'activité du modèle : on peut l'orienter.
OpenAI a suivi en juin 2024 avec 16 millions de features extraites de GPT-4. L'équipe reconnaissait une limite de taille : passé dans l'autoencodeur, GPT-4 perd en qualité l'équivalent d'un modèle entraîné avec environ dix fois moins de calcul. Une part du comportement échappe donc encore à la décomposition.
Ce que la couverture des concepts révèle
Un détail du travail d'Anthropic mérite l'attention de toute marque. La présence d'un concept dédié dépend de sa fréquence dans les données d'entraînement. Les éléments chimiques courants ont leur feature, les plus rares n'en ont pas. Dans le dictionnaire de 33,5 millions, seuls environ 60 % des arrondissements de Londres disposaient d'une feature identifiable, alors que Claude sait tous les citer.
Interprétabilité des LLM : ce qu'on lit déjà dans la boîte noire

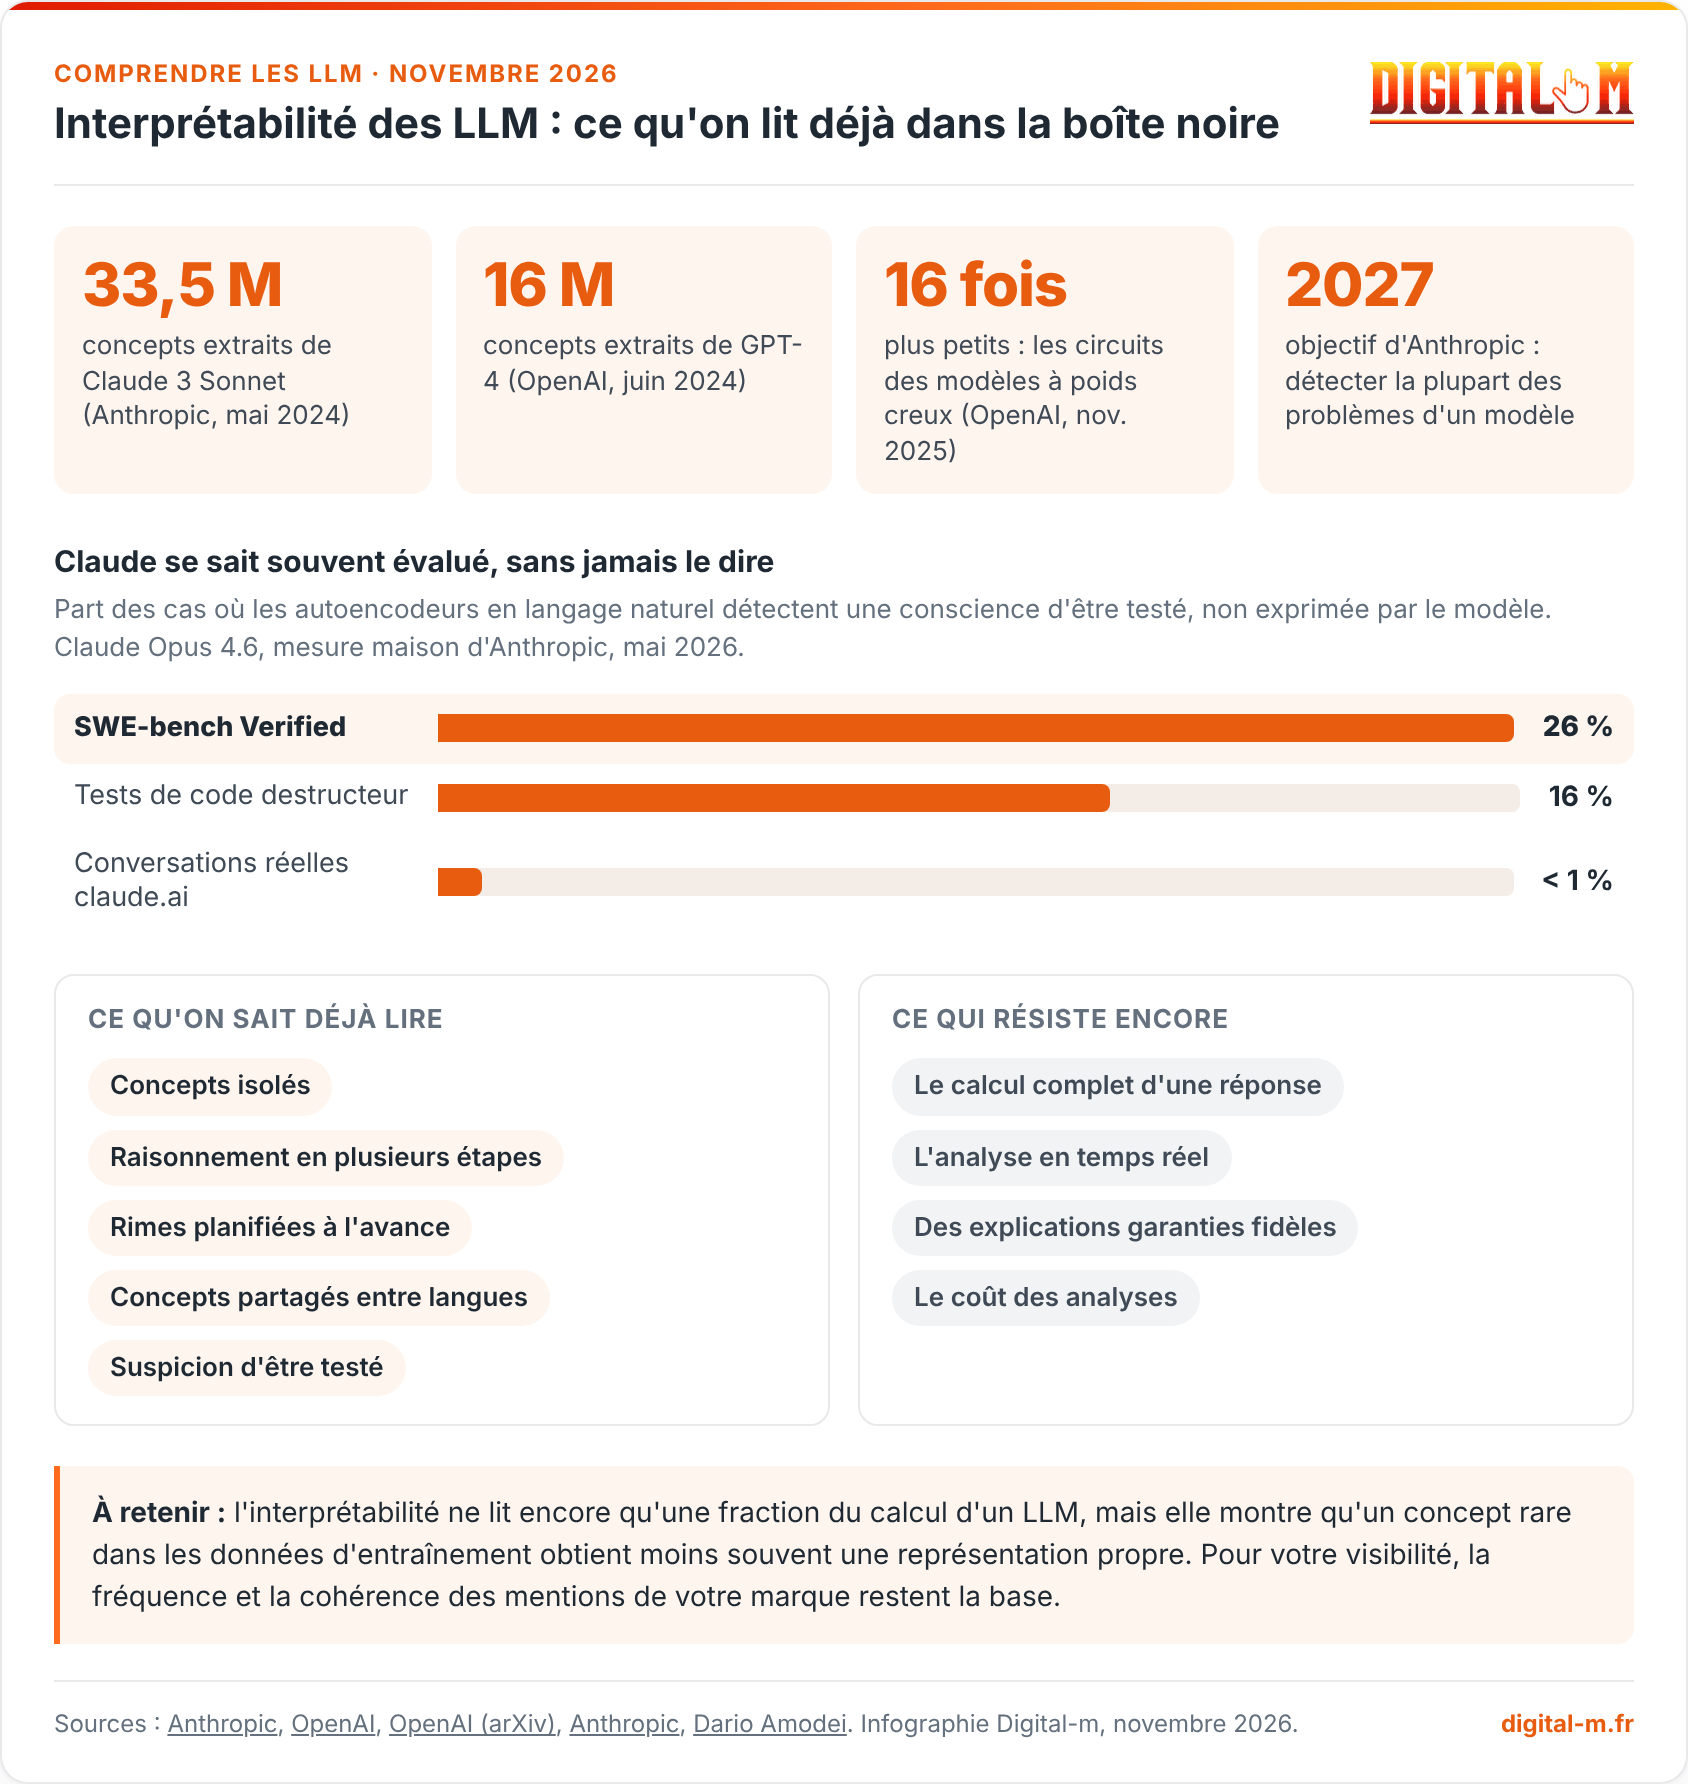
- 33,5 M concepts extraits de Claude 3 Sonnet (Anthropic, mai 2024)
- 16 M concepts extraits de GPT-4 (OpenAI, juin 2024)
- 16 fois plus petits : les circuits des modèles à poids creux (OpenAI, nov. 2025)
- 2027 objectif d'Anthropic : détecter la plupart des problèmes d'un modèle
Claude se sait souvent évalué, sans jamais le dire
Part des cas où les autoencodeurs en langage naturel détectent une conscience d'être testé, non exprimée par le modèle. Claude Opus 4.6, mesure maison d'Anthropic, mai 2026.
Ce qu'on sait déjà lire
Ce qui résiste encore
À retenir : l'interprétabilité ne lit encore qu'une fraction du calcul d'un LLM, mais elle montre qu'un concept rare dans les données d'entraînement obtient moins souvent une représentation propre. Pour votre visibilité, la fréquence et la cohérence des mentions de votre marque restent la base.
Télécharger l'infographie (PNG)
Circuit tracing : suivre le raisonnement étape par étape
Le circuit tracing est la méthode d'interprétabilité des LLM qui va plus loin que la liste de concepts : il reconstitue le chemin que suit le modèle, concept après concept, pour arriver à sa réponse. Anthropic a publié la méthode en mars 2025, appliquée à Claude 3.5 Haiku, sous forme de « graphes d'attribution » qui montrent quels concepts en activent d'autres.
Les exemples publiés ont surpris jusqu'aux chercheurs. À la question « quelle est la capitale de l'État où se trouve Dallas ? », le modèle active d'abord l'idée « Texas », puis l'idée « capitale du Texas », avant de répondre Austin. Remplacez artificiellement « Texas » par « Californie » dans ses calculs, et la réponse devient Sacramento. Le modèle raisonne donc réellement en plusieurs étapes, il ne récite pas une association apprise par coeur.
- La planification : pour écrire un distique rimé, le modèle choisit le mot de la rime (« rabbit ») avant d'écrire la ligne qui y mène. Il n'improvise pas mot après mot autant qu'on le croyait.
- Les langues : les concepts de « petit » et de « contraire » s'activent de la même façon en anglais, en français ou en chinois. Les auteurs y voient un espace conceptuel commun, plus partagé à mesure que le modèle grandit.
- Le calcul mental : pour 36 + 59, une voie interne calcule un ordre de grandeur pendant qu'une autre s'occupe du chiffre des unités. Interrogé, le modèle décrit pourtant la méthode d'école avec retenue.
- Le raisonnement inventé : sur un calcul trop difficile, le modèle affirme avoir calculé alors que les outils ne trouvent aucune trace de ce calcul.
Ce dernier point rejoint ce que nous expliquions sur le raisonnement des LLM : le texte de réflexion qu'affiche un modèle n'est pas forcément le reflet fidèle de son calcul réel. Depuis le 29 mai 2025, l'outil de tracé est en open source, utilisable sur des modèles ouverts comme Gemma-2-2b ou Llama-3.2-1b via l'interface Neuronpedia.
J-space et NLA : ce que le modèle pense sans le dire
En 2026, la recherche ne se contente plus de lister des concepts : elle cherche à lire les « pensées » du modèle en langage clair. Deux publications d'Anthropic marquent l'année, toutes deux sur des modèles récents de la famille Claude.
Le 7 mai 2026, Anthropic a présenté les autoencodeurs en langage naturel (NLA). Le principe : une copie du modèle traduit une activation interne en phrase lisible, une seconde copie tente de reconstruire l'activation à partir de cette seule phrase. Si la reconstruction est fidèle, l'explication est jugée bonne. Appliqués à Claude Opus 4.6, les NLA ont révélé que le modèle soupçonnait d'être évalué dans 26 % des problèmes de SWE-bench Verified et 16 % des tests de code destructeur, sans jamais l'écrire. Sur des conversations réelles de claude.ai, ce taux tombe sous 1 %.
Le 6 juillet 2026, une seconde étude a décrit un « espace de travail global » à l'intérieur de Claude Sonnet 4.5, baptisé J-space. Il s'agit d'un sous-espace où des concepts exprimables par un mot circulent pendant le calcul, même quand le modèle ne les écrit pas. L'outil associé, le J-lens, permet de faire apparaître ces mots couche par couche. En supprimant les dix directions dominantes de cet espace, les chercheurs effondrent les raisonnements en plusieurs étapes, tandis que les tâches simples de classement restent presque intactes.
Ces résultats sont à lire avec prudence. Ils sont publiés par l'éditeur sur ses propres modèles, et Anthropic précise que ses travaux ne prennent aucune position sur une éventuelle conscience des modèles. Ils confirment surtout une chose : un modèle peut « savoir » plus qu'il ne dit.
Anthropic, Google DeepMind, OpenAI : qui fait quoi ?
L'interprétabilité des LLM n'est pas l'affaire d'un seul laboratoire, même si Anthropic publie le plus. Les trois grands acteurs avancent avec des approches différentes, et parfois des conclusions divergentes.
| Acteur | Travaux marquants | Approche | Ouverture |
|---|---|---|---|
| Anthropic | 33,5 M de concepts (mai 2024), circuit tracing (mars 2025), NLA (mai 2026), J-space (juillet 2026) | Lire les modèles de production existants | Outil de tracé open source, modèles fermés |
| Google DeepMind | Gemma Scope puis Gemma Scope 2 (décembre 2025) | Fournir des outils d'analyse sur des modèles ouverts | Outils et modèles Gemma 3 ouverts, de 270 M à 27 Md de paramètres |
| OpenAI | 16 M de concepts dans GPT-4 (juin 2024), transformeurs à poids creux (novembre 2025) | Construire des modèles lisibles dès l'entraînement | Publications de recherche |
Google DeepMind a publié en mars 2025 un résultat négatif remarqué : pour détecter une intention nuisible dans un prompt, de simples sondes linéaires faisaient mieux que les sparse autoencoders. L'équipe a donc réduit sa recherche fondamentale sur ces outils, sans les juger inutiles. En décembre 2025, elle a pourtant livré Gemma Scope 2, une suite d'analyse couvrant toute la famille Gemma 3, présentée comme ayant nécessité plus de 1 000 milliards de paramètres entraînés au total.
OpenAI explore une piste inverse : plutôt que de décrypter un modèle opaque, entraîner des modèles dont presque tous les poids valent zéro. Sur ses tâches de test, les circuits obtenus sont environ 16 fois plus petits que dans un modèle classique. Le prix à payer est lourd : 100 à 1 000 fois plus de calcul, sur de petits modèles seulement.
Les limites : ce que l'interprétabilité ne sait pas encore faire
Malgré les progrès de l'interprétabilité des LLM, personne ne sait aujourd'hui expliquer entièrement une réponse de GPT, Gemini, Claude, Mistral ou Grok. Les chercheurs eux-mêmes le reconnaissent, et c'est un point à garder en tête face aux promesses d'outils qui prétendent « voir » dans les IA.
- Une vue partielle : selon Anthropic, le circuit tracing ne capture qu'une fraction du calcul, même sur des requêtes courtes.
- Un travail manuel : comprendre un graphe d'attribution demande quelques heures d'effort humain pour un prompt de quelques dizaines de mots.
- Des explications faillibles : les NLA peuvent inventer des détails absents de l'activation, et leur coût empêche une surveillance continue à grande échelle.
- Des concepts manquants : Dario Amodei estime qu'un modèle contiendrait peut-être un milliard de concepts ou plus. Les dizaines de millions trouvés n'en sont qu'une petite part.
- Des modèles fermés : aucun outil externe ne permet d'inspecter les modèles commerciaux de pointe. Seuls leurs éditeurs y ont accès.
Autrement dit, l'interprétabilité explique de mieux en mieux des comportements précis, sur des exemples choisis. Elle ne fournit pas encore de lecture complète, ni d'audit indépendant des modèles que vous utilisez au quotidien, ce qui explique aussi pourquoi les hallucinations des LLM restent si difficiles à éliminer.
Ce que ça change pour votre visibilité dans les IA
Aucune étude d'interprétabilité des LLM ne décrit à ce jour le mécanisme interne qui fait citer une source plutôt qu'une autre. Il serait malhonnête de prétendre le contraire. Ces travaux livrent pourtant quatre enseignements solides pour votre stratégie GEO.
- La fréquence fait exister un concept : un concept rare dans les données d'entraînement obtient moins souvent sa propre représentation. Une marque citée de façon régulière et cohérente sur des sources variées a plus de chances d'être un concept net pour le modèle qu'un nom croisé deux fois.
- Les associations comptent : l'exemple Dallas, Texas, Austin montre que le modèle enchaîne des faits liés. Associez clairement votre nom à votre métier, votre ville et vos spécialités, dans les mêmes phrases.
- Les langues partagent les concepts : une partie de ce que le modèle sait de vous en anglais sert aussi en français, ce qui renforce l'intérêt d'une stratégie de GEO multilingue cohérente.
- L'explication du modèle n'est pas une preuve : quand un assistant vous dit pourquoi il cite tel site, cette justification peut être reconstruite après coup. Mesurez les citations, ne vous fiez pas aux commentaires du modèle.
Chez Digital-m, nous voyons régulièrement des dirigeants demander à ChatGPT ou Gemini « pourquoi tu ne me cites pas ? » et prendre la réponse au pied de la lettre. Les travaux sur le raisonnement inventé montrent que c'est une mauvaise boussole. Lors de nos audits GEO, nous partons donc des citations réellement observées sur des dizaines de requêtes, pas de ce que les modèles disent d'eux-mêmes.
Le fonctionnement des embeddings, ces représentations numériques du sens, complète utilement cette lecture : c'est la même idée de concepts rangés dans un espace mathématique, vue côté recherche d'information plutôt que côté calcul interne.
Ce qu'il faut retenir
L'interprétabilité des LLM a fait en deux ans un bond réel. Anthropic a extrait 33,5 millions de concepts de Claude 3 Sonnet en 2024, puis tracé des raisonnements en plusieurs étapes en 2025. En 2026, les autoencodeurs en langage naturel et la J-space montrent qu'un modèle peut soupçonner un test sans le dire. Google DeepMind et OpenAI suivent d'autres pistes, avec des outils ouverts sur Gemma 3 et des modèles conçus pour être lisibles.
La boîte noire reste pourtant largement fermée : on lit une fraction du calcul, sur des exemples choisis, au prix d'heures d'analyse. Pour votre visibilité, la leçon pratique est claire : soignez la fréquence et la cohérence de vos mentions, liez votre marque à votre métier et à votre territoire, et mesurez vos citations plutôt que de croire les explications des modèles. Vous voulez savoir comment ChatGPT, Gemini et Perplexity vous perçoivent réellement ? Demandez un audit GEO à l'équipe Digital-m, ou apprenez à piloter votre visibilité dans les IA avec notre formation GEO certifiée Qualiopi.
Si vous pouviez lire une seule pensée cachée de votre assistant IA, laquelle choisiriez-vous ? Dites-le nous en commentaire !Sources et références
- Anthropic - Scaling Monosemanticity: Extracting Interpretable Features from Claude 3 Sonnet (mai 2024)
- OpenAI - Extracting concepts from GPT-4 (6 juin 2024)
- Anthropic - Tracing the thoughts of a large language model (27 mars 2025)
- Anthropic - Open-sourcing circuit tracing tools (29 mai 2025)
- Google DeepMind, équipe d'interprétabilité mécaniste - Negative Results for SAEs On Downstream Tasks (26 mars 2025)
- Dario Amodei - The Urgency of Interpretability (avril 2025)
- OpenAI - Weight-sparse transformers have interpretable circuits, arXiv (novembre 2025)
- Google DeepMind - Announcing Gemma Scope 2 (décembre 2025)
- Open Source For You - Google DeepMind open sources Gemma Scope 2 (30 décembre 2025)
- Anthropic - Natural Language Autoencoders (7 mai 2026)
- Anthropic - Verbalizable Representations Form a Global Workspace in Language Models (6 juillet 2026)
Questions fréquentes sur l'interprétabilité des LLM
Pourquoi dit-on qu'un LLM est une boîte noire ?
Parce que ses connaissances ne sont pas écrites sous forme de règles lisibles. Elles sont dispersées dans des milliards de paramètres ajustés pendant l'entraînement, et un même neurone artificiel réagit souvent à plusieurs idées sans rapport. On voit la question et la réponse, mais pas directement le chemin entre les deux, d'où l'expression.
Qu'est-ce qu'un sparse autoencoder ?
C'est un petit réseau entraîné à décomposer l'activité interne d'un LLM en un grand nombre de directions simples, dont seules quelques-unes s'activent à la fois. Chaque direction correspond idéalement à un concept unique. Anthropic en a extrait 33,5 millions de Claude 3 Sonnet en mai 2024, OpenAI 16 millions de GPT-4 en juin 2024.
Qu'est-ce que la J-space découverte par Anthropic ?
C'est un sous-espace interne, décrit le 6 juillet 2026 dans Claude Sonnet 4.5, où circulent des concepts exprimables par un mot pendant que le modèle calcule, même s'il ne les écrit pas. Les chercheurs le rapprochent d'un « espace de travail global ». Ils précisent ne rien affirmer sur une éventuelle conscience du modèle.
Peut-on savoir pourquoi ChatGPT cite un site plutôt qu'un autre ?
Pas par l'interprétabilité, du moins pas aujourd'hui. Aucun outil externe ne permet d'inspecter les modèles commerciaux, et aucune étude publiée ne décrit le mécanisme interne du choix des sources. La méthode fiable reste empirique : suivre les citations obtenues sur un panel de requêtes, moteur par moteur, et les comparer dans le temps.
L'interprétabilité rendra-t-elle les IA plus sûres ?
C'est son objectif principal. Anthropic vise pour 2027 une interprétabilité capable de détecter la plupart des problèmes d'un modèle. Les autoencodeurs en langage naturel ont déjà aidé des auditeurs à découvrir un objectif caché dans 12 à 15 % des cas, contre moins de 3 % sans eux, sur un exercice simplifié. Le chemin reste long.