Function calling : comment un LLM utilise des outils ?
134 000 tokens. C'est le poids qu'atteignaient les définitions d'outils branchées sur l'assistant interne d'Anthropic avant optimisation, consommés avant même la première question de l'utilisateur. Derrière ce chiffre se cache un mécanisme que presque tout le monde utilise sans le nommer : le function calling, la capacité d'un LLM à demander l'exécution d'un outil externe plutôt que d'inventer une réponse. C'est lui qui permet à ChatGPT de consulter un agenda, à Gemini d'interroger une base clients, à Mistral de lancer un calcul. C'est aussi lui qui explique pourquoi un agent IA impeccable en démonstration réussit une tâche sur deux en production. Voici le mécanisme exact, son coût réel, et les endroits précis où il casse.
-

- Dernière modification
14 octobre 2026 - 9 minutes de lecture
Le function calling, c'est quoi exactement ?
Le function calling est le mécanisme par lequel un LLM, au lieu de rédiger une réponse en texte, renvoie une demande structurée d'appel d'outil : un nom de fonction et une liste d'arguments. Le terme anglais « tool use » (usage d'outil) désigne exactement la même chose chez Anthropic, et « appel de fonction » en est la traduction française courante.
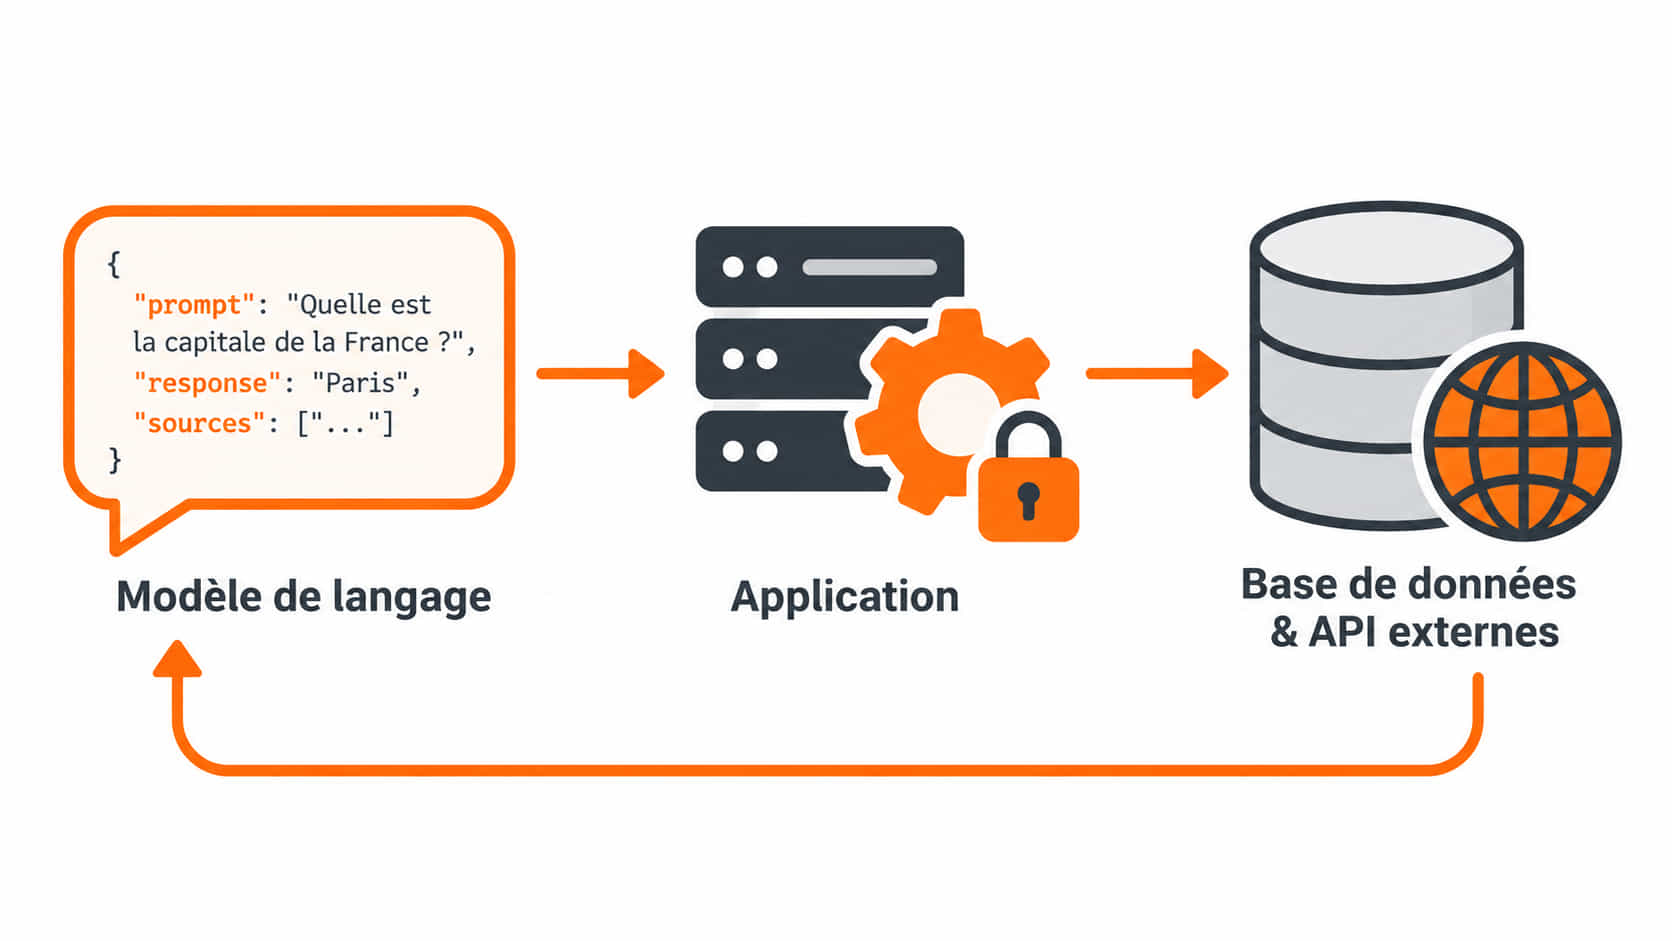
Le point décisif, et le plus mal compris : le modèle n'exécute rien. La documentation du function calling chez OpenAI est explicite, c'est votre application qui exécute le code. Le LLM se contente d'écrire une demande au format JSON (JavaScript Object Notation, un format texte standard pour décrire des données structurées), que votre logiciel lit, exécute, puis lui renvoie.
Cette distinction change tout en pratique. Un LLM branché sur un outil de facturation ne touche jamais votre facturation : il propose un appel, et c'est votre code qui décide de l'exécuter ou pas. Tout l'enjeu de sécurité du function calling se joue dans cette zone de décision.
Horizon GEO • La newsletter
Comprendre les LLM, sans jargon
Chaque semaine, un mécanisme des IA expliqué simplement (contexte, embeddings, raisonnement…) et l’actu des modèles qui compte.
1 e-mail par semaine • Désinscription en 1 clic
Function calling : les cinq étapes d'un appel d'outil
Un cycle de function calling se déroule en cinq étapes, toujours les mêmes, quel que soit le modèle. Voici le cycle tel que le décrivent les documentations d'OpenAI et d'Anthropic.
- 1. Déclaration des outils : votre application envoie au modèle, en même temps que la question, la liste des outils disponibles. Chaque outil porte un nom, une description en langage naturel et un schéma de paramètres au format JSON Schema.
- 2. Décision du modèle : le LLM lit les descriptions et juge s'il a besoin d'un outil. Si oui, il renvoie un bloc d'appel au lieu d'une réponse finale. Sinon, il répond normalement.
- 3. Exécution côté application : votre code reçoit le nom de la fonction et ses arguments, puis l'exécute réellement. C'est ici, et nulle part ailleurs, que l'action a lieu.
- 4. Renvoi du résultat : vous relancez le modèle avec la sortie de l'outil, rattachée à l'appel d'origine par un identifiant (le call_id chez OpenAI).
- 5. Réponse ou nouvel appel : le modèle rédige sa réponse finale, ou demande un nouvel outil. La boucle peut se répéter autant de fois que la tâche l'exige.
Retenez bien l'étape 3. Un LLM ne « se connecte » jamais à votre CRM ni à votre base de données. Il écrit une demande, votre application l'exécute, et c'est votre application qui porte les droits d'accès. C'est cette boucle de function calling, répétée en autonomie, qui transforme un simple chatbot en IA agentique capable d'enchaîner des actions.
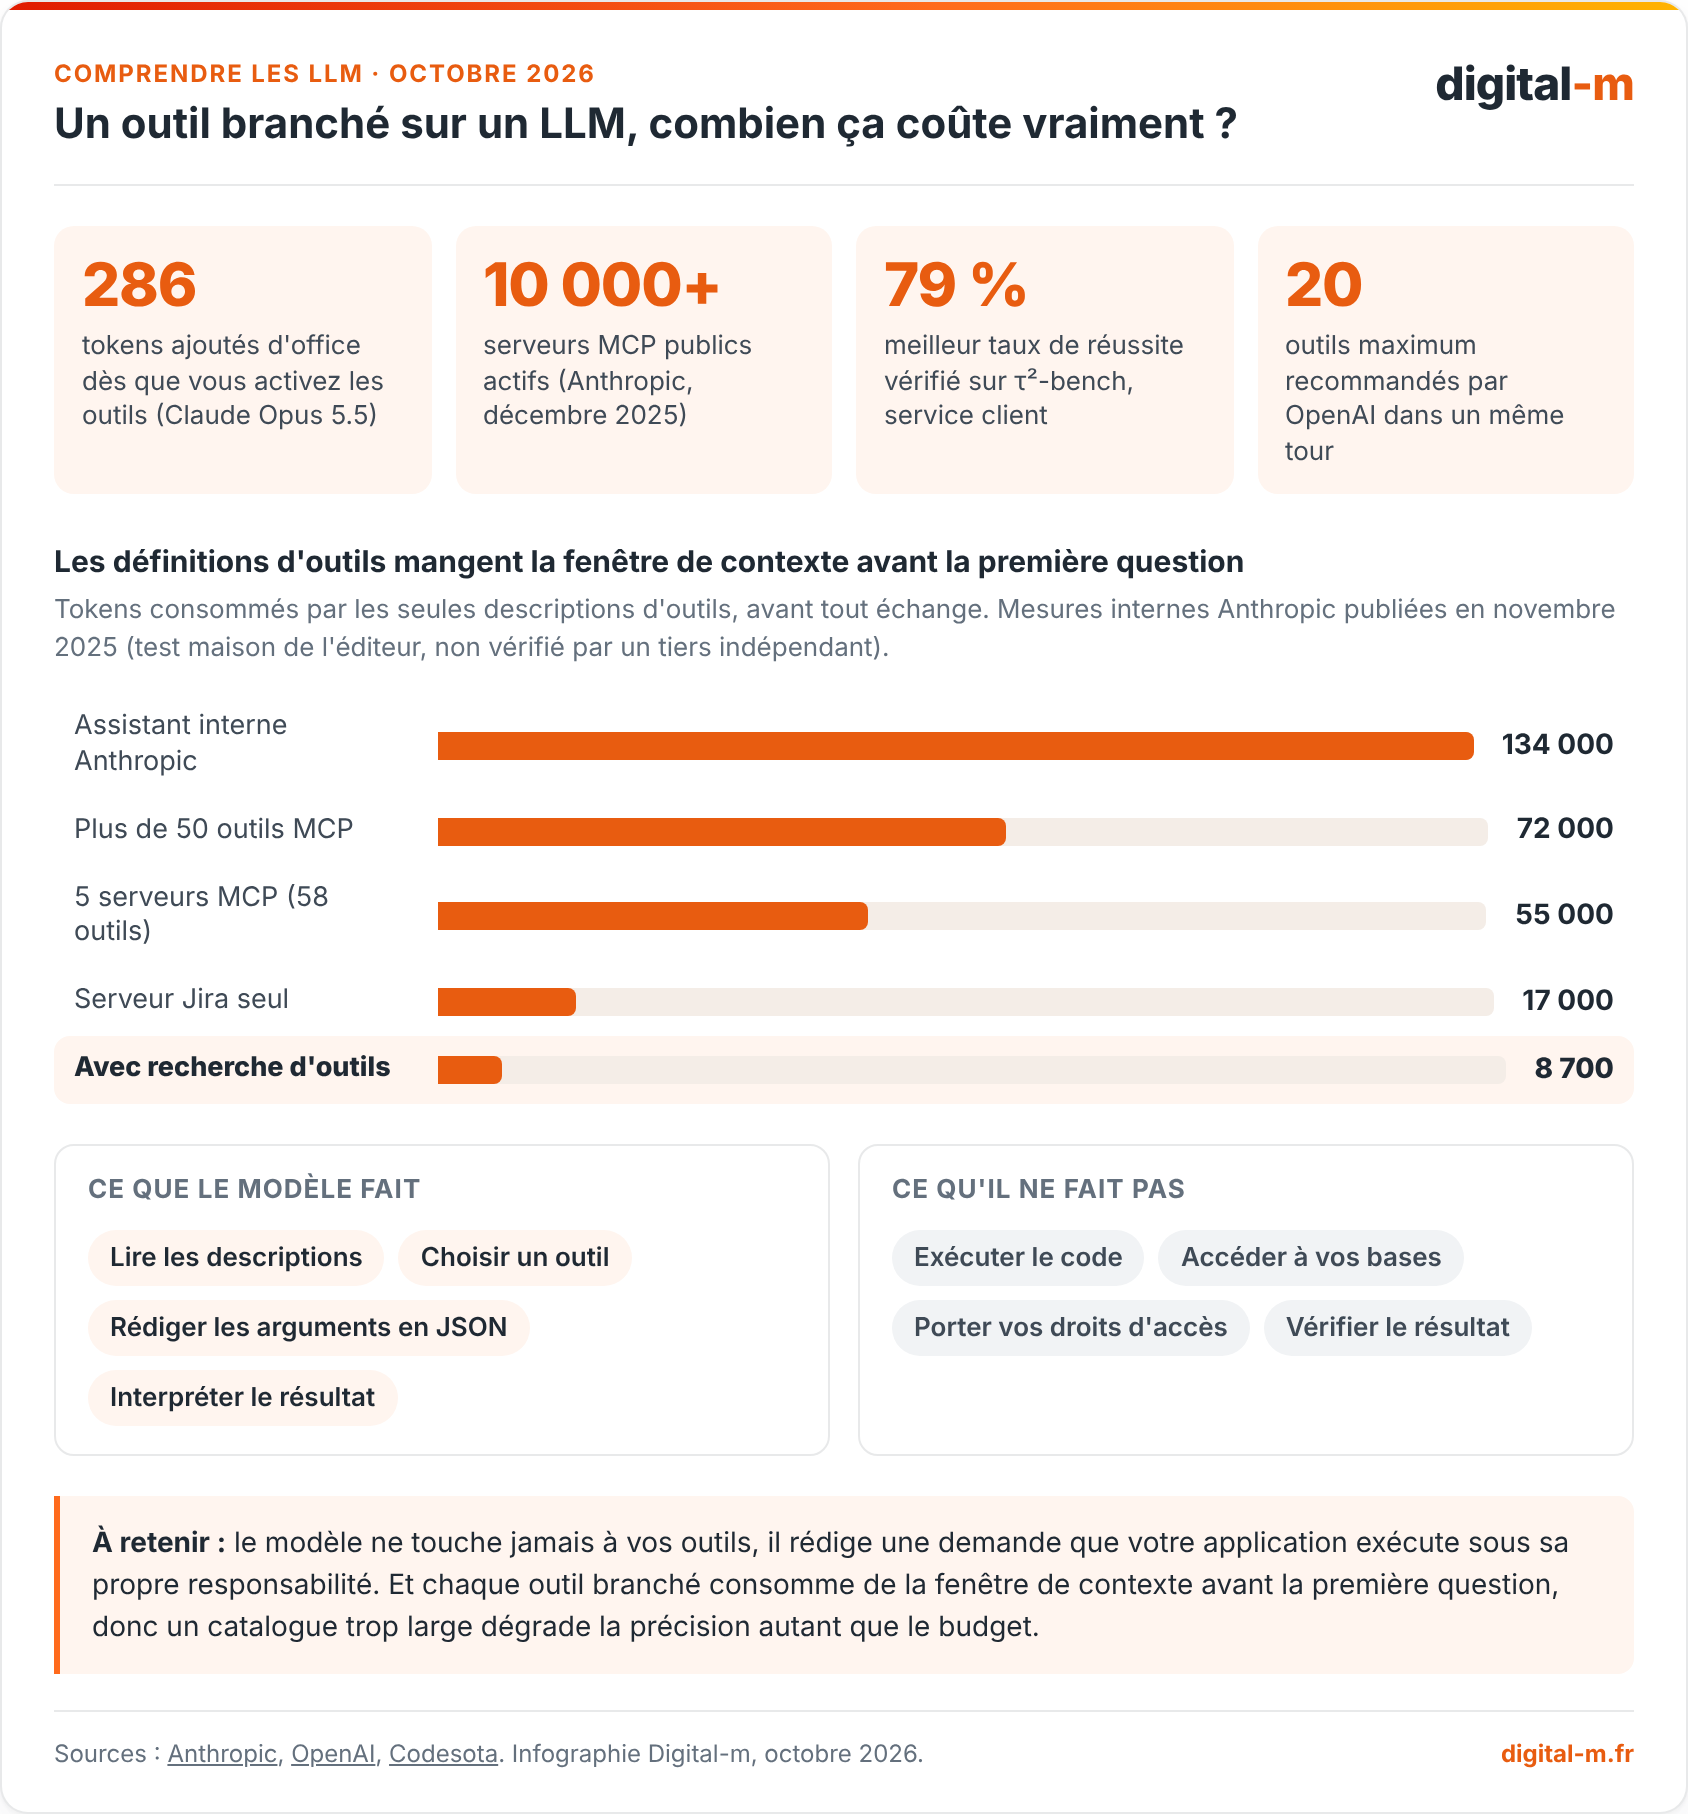
Un outil branché sur un LLM, combien ça coûte vraiment ?

- 286 tokens ajoutés d'office dès que vous activez les outils (Claude Opus 5.5)
- 10 000+ serveurs MCP publics actifs (Anthropic, décembre 2025)
- 79 % meilleur taux de réussite vérifié sur τ²-bench, service client
- 20 outils maximum recommandés par OpenAI dans un même tour
Les définitions d'outils mangent la fenêtre de contexte avant la première question
Tokens consommés par les seules descriptions d'outils, avant tout échange. Mesures internes Anthropic publiées en novembre 2025 (test maison de l'éditeur, non vérifié par un tiers indépendant).
Ce que le modèle fait
Ce qu'il ne fait pas
À retenir : le modèle ne touche jamais à vos outils, il rédige une demande que votre application exécute sous sa propre responsabilité. Et chaque outil branché consomme de la fenêtre de contexte avant la première question, donc un catalogue trop large dégrade la précision autant que le budget.
Télécharger l'infographie (PNG)
Function calling, MCP et agent IA : trois niveaux à ne pas confondre
Ces trois termes désignent trois étages différents de la même pile technique, et les confondre mène à des cahiers des charges incohérents. Le function calling est la capacité du modèle. Le MCP est un protocole de transport. L'agent est l'application qui orchestre les deux.
Le Model Context Protocol (MCP) a été annoncé par Anthropic le 25 novembre 2024, conçu par les ingénieurs David Soria Parra et Justin Spahr-Summers. Son objectif : régler le problème dit « N×M », où chaque outil devait être recâblé pour chaque assistant. Les échanges reposent sur JSON-RPC 2.0, un standard d'appel de procédure à distance antérieur à l'IA.
OpenAI a adopté le MCP en mars 2025, puis l'a étendu aux applications ChatGPT en septembre 2025. En décembre 2025, Anthropic a confié le protocole à l'Agentic AI Foundation, un fonds piloté par la Linux Foundation et cofondé par Anthropic, Block et OpenAI. Le protocole n'appartient donc plus à son créateur, ce qui compte si vous misez dessus sur plusieurs années.
| Niveau | Ce que c'est | Qui le fournit | Exemple |
|---|---|---|---|
| Function calling | Capacité du modèle à demander un outil | L'éditeur du LLM | GPT, Claude, Gemini, Mistral, Grok, Qwen |
| MCP | Protocole standard de branchement d'outils | Agentic AI Foundation | Serveur MCP Google Drive, Slack, Postgres |
| Agent IA | Boucle logicielle qui enchaîne les appels | Votre application | Workspace agents, Claude Code, Copilot |
Les chiffres d'écosystème publiés fin 2025 par Anthropic donnent la mesure de l'adoption : plus de 10 000 serveurs MCP publics actifs et plus de 97 millions de téléchargements mensuels des SDK Python et TypeScript. Le registre officiel comptait 9 652 enregistrements de serveurs en mai 2026 selon un relevé de Digital Applied, soit un écart notable avec l'estimation d'Anthropic : les deux chiffres ne comptent pas la même chose.
Ce que le function calling coûte vraiment en tokens
Activer le function calling coûte des tokens avant la première question. Un token est l'unité de découpage du texte que le modèle facture, environ trois quarts d'un mot en français. Dès que vous transmettez le paramètre tools, l'API Claude ajoute d'office un prompt système : 286 tokens pour Claude Opus 5.5, Sonnet 5.5, Haiku 5.5 et Opus 5, et 406 tokens si vous forcez l'usage d'un outil. Les générations antérieures étaient plus lourdes, jusqu'à 675 tokens pour Opus 4.7.
Ce surcoût fixe est anecdotique face au poids des descriptions elles-mêmes. Les mesures publiées par Anthropic en novembre 2025, réalisées en interne et non vérifiées par un tiers indépendant, sont parlantes : un seul serveur MCP Jira pèse environ 17 000 tokens, cinq serveurs totalisant 58 outils montent à environ 55 000 tokens, et l'assistant interne de l'éditeur atteignait 134 000 tokens de définitions avant optimisation.
Le seuil au-delà duquel le function calling dérape
OpenAI recommande de rester sous 20 fonctions disponibles au début d'un tour, en précisant que le chiffre est indicatif. Anthropic place son seuil d'alerte à 10 outils ou 10 000 tokens de définitions, au-delà desquels il faut basculer sur un chargement à la demande.
Ce chargement différé du function calling, que les deux éditeurs appellent « tool search » (recherche d'outils), fait passer la configuration de plus de 50 outils MCP d'environ 72 000 tokens à environ 8 700 tokens, soit 85 % d'économie annoncée. Plus intéressant encore, la précision mesurée sur les évaluations MCP d'Anthropic grimpe de 49 % à 74 % pour Opus 4, et de 79,5 % à 88,1 % pour Opus 4.5. Moins d'outils visibles à la fois, donc moins d'erreurs de choix. Si le rapport entre volume de contexte et qualité de réponse vous intéresse, notre article sur la façon dont les LLM découpent et facturent le texte détaille le mécanisme.
Pourquoi le function calling échoue encore en production
Parce qu'un appel d'outil réussi ne suffit pas : il faut enchaîner des dizaines d'appels corrects d'affilée, et la probabilité s'effondre. C'est la leçon centrale de τ-bench, le benchmark de function calling publié par Sierra Research en juin 2024, qui place un agent face à un utilisateur simulé, des API métier et un manuel de procédures. Il compte 165 tâches, 115 en commerce de détail et 50 en aérien.
Le piège du pass^k
τ-bench ne mesure pas seulement la réussite au premier essai, il mesure la fiabilité sur k essais indépendants (la métrique pass^k). L'écart est brutal : GPT-4o, qui réussissait environ 60 % des tâches de commerce de détail au premier essai, retombe autour de 25 % quand on exige la réussite sur huit essais consécutifs. Soit près de 35 points perdus. Un agent qui réussit une fois sur deux n'est pas un agent à 50 %, c'est un agent inutilisable en production.
Les scores de réussite vérifiés publiés sur τ²-bench, la suite du benchmark, confirment le plafond du function calling : Claude Opus 4.5 à 79 %, GPT-5.2 à 73 %, Gemini 3 Pro à 69 %, Claude Sonnet 4.5 à 63 %, contre 36 % pour GPT-4o. Ces lignes portent sur les modèles de 2025, derniers résultats signalés comme vérifiés. Aucun modèle ne dépasse les 80 % sur du service client réaliste.
Attention toutefois aux classements que vous lirez ailleurs. Le Berkeley Function Calling Leaderboard (BFCL), référence historique du domaine avec 5 088 éléments notés dans sa version v4, a été audité par Epoch AI le 10 septembre 2026 : sur 50 tâches tirées au hasard, 24 présentaient un défaut susceptible de fausser la notation, soit 48 %. Epoch AI classe donc le benchmark comme défaillant, le seuil d'alerte étant fixé à 20 %. À manier avec prudence, donc, surtout dans un argumentaire commercial.
Function calling : quels modèles s'en sortent le mieux en 2026 ?
Les modèles propriétaires de dernière génération et plusieurs modèles ouverts chinois se tiennent désormais de près sur l'usage d'outils, mais les protocoles d'évaluation diffèrent trop pour désigner un vainqueur net. Voici l'état des classements publics consultés le 13 octobre 2026.
| Modèle | Éditeur | Score publié | Statut du relevé |
|---|---|---|---|
| GLM-5 | Zhipu AI / Z.ai | 89,7 (précision τ²-bench) | Non vérifié |
| Step-3.5-Flash | StepFun | 88,2 (précision τ²-bench) | Non vérifié |
| Qwen3.5-397B-A17B | Alibaba | 86,7 (précision τ²-bench) | Non vérifié |
| Claude Opus 4.5 | Anthropic | 79 (taux de réussite) | Vérifié |
| GPT-5.2 | OpenAI | 73 (taux de réussite) | Vérifié |
| Gemini 3 Pro | Google DeepMind | 69 (taux de réussite) | Vérifié |
Deux précautions avant d'en tirer une décision d'achat. D'abord, les colonnes « précision » et « taux de réussite » ne mesurent pas la même chose et ne se comparent pas entre elles. Ensuite, les scores les plus élevés sont précisément ceux signalés comme non vérifiés par la plateforme qui les publie. Mistral, Grok, Llama et DeepSeek supportent tous le function calling, mais n'apparaissent pas avec un score vérifié sur ces deux classements.
Chez Digital-m, nous auditons régulièrement des configurations d'agents pour des PME, et le facteur décisif est rarement le modèle : c'est le nombre d'outils exposés et la qualité de leurs descriptions. Un catalogue de 40 outils mal décrits fait échouer le meilleur modèle du marché.
Ce que le function calling change pour votre visibilité dans les IA
Le function calling est la raison technique pour laquelle votre site peut être cité par une IA sans avoir jamais figuré dans ses données d'entraînement. Quand ChatGPT, Perplexity ou Gemini répondent à une question d'actualité, ils appellent un outil de recherche web, lisent les pages renvoyées, puis rédigent. Votre contenu est lu au moment de la requête, pas récité de mémoire.
Le function calling déplace donc le terrain du GEO. Il ne s'agit plus seulement d'être dans le corpus d'entraînement, il s'agit d'être récupérable et lisible en quelques secondes par un outil automatisé. Ce mécanisme, appelé grounding (ancrage de la réponse dans des sources récupérées), est la porte d'entrée principale vers les citations IA.
Conséquence concrète : la hiérarchie de vos informations compte plus que jamais. Notre étude sur les citations de ChatGPT montre que 44,2 % des extraits cités proviennent du premier tiers d'un article. Un outil de récupération ne lit pas votre page comme un lecteur patient : il prélève, découpe et retient ce qui est en haut et sans ambiguïté. Notre agence GEO structure les contenus exactement dans cette logique, et notre formation GEO certifiée Qualiopi détaille la méthode pas à pas.
Les risques à connaître avant de brancher un outil sur un LLM
Le risque principal du function calling n'est pas que le modèle se trompe, c'est qu'un outil malveillant lui donne des ordres. L'attaque documentée s'appelle le tool poisoning (empoisonnement d'outil) : décrite par Invariant Labs en avril 2025, elle consiste à cacher des instructions dans la description d'un outil. Le modèle les lit et les applique, l'utilisateur ne les voit jamais. C'est une variante de l'injection de prompt, transposée au niveau du protocole.
Les failles logicielles suivent. En juillet 2025, JFrog a signalé CVE-2025-6514, une vulnérabilité critique notée 9,6 sur l'échelle CVSS dans le paquet mcp-remote : un serveur malveillant pouvait exécuter des commandes arbitraires sur la machine de l'utilisateur. Les versions 0.0.5 à 0.1.15 étaient touchées, le correctif est arrivé en 0.1.16. Une autre faille, CVE-2025-49596, touchait l'outil de développement MCP Inspector d'Anthropic, dont l'absence d'authentification par défaut permettait l'exécution de code.
Les études de surface d'exposition circulent avec des chiffres très dispersés, de 30 % à 82 % de serveurs présentant un problème selon les méthodologies, qui ne sont pas comparables entre elles. Un chiffre reste plus parlant que ces fourchettes : GitGuardian a identifié en 2026 quelque 24 008 secrets dans des fichiers de configuration MCP publics sur GitHub, dont 2 117 encore valides. Et dans un rapport de mai 2026, la NSA estimait que la diffusion rapide du MCP avait devancé la maturation de son modèle de sécurité.
La règle de prudence du function calling est simple : traitez tout serveur d'outils comme du code tiers exécuté chez vous, avec les droits d'accès minimaux et une revue des descriptions. Nous retrouvons régulièrement, lors de nos audits techniques, des clés d'API en clair dans des configurations d'agents installées en quelques minutes et jamais relues depuis.
Ce qu'il faut retenir
Le function calling est le mécanisme par lequel un LLM demande un outil au lieu d'inventer une réponse. Cinq étapes, et une vérité à ne pas perdre de vue : le modèle rédige la demande, votre application l'exécute et en porte la responsabilité.
Les trois points à garder en tête sur le function calling. Le coût d'abord : chaque outil branché consomme la fenêtre de contexte avant la première question, de 286 tokens de surcharge fixe à 134 000 tokens de définitions dans les cas extrêmes mesurés par Anthropic. La fiabilité ensuite : aucun modèle ne dépasse 80 % de réussite vérifiée sur du service client réaliste, et l'écart entre un essai et huit essais atteint 35 points. La sécurité enfin : le MCP s'est répandu plus vite que son modèle de sécurité, de l'aveu même de la NSA en mai 2026.
Pour votre visibilité, la conclusion est opérationnelle. Les IA lisent votre site via un appel d'outil, au moment de la requête, et retiennent surtout le premier tiers de vos pages. Si vous voulez savoir ce que les moteurs génératifs prélèvent réellement de votre contenu, demandez un audit GEO à notre équipe ou formez-vous avec notre programme GEO certifié Qualiopi.
Avez-vous déjà branché un outil ou un serveur MCP sur une IA dans votre entreprise, et qu'est-ce qui a cassé en premier ? Dites-le nous en commentaire !Sources et références
- OpenAI - Function calling, documentation développeurs (consultée en octobre 2026)
- Anthropic - Introducing advanced tool use on the Claude Developer Platform (24 novembre 2025)
- Anthropic - Tool use pricing and tokens, documentation (consultée en octobre 2026)
- Sierra Research - τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains (juin 2024)
- Codesota - τ²-bench leaderboard, taux de réussite vérifiés (consulté le 13 octobre 2026)
- Epoch AI - Berkeley Function Calling Leaderboard (BFCL) v4, revue de benchmark (10 septembre 2026)
- Model Context Protocol - Spécification officielle du protocole (consultée en octobre 2026)
- Wikipedia - Model Context Protocol, chronologie et gouvernance (consultée en octobre 2026)
- Practical DevSecOps - MCP Security Statistics 2026, agrégation d'études tierces (26 juin 2026)
- Digital-m - 44 % des citations de ChatGPT viennent du premier tiers de vos articles
Questions fréquentes sur le function calling
Le function calling et le tool use, est-ce la même chose ?
Oui. « Function calling » est le terme employé par OpenAI, « tool use » celui d'Anthropic, et « appel de fonction » la traduction française. Les trois désignent le même mécanisme : le modèle renvoie un nom de fonction et des arguments au format JSON au lieu d'une réponse en texte.
Un LLM peut-il exécuter du code sur mon serveur avec le function calling ?
Non, pas directement. Le modèle écrit une demande d'appel, c'est votre application qui exécute le code et qui porte les droits d'accès. Le risque réel vient de là : si votre code exécute sans contrôle tout ce que le modèle demande, et qu'une description d'outil a été empoisonnée, l'effet est le même qu'une exécution directe.
Combien d'outils puis-je brancher sur un modèle sans dégrader ses réponses ?
OpenAI recommande de rester sous 20 fonctions dans un même tour, Anthropic place son seuil d'alerte à 10 outils ou 10 000 tokens de définitions. Au-delà, utilisez un chargement à la demande : les mesures internes d'Anthropic montrent une précision qui passe de 79,5 % à 88,1 % pour Opus 4.5 avec cette technique.
Le MCP est-il obligatoire pour faire du function calling ?
Non. Le function calling fonctionne sans MCP, en déclarant simplement vos outils dans l'appel API. Le MCP est un protocole de standardisation qui évite de recâbler chaque outil pour chaque assistant. Il est utile dès que vous branchez plusieurs outils sur plusieurs modèles, inutile pour deux ou trois fonctions maison.
Quel rapport entre le function calling et ma visibilité dans ChatGPT ou Gemini ?
Direct. Quand une IA répond à une question d'actualité, elle appelle un outil de recherche web et lit vos pages au moment de la requête. Votre site n'a pas besoin d'être dans les données d'entraînement, il doit être rapidement récupérable et lisible. D'où l'importance de placer vos informations clés dans le premier tiers de chaque page.