Logs serveur : quels crawlers IA visitent votre site ?
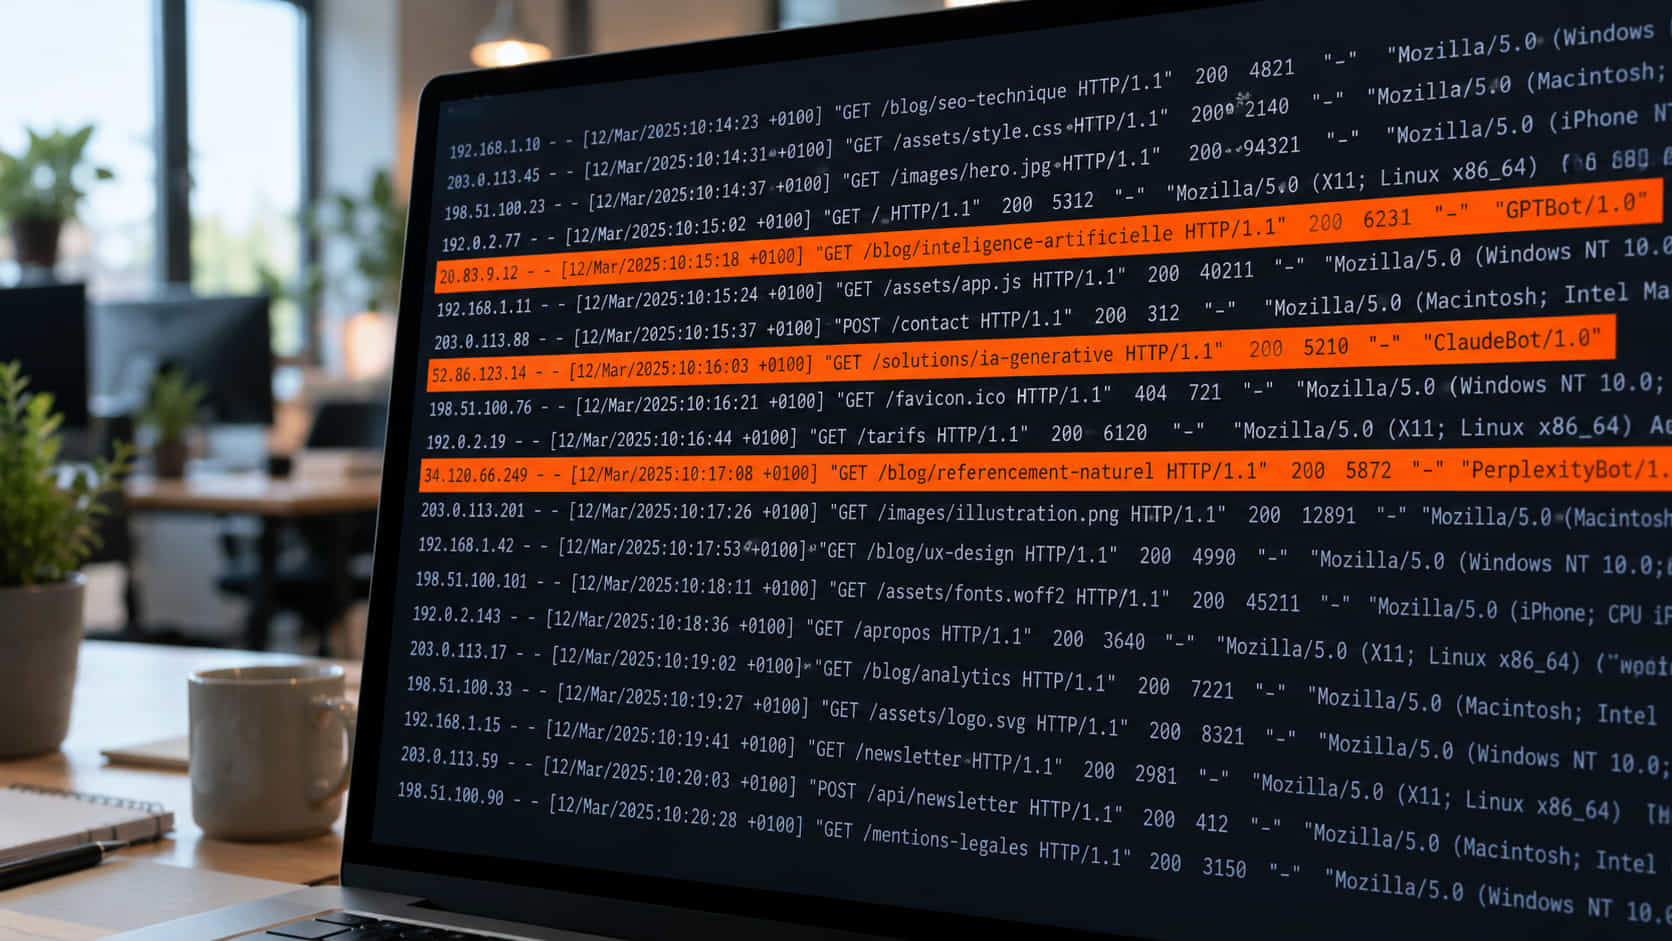
Pendant 48 jours, un site a tenu le journal de ses visiteurs non humains. GPTBot n'est pas apparu pendant des semaines, puis il a lancé 187 requêtes en une seule semaine, dont 152 en trois minutes. Aucune de ces visites n'apparaît dans Google Analytics, aucune dans la Search Console. Les logs serveur sont le seul endroit où l'on voit réellement passer les crawlers IA : GPTBot, ClaudeBot, PerplexityBot, meta-externalagent. Et ils racontent souvent autre chose que ce que l'on imagine. En juillet 2026, 5,7 % des requêtes se présentant comme des crawlers IA étaient usurpées d'après les mesures de DataDome. Voici comment ouvrir vos logs, reconnaître qui passe, vérifier qu'il est bien celui qu'il prétend être, et en tirer des décisions GEO qui tiennent debout.
-
- Dernière modification
27 octobre 2026 - 9 minutes de lecture
Pourquoi vos logs serveur sont le seul endroit où voir les crawlers IA
Un log serveur est le journal brut de votre hébergement : chaque fois qu'une machine demande une page, le serveur écrit une ligne avec l'heure, l'adresse IP, l'URL demandée, le code de réponse et le user-agent (la carte de visite que le visiteur déclare). C'est le seul registre qui enregistre les visites non humaines.
Google Analytics 4 repose sur un script JavaScript exécuté par un navigateur. Or les crawlers IA n'exécutent pas le JavaScript : ils ne déclenchent donc jamais la mesure. Si vous suivez vos chiffres de trafic IA dans GA4, vous observez les internautes arrivés depuis ChatGPT ou Perplexity après avoir cliqué sur un lien, pas les robots qui sont venus lire vos pages. Ce sont deux populations distinctes.
La Search Console, de son côté, ne montre que Googlebot. Elle ignore totalement GPTBot, ClaudeBot ou meta-externalagent. Résultat : sans logs, vous travaillez à l'aveugle sur la moitié amont du GEO, celle de la collecte.
- Ce que seuls les logs révèlent : quel robot est venu, quand, sur quelles URL, avec quel code de réponse.
- Pourquoi c'est devenu critique : en 2026, le trafic des bots et des agents a dépassé pour la première fois 50 % du trafic Internet, selon Cloudflare.
- Le point de départ du GEO technique : une page qui n'apparaît jamais dans vos logs n'a jamais été récupérée, donc elle ne peut pas être citée.
Horizon GEO • La newsletter
Être cité par ChatGPT, Gemini et Perplexity
Chaque semaine, nos analyses GEO, les chiffres qui comptent et les changements des moteurs IA, directement dans votre boîte mail.
1 e-mail par semaine • Désinscription en 1 clic
Quels crawlers IA chercher dans vos logs en 2026 ?
Trois familles de robots IA se croisent dans vos logs, et elles n'ont pas du tout le même intérêt pour vous. Les robots d'entraînement collectent du texte pour fabriquer les modèles. Les robots de recherche alimentent un index qui sert à citer des sources. Les robots déclenchés par l'utilisateur (les « fetchers ») vont lire une page précise parce qu'un internaute vient de poser une question.
Cette distinction commande vos décisions. Bloquer un robot d'entraînement ne vous coûte aucune visibilité. Bloquer un robot de recherche ou un fetcher vous efface des réponses. C'est exactement ce que Cloudflare a entériné le 6 juillet 2026 en découpant ses contrôles en trois catégories : Search, Training et Agent.
| User-agent à chercher | Éditeur | Rôle | Fichier d'IP officiel |
|---|---|---|---|
| GPTBot | OpenAI | Entraînement | openai.com/gptbot.json |
| OAI-SearchBot | OpenAI | Recherche ChatGPT | openai.com/searchbot.json |
| ChatGPT-User | OpenAI | Déclenché par l'utilisateur | openai.com/chatgpt-user.json |
| ClaudeBot | Anthropic | Entraînement | claude.com/crawling/bots.json |
| Claude-SearchBot | Anthropic | Recherche | claude.com/crawling/bots.json |
| Claude-User | Anthropic | Déclenché par l'utilisateur | claude.com/crawling/bots.json |
| PerplexityBot | Perplexity | Recherche (pas d'entraînement) | perplexity.com/perplexitybot.json |
| Perplexity-User | Perplexity | Déclenché par l'utilisateur | perplexity.com/perplexity-user.json |
| meta-externalagent | Meta | Entraînement et indexation | non publié |
| meta-webindexer | Meta | Recherche Meta AI | non publié |
| Googlebot | Recherche, AI Overviews et AI Mode | vérification par DNS inverse |
Le cas Google, qui piège tout le monde
Vous ne trouverez jamais de robot « AI Overviews » dans vos logs. Google Search Central est explicite : Google-Extended ne possède aucune chaîne user-agent propre, c'est uniquement un jeton robots.txt qui règle l'autorisation d'usage pour Gemini et Vertex AI. Les réponses IA de Google s'appuient sur l'index de Search, exploré par Googlebot. Impossible donc d'isoler, dans vos logs, le crawl destiné aux réponses génératives de celui destiné aux résultats classiques.
À l'inverse, Meta documente précisément ses robots : meta-webindexer sert la qualité des résultats de Meta AI, et l'autoriser permet à Meta AI de citer et de lier votre contenu, tandis que meta-externalagent travaille pour l'entraînement. Deux noms très proches, deux conséquences opposées.
Un ordre de grandeur qui surprend
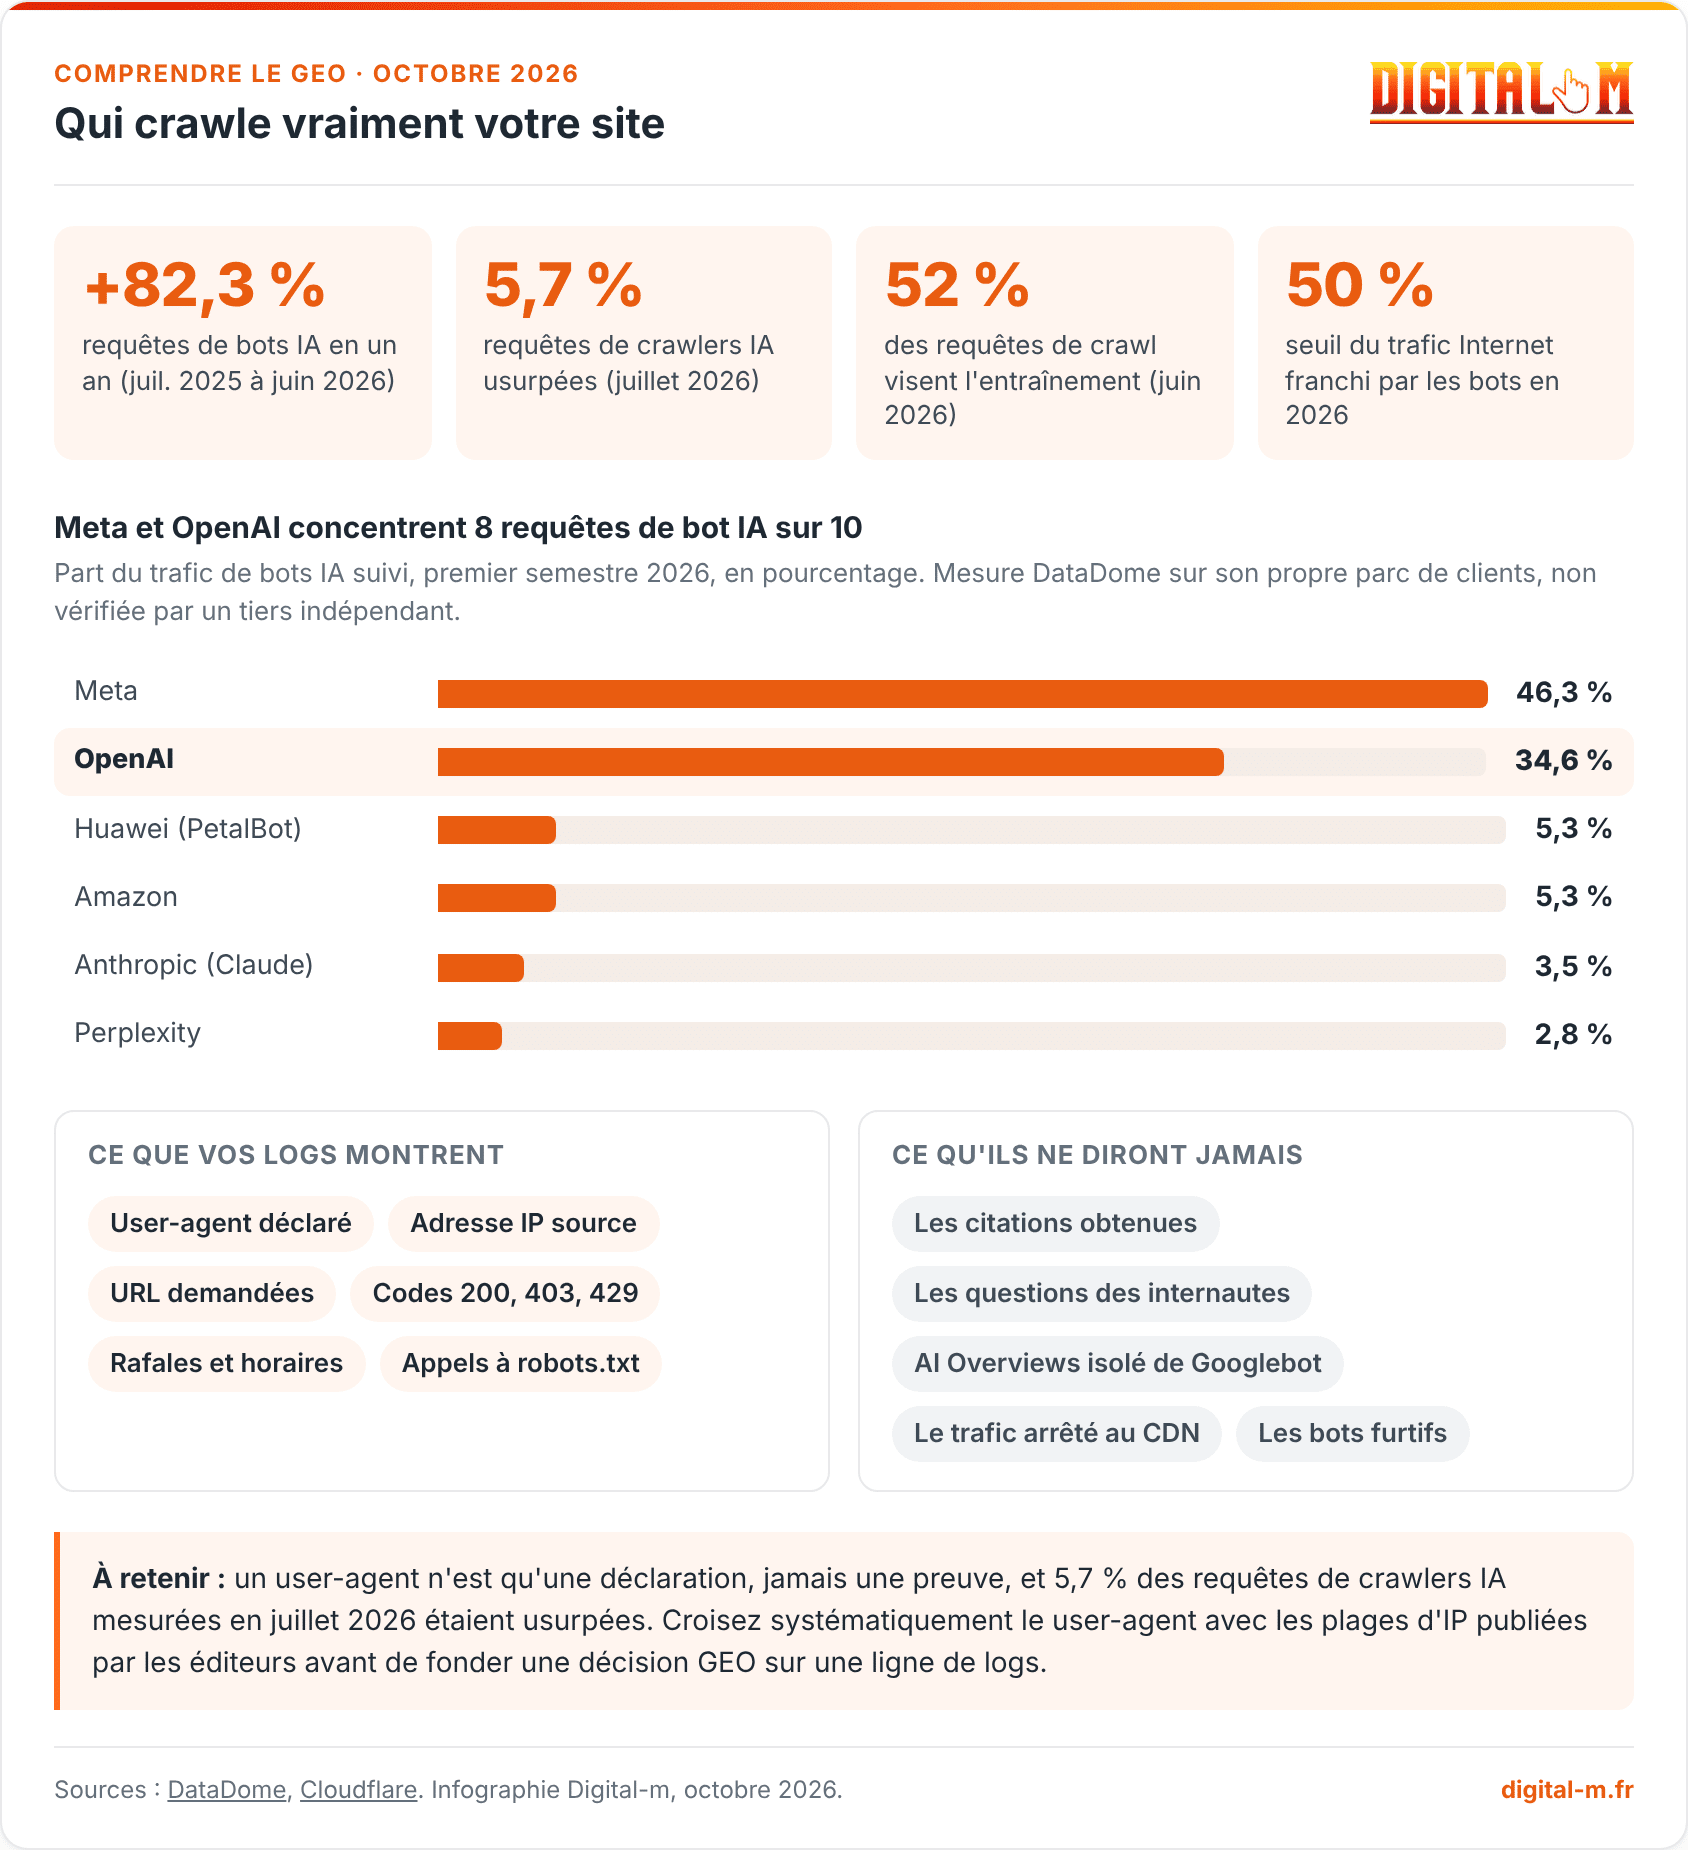
Sur l'ensemble du trafic de bots IA suivi par DataDome au premier semestre 2026, Meta pèse 46,3 % et OpenAI 34,6 %, loin devant Anthropic (3,5 %) et Perplexity (2,8 %). Il s'agit de mesures réalisées par l'éditeur sur son propre parc de clients, non vérifiées par un tiers indépendant, mais l'ordre de grandeur est utile : les robots qui vous consomment le plus ne sont pas forcément ceux qui vous citent le plus.
Qui crawle vraiment votre site

- +82,3 % requêtes de bots IA en un an (juil. 2025 à juin 2026)
- 5,7 % requêtes de crawlers IA usurpées (juillet 2026)
- 52 % des requêtes de crawl visent l'entraînement (juin 2026)
- 50 % seuil du trafic Internet franchi par les bots en 2026
Meta et OpenAI concentrent 8 requêtes de bot IA sur 10
Part du trafic de bots IA suivi, premier semestre 2026, en pourcentage. Mesure DataDome sur son propre parc de clients, non vérifiée par un tiers indépendant.
Ce que vos logs montrent
Ce qu'ils ne diront jamais
À retenir : un user-agent n'est qu'une déclaration, jamais une preuve, et 5,7 % des requêtes de crawlers IA mesurées en juillet 2026 étaient usurpées. Croisez systématiquement le user-agent avec les plages d'IP publiées par les éditeurs avant de fonder une décision GEO sur une ligne de logs.
Télécharger l'infographie (PNG)
Comment lire une ligne de log sans être développeur
Une ligne de log suit presque toujours le même format, dit « combined ». Elle se lit de gauche à droite : adresse IP, date et heure, méthode et URL demandées, code de réponse HTTP, poids de la réponse, page de provenance, puis user-agent entre guillemets.
Prenons un exemple réel de robot OpenAI. Le user-agent déclaré ressemble à ceci : Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot. Trois informations comptent : le nom du robot, son numéro de version, et l'URL de documentation qui permet de vérifier l'éditeur.
- Le code 200 : la page a été servie correctement, le robot a bien reçu votre contenu.
- Le code 304 : la page n'a pas changé depuis la dernière visite, ce qui est plutôt bon signe.
- Les codes 403 et 429 : vous bloquez ou limitez ce robot, parfois sans le savoir, via un pare-feu applicatif ou un plugin de sécurité.
- Le code 404 : le robot suit des URL mortes, souvent issues d'anciennes pages ou d'un sitemap obsolète.
Une commande suffit pour un premier comptage sur un serveur Linux : grep -Ei "GPTBot|ClaudeBot|PerplexityBot|meta-externalagent" access.log. Vous obtenez immédiatement la liste des visites concernées. Chez Digital-m, nous commençons presque tous nos audits GEO techniques par ce grep, et la surprise la plus fréquente n'est pas l'absence de robots : c'est un code 403 massif sur un robot de recherche que le client croyait autoriser.
Un user-agent n'est pas une preuve : vérifiez l'IP
N'importe qui peut écrire « GPTBot » dans son user-agent. La chaîne est déclarative, librement modifiable, et elle est effectivement usurpée à grande échelle. DataDome mesure une hausse de 45 % de l'usurpation d'agents entre février et juillet 2026, la catégorie « crawlers et indexeurs » passant de 3,2 % à 5,7 % de requêtes falsifiées.
HUMAN Security, de son côté, a analysé deux semaines de trafic associé à 16 crawlers IA connus et trouvé 5,7 % de requêtes usurpées, soit environ 1 fausse requête pour 17 légitimes. Le robot le plus imité est ChatGPT-User, avec un ratio de 1 pour 5. Là encore, il s'agit d'une mesure réalisée par un éditeur de sécurité sur son propre parc, non auditée par un tiers.
La méthode de vérification est pourtant simple et gratuite. Chaque éditeur publie un fichier JSON listant ses plages d'adresses IP. Vous récupérez l'IP de la ligne de log, vous vérifiez qu'elle appartient bien à la plage publiée, et seulement alors vous comptez la visite. Perplexity recommande explicitement cette combinaison user-agent plus IP pour les règles de pare-feu.
- Étape 1 : isolez les lignes dont le user-agent contient le nom du robot.
- Étape 2 : extrayez les adresses IP correspondantes.
- Étape 3 : téléchargez le fichier JSON officiel de l'éditeur, par exemple openai.com/gptbot.json.
- Étape 4 : comparez chaque IP aux plages déclarées, puis écartez les requêtes non concordantes.
- Étape 5 : pour Googlebot et Bingbot, utilisez la vérification par DNS inverse documentée par les moteurs.
Un chiffre doit vous inciter à la prudence avant toute conclusion : dans un échantillon personnel partagé par le consultant Duane Forrester, environ 87 % des requêtes se réclamant de Googlebot ne venaient pas de Google. Échantillon unique, méthodologie propre, mais le message tient : sans vérification d'IP, un rapport de logs peut être faux de bout en bout.
Les six indicateurs à sortir de vos logs
Un audit de logs utile en GEO tient en six mesures, pas plus. L'objectif n'est pas de produire un tableau de bord mais de répondre à une question : mes pages stratégiques sont-elles réellement récupérées par les robots qui peuvent me citer ?
- Fréquence par robot : les crawlers IA travaillent par rafales. Lisez un motif sur plusieurs semaines, pas un total mensuel. L'étude de logs CDN citée par Ahrefs sur 48 jours montre GPTBot absent pendant des semaines, puis 187 requêtes en une semaine dont 152 en trois minutes, avec un pic à 114 requêtes par minute.
- Pages atteintes : triez par nombre de requêtes et cherchez surtout les absences. Une page de service jamais visitée est une page invisible pour les moteurs génératifs.
- Codes de statut par robot : un taux élevé de 403 ou 429 sur un robot de recherche signe un blocage involontaire.
- Appels à robots.txt : vérifiez qui consulte votre fichier avant de crawler. Dans l'étude citée plus haut, ni GPTBot ni Meta-WebIndexer ne l'ont fait, et aucune requête vers llms.txt n'a été enregistrée.
- HTML contre ressources : comparez les requêtes de pages aux requêtes d'images, de CSS et de JavaScript. Sur l'échantillon étudié, ChatGPT-User ne récupérait que le HTML, ce qui confirme l'importance d'un contenu présent dans le code source.
- Couverture des pages prioritaires : listez vos 20 URL les plus importantes et cochez celles qui apparaissent dans les logs sur 30 jours. C'est le seul indicateur qui parle à un dirigeant.
Ce travail complète utilement une analyse de pages réellement citées par l'IA : les logs vous disent ce qui a été lu, l'analyse de citations vous dit ce qui a été retenu. Les deux ensemble dessinent votre entonnoir GEO.
Où récupérer vos logs et avec quels outils
Vos logs existent déjà, vous n'avez rien à installer pour les obtenir. Sur un hébergement mutualisé, ils se téléchargent depuis le panneau d'administration : rubrique « Raw Access Logs » sous cPanel, espace de logs dédié chez les hébergeurs français, accès direct au fichier access.log sur un serveur dédié ou un VPS. Attention toutefois à la rétention, souvent limitée à quelques jours ou semaines.
Du plus simple au plus complet
- grep ou PowerShell : gratuit, immédiat, parfait pour un comptage ponctuel et pour répondre à la question « est-ce que GPTBot est passé ce mois-ci ? ».
- Screaming Frog Log File Analyser : interface visuelle, préréglages pour les bots IA et vérification à l'import. Le format le plus adapté à une PME.
- Cloudflare AI Crawl Control : si votre site passe par Cloudflare, vous voyez les robots IA directement dans le tableau de bord, avec le découpage Search, Training et Agent introduit en juillet 2026.
- BigQuery alimenté par Logpush : pour conserver plusieurs mois d'historique et faire du SQL, utile sur les gros sites e-commerce.
- ELK ou Splunk : ingestion continue et alertes, réservé aux structures qui ont une équipe technique dédiée.
Une précaution de calendrier : programmez une extraction mensuelle automatique avant d'en avoir besoin. Un audit demandé en novembre sur des données de juillet se heurte souvent à des logs déjà effacés. Nous mettons systématiquement en place cette extraction chez les clients que nous accompagnons en GEO, parce que l'historique est la seule chose qu'on ne peut pas rattraper après coup.
Les cinq pièges qui faussent votre lecture
Un rapport de logs mal lu produit des décisions coûteuses, comme bloquer un robot qui vous apportait des citations. Voici les erreurs que nous rencontrons le plus souvent sur le terrain.
- Confondre crawl et citation : aucune donnée publique n'établit qu'un crawl plus intense produit plus de citations. La récupération est nécessaire, elle n'est pas suffisante.
- Oublier le CDN : si une requête est servie par le cache ou bloquée en périphérie, elle n'atteint jamais le serveur d'origine et n'apparaît pas dans ses logs. Vos logs montrent ce qui est arrivé, pas ce qui a été tenté.
- Ignorer les bots furtifs : après un blocage, certains robots reviennent avec un user-agent de navigateur générique. Ils gonflent alors vos sessions « humaines » et polluent votre segmentation.
- Traiter robots.txt comme un mur : c'est un protocole volontaire. Plusieurs fetchers déclenchés par un utilisateur, dont ChatGPT-User, Perplexity-User et meta-externalfetcher, ne s'y conforment pas nécessairement. Pour mémoire, notre guide sur le fichier robots.txt et les crawlers IA détaille ce point.
- Mélanger les méthodologies : les taux d'usurpation publiés par les éditeurs de sécurité reposent sur des parcs et des définitions différents. Comparer 5,7 % et 87 % comme s'il s'agissait de la même mesure n'a aucun sens.
Le lien avec vos autres chantiers techniques
Les logs ne se lisent pas isolément. Si vos pages dépendent du JavaScript pour afficher leur contenu, un code 200 dans les logs ne garantit rien : le robot a reçu une coquille vide, comme l'explique notre article sur les crawlers IA face au JavaScript. Et si Googlebot consomme votre budget de crawl sur des URL à paramètres, les pages utiles passent après.
Ce qu'il faut retenir
Les logs serveur sont la seule source qui enregistre le passage des crawlers IA sur votre site, parce que ni Google Analytics ni la Search Console ne les voient. Commencez par identifier les trois familles de robots (entraînement, recherche, déclenchés par l'utilisateur), car seules les deux dernières influencent vos citations.
Vérifiez ensuite chaque visite en croisant le user-agent avec les plages d'IP publiées par OpenAI, Anthropic, Perplexity et Google : 5,7 % des requêtes de crawlers IA étaient usurpées en juillet 2026. Sortez enfin six indicateurs seulement, dont le plus parlant reste la couverture de vos 20 pages prioritaires sur 30 jours.
Et gardez en tête la limite de l'exercice : être crawlé ne veut pas dire être cité. Les logs vous disent si la porte est ouverte, pas si l'on parle de vous. Pour aller plus loin, l'équipe Digital-m réalise des audits de logs orientés GEO pour les PME, artisans et commerçants partout en France, et notre formation GEO certifiée Qualiopi consacre un module entier à cette lecture. Contactez-nous pour savoir qui crawle réellement votre site ce mois-ci.
Avez-vous déjà ouvert vos logs serveur pour y chercher GPTBot ou ClaudeBot, et qu'y avez-vous trouvé ? Dites-le nous en commentaire !Sources et références
- OpenAI - Overview of OpenAI crawlers (GPTBot, OAI-SearchBot, ChatGPT-User), consulté le 27 octobre 2026
- Anthropic - Does Anthropic crawl content from the web (ClaudeBot, Claude-User, Claude-SearchBot), consulté le 27 octobre 2026
- Perplexity - PerplexityBot et Perplexity-User, documentation développeurs, consulté le 27 octobre 2026
- Meta - Web Crawlers (meta-externalagent, meta-webindexer, meta-externalfetcher), consulté le 27 octobre 2026
- Google Search Central - Google common crawlers, dont Google-Extended, consulté le 27 octobre 2026
- Cloudflare - Content Independence Day, one year on, 1er juillet 2026
- The Decoder - Cloudflare replaces its blanket AI bot block with granular controls, 6 juillet 2026
- DataDome - Bot and Agent Security Report, AI traffic trends, mise à jour du 22 septembre 2026
- HUMAN Security - AI Crawler Spoofing: attackers impersonate ChatGPT, Mistral and Perplexity, 9 septembre 2025
- Patrick Stox (Ahrefs) - AI Crawler Log Analysis, consulté le 27 octobre 2026
- Digital-m - 44 % des citations de ChatGPT viennent du premier tiers de vos articles
Questions fréquentes sur les logs serveur et les crawlers IA
Comment savoir si GPTBot est passé sur mon site ?
Téléchargez le fichier access.log depuis votre panneau d'hébergement, puis cherchez la chaîne « GPTBot » dans le champ user-agent. Sur un serveur Linux, la commande grep -i "GPTBot" access.log suffit. Vérifiez ensuite que l'adresse IP de chaque ligne figure bien dans le fichier openai.com/gptbot.json, sans quoi la visite peut être usurpée.
Pourquoi les crawlers IA n'apparaissent-ils pas dans Google Analytics ?
Google Analytics 4 mesure les visites grâce à un script JavaScript exécuté par le navigateur. Les crawlers IA n'exécutent pas le JavaScript, donc le script ne se déclenche jamais. GA4 ne peut montrer que les internautes arrivés depuis une réponse IA après avoir cliqué sur un lien, pas les robots eux-mêmes.
Faut-il bloquer les crawlers IA dans son robots.txt ?
Cela dépend de la famille du robot. Bloquer un robot d'entraînement comme GPTBot, ClaudeBot ou meta-externalagent ne coûte aucune visibilité dans les réponses IA. Bloquer un robot de recherche comme OAI-SearchBot, Claude-SearchBot, PerplexityBot ou meta-webindexer vous retire en revanche des citations. Pour une PME qui cherche de la visibilité, le second blocage est contre-productif.
Peut-on voir le crawl des AI Overviews de Google dans ses logs ?
Non, pas séparément. Google Search Central précise que Google-Extended n'a aucune chaîne user-agent propre : c'est un simple jeton robots.txt qui règle l'usage des contenus par Gemini et Vertex AI. Les réponses génératives de Google s'appuient sur l'index de Search exploré par Googlebot, impossible donc d'isoler ce crawl dans vos logs.
Combien de temps faut-il conserver ses logs pour un audit GEO ?
Visez au minimum 90 jours, idéalement 12 mois. Les crawlers IA travaillent par rafales très espacées : une étude sur 48 jours de logs a montré GPTBot absent pendant des semaines avant un pic de 152 requêtes en trois minutes. Avec sept jours de rétention, vous ne verriez rien. Programmez une extraction mensuelle automatique vers un stockage externe.