SEO des PDF : Google lit-il vraiment vos fichiers ?
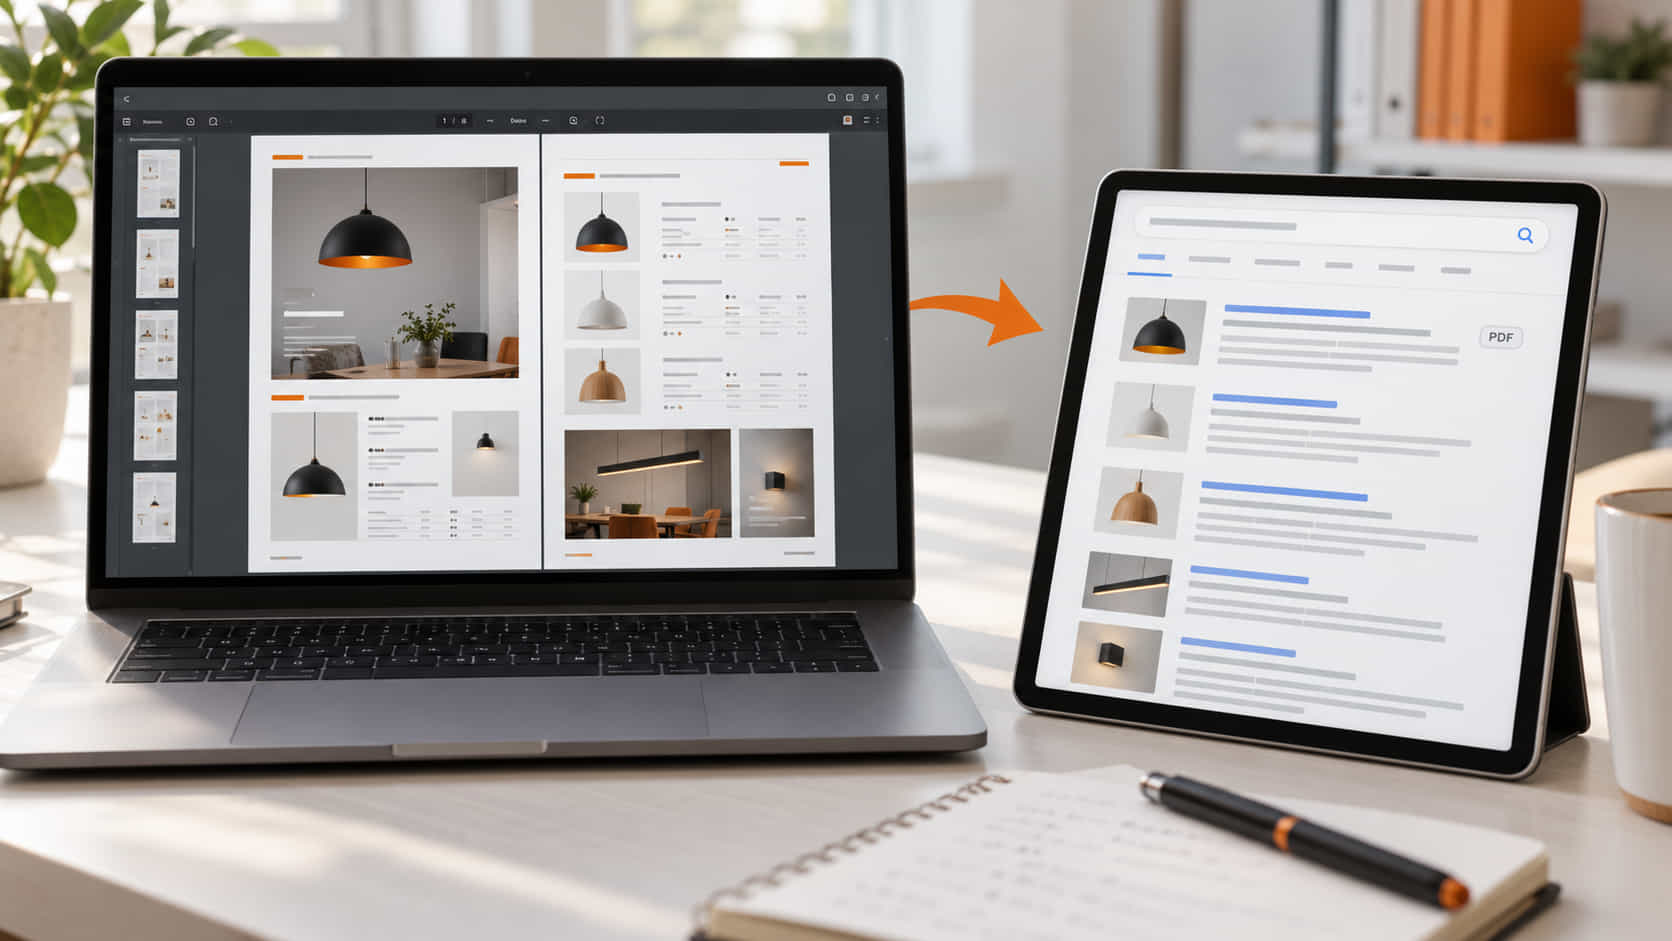
Un fichier PDF n'a ni meta description, ni fil d'Ariane, ni bouton de partage. Il se classe pourtant dans Google comme n'importe quelle page web. Le 14 octobre 2026, Martin Splitt et John Mueller ont détaillé le mécanisme dans le podcast Search Off The Record de Google : avant l'indexation, un convertisseur transforme chaque PDF en HTML. Le reste de la chaîne ne voit plus un PDF, il voit une page. Cette seule phrase explique pourquoi vos catalogues scannés restent invisibles, pourquoi vos plaquettes commerciales captent parfois des requêtes à la place de vos pages de service, et pourquoi un PDF peut très bien finir cité dans un Aperçu IA. Voici ce que Google lit réellement dans un PDF, ce qu'il laisse de côté, et les deux leviers documentés pour reprendre la main.
-
- Dernière modification
23 octobre 2026 - 9 minutes de lecture
Google lit-il vraiment vos PDF ? La réponse en trois phrases
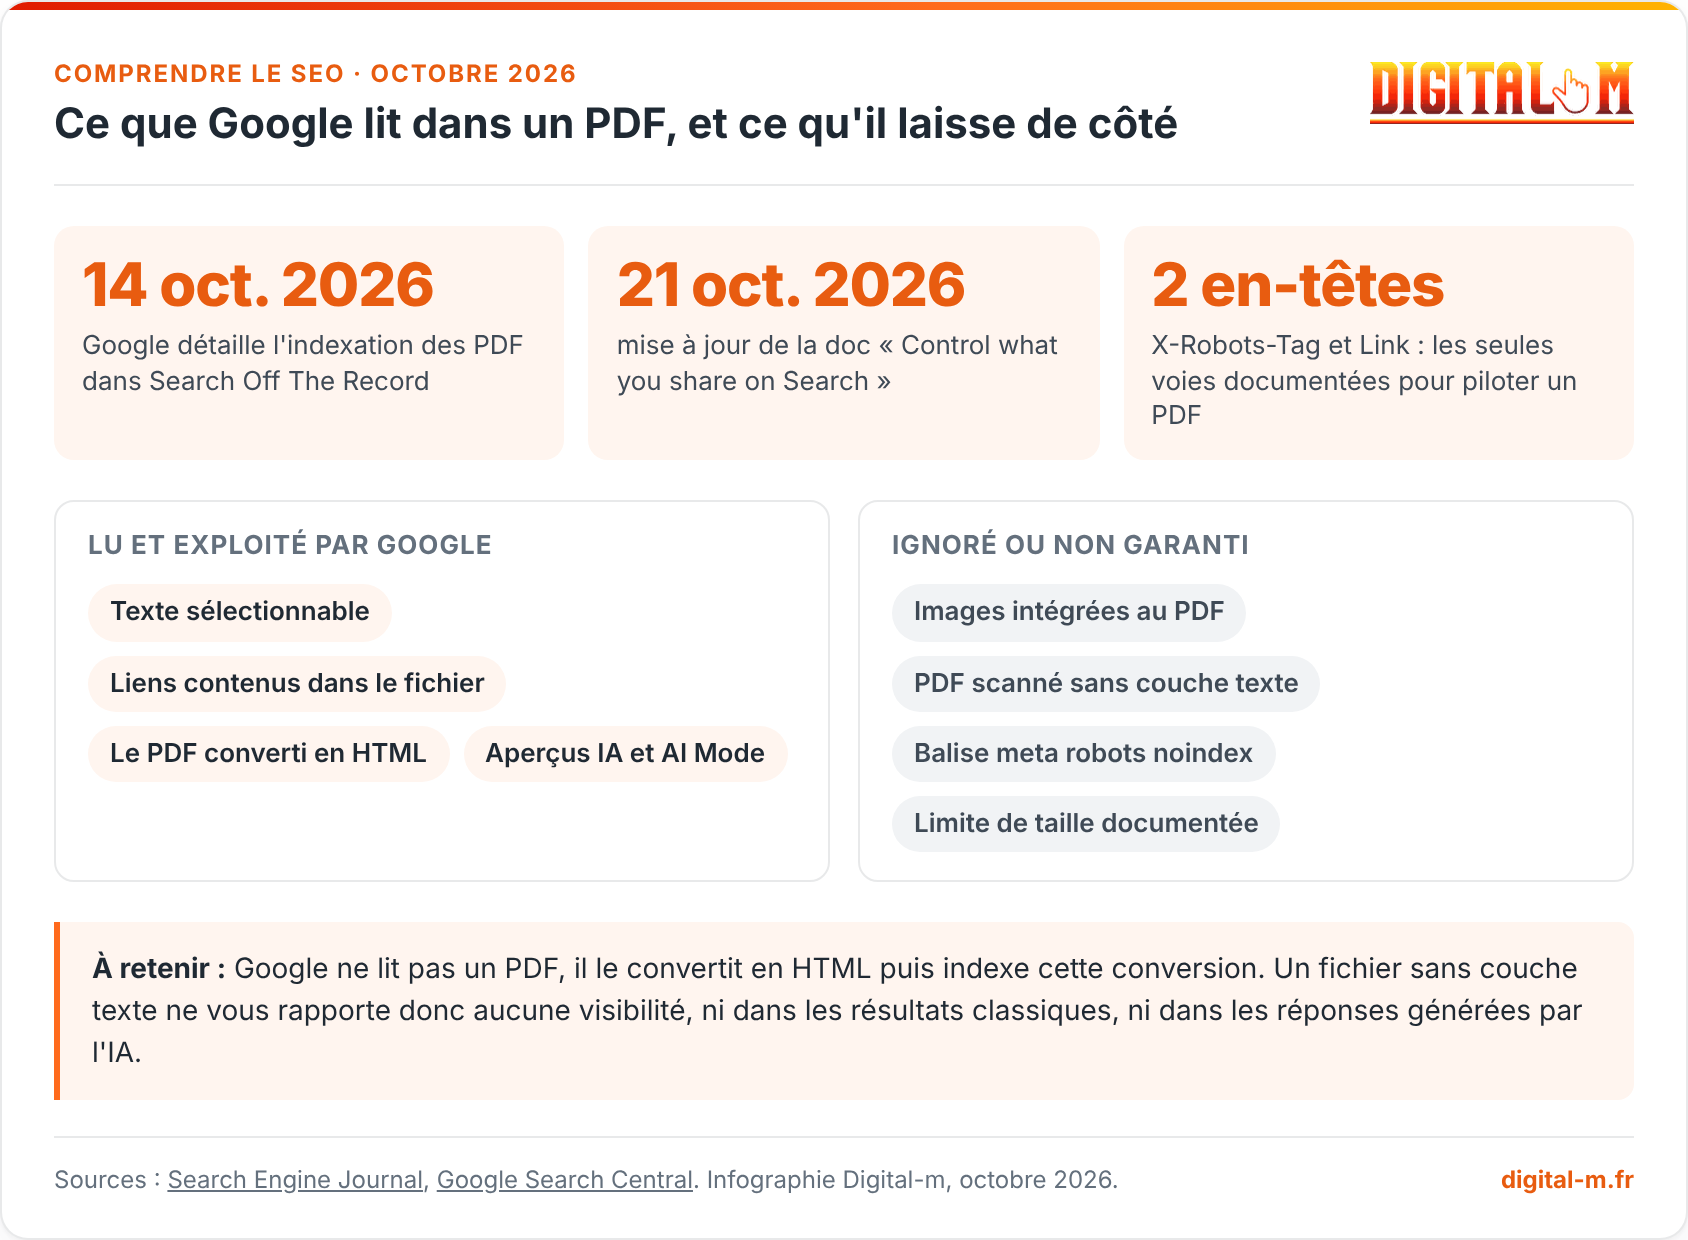
Oui, Google explore, indexe et classe les fichiers PDF, à une condition : que leur texte soit réellement sélectionnable. Le SEO des PDF repose sur un mécanisme simple, confirmé par Google le 14 octobre 2026 : un composant appelé converter (convertisseur) transforme le PDF en HTML juste après le rendu et juste avant l'indexation. Martin Splitt, développeur relations chez Google, le résume d'une formule : « we are not using a PDF viewer », autrement dit Google n'ouvre jamais votre fichier dans une visionneuse.
Conséquence directe pour votre site : un PDF bien construit se comporte comme une page. John Mueller, analyste senior chez Google, précise que du point de vue du référencement, « if it's indexable text, then we can use it for search ». Le classement, lui, suit les mêmes règles : « indexing and ranking is pretty much the same as any other document », dit Splitt.
- Ce qui change tout : la couche texte. Un PDF né d'un export Word, InDesign ou Canva en contient une. Un PDF issu d'un scanner n'en a pas, sauf si une reconnaissance optique de caractères a été appliquée.
- Le test en dix secondes : ouvrez le fichier, sélectionnez un paragraphe à la souris, copiez-le dans un éditeur de texte. Si le texte apparaît, Google peut le convertir. S'il ne se passe rien, votre PDF est une image.
- Ce qui ne change pas : la qualité du contenu, les liens entrants et la pertinence restent les facteurs décisifs, exactement comme pour une page que Google refuse d'indexer.
Horizon GEO • La newsletter
Le SEO bouge, l’IA aussi
Mises à jour Google, AI Overviews, nouvelles pratiques GEO : chaque semaine, l’essentiel pour garder votre visibilité.
1 e-mail par semaine • Désinscription en 1 clic
Comment Google convertit un PDF avant de l'indexer
Le pipeline d'indexation de Google ne manipule que du HTML. Le PDF est donc transformé en amont, puis jeté : seule sa version convertie entre dans l'index. Cette architecture explique la plupart des comportements que les référenceurs observent sans savoir les nommer.
Premier effet : les liens contenus dans un PDF sont lus et suivis. Splitt le dit explicitement, Google peut voir « things like links, for instance, from PDFs ». Un livre blanc téléchargé et republié par un partenaire transmet donc des signaux, ce qui en fait un actif de netlinking rarement exploité par les PME.
Deuxième effet : les images placées dans le PDF sortent du circuit. Interrogé sur le sujet, Splitt penche pour l'hypothèse qu'elles ne sont pas indexées, tout en reconnaissant que cela pourrait évoluer. Si votre infographie la plus forte ne vit que dans un PDF, elle n'existe pas pour Google Images, contrairement à un visuel posé sur une page et correctement traité en SEO des images.
Troisième effet : la limite de taille. Google ne documente aucun seuil officiel pour les PDF. Splitt suppose qu'il est plus élevé que pour une page web, « the same as we do for videos and images », avant qu'une limite de page HTML ne s'applique à la représentation convertie. Traduction prudente : un catalogue de 300 pages n'a aucune garantie d'être indexé en entier.
Ce que Google lit dans un PDF, et ce qu'il laisse de côté

- 14 oct. 2026 Google détaille l'indexation des PDF dans Search Off The Record
- 21 oct. 2026 mise à jour de la doc « Control what you share on Search »
- 2 en-têtes X-Robots-Tag et Link : les seules voies documentées pour piloter un PDF
Lu et exploité par Google
Ignoré ou non garanti
À retenir : Google ne lit pas un PDF, il le convertit en HTML puis indexe cette conversion. Un fichier sans couche texte ne vous rapporte donc aucune visibilité, ni dans les résultats classiques, ni dans les réponses générées par l'IA.
Télécharger l'infographie (PNG)
Vos PDF peuvent-ils être cités par ChatGPT, Gemini ou Perplexity ?
Pour Google, la réponse est documentée et positive. John Mueller l'affirme au sujet des PDF indexés : « so they can also appear in AI overviews, AI mode, all of those things ». Un PDF correctement converti est donc un candidat légitime à la citation dans les Aperçus IA et dans le Mode IA de Google, au même titre qu'une page.
Pour ChatGPT, Perplexity, Mistral, Claude ou Grok, aucun éditeur ne publie à ce jour de règle documentée sur le traitement des PDF dans son index de recherche. Cette information n'est pas confirmée et nous ne la présenterons pas comme telle. Ce que l'on sait en revanche, c'est que ces moteurs travaillent sur du texte brut découpé en passages, une mécanique que nous avons détaillée dans notre article sur le chunking. Un PDF à la mise en page éclatée en trois colonnes, avec des encadrés et des légendes, produit un texte converti désordonné, donc des passages difficiles à citer.
Chez Digital-m, nous auditons régulièrement des sites de PME dont la plaquette commerciale en PDF se positionne mieux que la page de service correspondante. Le symptôme est toujours le même : la page HTML est pauvre, le PDF est riche. Le réflexe n'est pas de supprimer le fichier, mais de rapatrier son contenu dans une vraie page, puis de décider du sort du PDF.
Les 7 erreurs qui rendent un PDF invisible
La majorité des PDF invisibles le sont pour des raisons triviales, pas pour un problème d'algorithme. Voici les sept cas que nous rencontrons le plus souvent en audit, dans l'ordre de fréquence.
- Le PDF scanné : une suite d'images sans couche texte. Splitt est net, « not all PDFs can rank for the text because some PDFs are like images ». Repassez le document dans un outil de reconnaissance optique de caractères avant publication.
- Le nom de fichier illisible : catalogue_v3_FINAL_OK.pdf ne dit rien. Google a d'ailleurs mis à jour sa documentation sur la structure des URL le 21 octobre 2026 pour rappeler qu'il recommande les tirets plutôt que les traits de soulignement, sujet que nous avons traité dans notre guide sur la structure des URL.
- Le fichier orphelin : un PDF qu'aucune page n'appelle en lien. Sans lien interne, Google n'a aucune raison de le trouver ni de le juger important.
- Le poids excessif : un fichier de 80 Mo rempli de visuels non compressés. Aucun seuil officiel n'existe, mais le risque d'indexation partielle augmente avec la taille.
- La cannibalisation : le PDF et la page HTML visent la même requête. Le mécanisme est identique à celui que nous décrivons dans notre article sur le contenu dupliqué et la balise canonical.
- Les visuels enfermés : graphiques, tableaux et schémas qui n'existent que dans le PDF, donc invisibles pour Google Images.
- Le blocage involontaire : un répertoire /documents/ ou /telechargements/ exclu dans le fichier robots.txt, souvent par héritage d'une ancienne configuration.
Le cas particulier des menus et des tarifs
Restaurants, artisans et professions libérales publient massivement menus, grilles tarifaires et notices en PDF. John Mueller exprime une préférence claire pour les pages classiques dans ce cas : « I kind of like normal web pages because it's easier to interact with them ». L'argument n'est pas technique mais pratique : sur mobile, un PDF se zoome mal, ne se lit pas à voix haute correctement et ne se met pas à jour en deux clics. Pour une carte de restaurant ou une grille de prix, la page HTML gagne presque toujours.
PDF ou page HTML : le tableau de décision
Le bon réflexe n'est ni de bannir le PDF, ni de l'utiliser par défaut. Il s'agit de choisir le format selon l'intention derrière le document. Ce tableau résume la logique que nous appliquons sur les projets de création et de refonte de sites.
| Type de document | Format recommandé | Pourquoi |
|---|---|---|
| Menu, tarifs, horaires | Page HTML | Mise à jour fréquente, lecture mobile, données structurées possibles |
| Fiche technique produit | Page HTML + PDF | La page capte la recherche, le PDF sert l'usage atelier et l'impression |
| Livre blanc, étude | PDF derrière une page de présentation | Le PDF porte l'autorité et les liens, la page capte la requête |
| Notice de montage | Format d'impression attendu par l'utilisateur | |
| Conditions générales | Page HTML | Accessibilité, archivage, référencement de marque |
| Catalogue de plus de 50 pages | Pages HTML par gamme + PDF global | Le PDF seul risque une indexation partielle |
Noindex, canonical, robots.txt : contrôler l'indexation d'un PDF
Un PDF ne peut pas porter de balise meta robots, puisqu'il n'a pas de section head. Google documente donc deux en-têtes HTTP pour piloter son sort, et ce sont les seules méthodes fiables.
- Désindexer avec X-Robots-Tag : la documentation de Google est explicite, « to block indexing of non-HTML resources, such as PDF files, video files, or image files, use the X-Robots-Tag response header instead ». Concrètement, votre serveur renvoie un en-tête X-Robots-Tag: noindex sur le fichier concerné.
- Regrouper avec un canonical HTTP : Google accepte un en-tête Link: <URL>; rel="canonical" pour « a document supported by Search, including non-HTML documents such as PDF files ». La documentation précise que cette méthode ne vaut que pour la recherche web. C'est l'outil qui règle la cannibalisation entre un PDF et sa page.
- Bloquer avec robots.txt : cela empêche l'exploration, pas forcément l'affichage. Un PDF déjà connu peut rester visible, logique que nous avons expliquée dans notre guide du fichier robots.txt face aux crawlers IA.
- Protéger par mot de passe : Google indique que cette méthode empêche aussi le contenu d'apparaître dans la recherche. C'est la solution radicale pour les documents internes.
La page officielle « Control the Content You Share on Search » a justement été mise à jour le 21 octobre 2026 pour refléter l'ensemble des options disponibles, dont un contrôle dédié à l'IA générative de recherche dans la Search Console. Si vous ne voulez pas qu'un document nourrisse les Aperçus IA, c'est là que cela se règle.
La checklist Digital-m pour un PDF lisible par Google et par les IA
Voici le protocole que nous appliquons sur les bibliothèques de documents de nos clients. Comptez une heure pour une vingtaine de fichiers.
- Étape 1 : inventoriez vos PDF avec la requête site:votredomaine.fr filetype:pdf dans Google, puis recoupez avec le rapport Couverture de la Search Console.
- Étape 2 : testez la couche texte de chaque fichier par la méthode copier-coller. Tout PDF image part en reconnaissance optique de caractères.
- Étape 3 : renommez les fichiers en minuscules, avec des tirets, en plaçant le mot-clé en tête : catalogue-menuiserie-2026.pdf.
- Étape 4 : remplissez les propriétés du document, en particulier le champ Titre, et placez un vrai titre texte sur la première page.
- Étape 5 : allégez. Compressez les visuels, visez moins de 5 Mo pour un document commercial.
- Étape 6 : liez chaque PDF depuis au moins une page pertinente, avec une ancre descriptive.
- Étape 7 : arbitrez les doublons. Soit vous posez un canonical HTTP vers la page, soit vous désindexez le PDF avec X-Robots-Tag, soit vous enrichissez la page pour qu'elle passe devant.
- Étape 8 : sortez les chiffres et les tableaux du PDF pour les republier en HTML, là où Google et les moteurs génératifs peuvent les citer.
Cette dernière étape est celle qui rapporte le plus en visibilité IA, et c'est aussi celle que nous travaillons en priorité dans nos missions d'agence GEO. Un chiffre enfermé dans un PDF ne se cite pas. Le même chiffre, posé en texte dans le premier tiers d'un article, devient une réponse.
Ce qu'il faut retenir
Le SEO des PDF tient à une mécanique et à trois décisions. La mécanique, confirmée par Google le 14 octobre 2026 : un convertisseur transforme le PDF en HTML avant l'indexation, puis le classement suit les règles habituelles. Les trois décisions : garantir une couche texte sélectionnable, choisir entre page HTML et PDF selon l'usage réel du document, et piloter l'indexation avec les deux en-têtes HTTP documentés, X-Robots-Tag pour désindexer et Link rel="canonical" pour regrouper.
Retenez aussi ce qui échappe à Google : les images enfermées dans un PDF, et tout fichier scanné sans reconnaissance optique. Si votre meilleure étude, votre tarif ou votre argumentaire ne vivent que dans un PDF, ils travaillent à moitié, pour Google comme pour les moteurs génératifs.
Vous voulez savoir combien de vos PDF sont indexés, lesquels concurrencent vos propres pages et lesquels sont illisibles pour les IA ? Demandez un audit SEO et GEO à notre équipe. Et si vous préférez monter la compétence en interne, notre formation GEO certifiée Qualiopi consacre un module entier à la lisibilité machine de vos contenus, PDF compris.
Combien de PDF dorment sur votre site sans que vous sachiez s'ils sont indexés ? Dites-le nous en commentaire !Sources et références
- Search Engine Journal - Google Explains How They Rank PDFs And What It Means For SEO/GEO, Roger Montti (14 octobre 2026)
- Google Search Central - Robots meta tag, data-nosnippet, and X-Robots-Tag specifications
- Google Search Central - How to specify a canonical URL with rel="canonical" and other methods
- Google Search Central - Control the Content You Share on Search (mis à jour le 21 octobre 2026)
- Search Engine Roundtable - Google Updates URL Structure Best Practices For Hyphens In URLs, Barry Schwartz (21 octobre 2026)
- Google Search Central - Documentation updates log
Questions fréquentes sur le SEO des PDF
Un PDF peut-il se classer en première page de Google ?
Oui. Martin Splitt indique que l'indexation et le classement d'un PDF fonctionnent « pretty much the same as any other document ». Un PDF avec une couche texte, un titre clair et des liens entrants peut donc se positionner comme une page HTML. En pratique, une page bien construite reste plus facile à faire monter, parce qu'elle accepte les données structurées, un maillage interne fin et une mise à jour rapide.
Comment savoir si mes PDF sont indexés par Google ?
Tapez dans Google la requête site:votredomaine.fr filetype:pdf. Vous obtenez la liste des fichiers connus de l'index. Croisez ensuite ce résultat avec le rapport d'indexation des pages de la Google Search Console, qui vous dira quels fichiers ont été explorés et lesquels ont été écartés. L'écart entre les deux listes révèle souvent des PDF orphelins ou bloqués par le fichier robots.txt.
Peut-on mettre une balise noindex dans un PDF ?
Non, un PDF n'a pas de section head, donc pas de balise meta robots. Google documente l'alternative : l'en-tête de réponse HTTP X-Robots-Tag. Sa documentation précise que pour bloquer l'indexation de ressources non HTML comme les fichiers PDF, il faut utiliser cet en-tête. La configuration se fait côté serveur, dans Apache, NGINX ou via un module WordPress capable d'ajouter des en-têtes sur un type de fichier.
Les IA comme ChatGPT lisent-elles les PDF de mon site ?
Pour Google, c'est documenté : John Mueller confirme que les PDF indexés peuvent apparaître dans les Aperçus IA et le Mode IA. Pour ChatGPT, Gemini hors recherche Google, Perplexity, Mistral ou Grok, aucun éditeur ne publie de règle officielle sur le traitement des PDF, et nous ne pouvons donc rien affirmer. Le principe de précaution reste le même : republiez vos informations clés en HTML, format que tous les moteurs savent découper en passages citables.
Faut-il supprimer les PDF qui concurrencent mes pages ?
Rarement. Supprimer un PDF qui se positionne vous fait perdre ses liens entrants et son trafic. Trois options valent mieux : poser un en-tête Link rel="canonical" du PDF vers la page de référence, désindexer le PDF avec X-Robots-Tag en le laissant téléchargeable, ou enrichir la page HTML pour qu'elle reprenne naturellement l'avantage. Le choix dépend de la valeur de liens accumulée par le fichier, à mesurer avant toute décision.