Fin de GPT-4o : que faire avant le 14 janvier 2027 ?
Quatre-vingt-dix jours. C'est le délai qu'il reste aux entreprises qui font encore tourner leurs outils sur GPT-4o. Le 14 octobre 2026, OpenAI a publié un avis de dépréciation qui débranche cinq modèles de son API le 14 janvier 2027 : gpt-4o, gpt-4o-mini, gpt-4.1, gpt-4.1-mini et leurs versions affinées. Le remplaçant recommandé s'appelle gpt-6-luna, et il coûte vingt-cinq fois moins cher en entrée. Mais il ne se comporte pas du tout comme son prédécesseur, et il ne sait pas faire une chose que gpt-4o-mini faisait très bien. Voici le calendrier exact, les prix en euros, et les quatre points de contrôle à passer avant la coupure.
-
- Dernière modification
16 octobre 2026 - 8 minutes de lecture
Quels modèles OpenAI disparaissent, et à quelle date ?
Cinq modèles quittent l'API OpenAI le 14 janvier 2027, selon l'avis de dépréciation publié le 14 octobre 2026 sur la documentation officielle. La liste est courte et sans ambiguïté.
- gpt-4o : les instantanés gpt-4o-2024-08-06 et gpt-4o-2024-11-20. Remplacement recommandé : gpt-6-luna.
- gpt-4o-mini : l'instantané gpt-4o-mini-2024-07-18. Remplacement recommandé : gpt-6-luna.
- gpt-4.1 : l'instantané gpt-4.1-2025-04-14. Remplacement recommandé : gpt-6-luna.
- gpt-4.1-mini : l'instantané gpt-4.1-mini-2025-04-14. Remplacement recommandé : gpt-6-luna.
- Les versions affinées : tout modèle que vous avez vous-même entraîné sur l'un de ces quatre modèles suit exactement le même calendrier que son modèle de base.
Une seconde échéance, beaucoup plus proche, passe souvent inaperçue. Le 23 octobre 2026, c'est-à-dire dans une semaine, OpenAI débranche une douzaine de modèles plus anciens annoncés dès le 22 avril 2026 : gpt-3.5-turbo, gpt-4-0613, gpt-4-turbo, gpt-4.1-nano, l'instantané gpt-4o-2024-05-13, gpt-image-1, o1, o1-pro, o3-mini et o4-mini. Si l'un de ces identifiants traîne encore dans votre code, votre application tombera en panne la semaine prochaine, pas en janvier.
Horizon GEO • La newsletter
Ne ratez plus une sortie de modèle
Chaque semaine, l’actualité IA et LLM qui compte vraiment : nouveaux modèles, prix, benchmarks, et ce que ça change pour votre visibilité en ligne.
1 e-mail par semaine • Désinscription en 1 clic
Pourquoi 92 jours de préavis et pas six mois ?
Le préavis annoncé le 14 octobre pour une coupure au 14 janvier laisse exactement 92 jours. C'est deux fois moins que les six mois qu'OpenAI évoque habituellement pour ses modèles en disponibilité générale. L'entreprise n'a pas expliqué publiquement ce resserrement, et il faut le dire clairement : aucune déclaration officielle ne vient justifier ce calendrier à ce jour.
Le contexte, lui, est documenté. OpenAI a suspendu son offre ChatGPT Pro le 10 septembre 2026 faute de capacité de calcul disponible, et la pénurie mondiale de puces IA pèse sur toute la chaîne. Faire tourner en parallèle une dizaine de générations de modèles coûte des GPU que personne n'a en trop. L'hypothèse est raisonnable, elle n'est pas confirmée.
Deux autres dates complètent le calendrier. Le 6 janvier 2027, il ne sera plus possible de lancer un nouvel entraînement affiné sur ces modèles, même pour les clients existants. Le 20 janvier 2027, les versions audio et temps réel de gpt-4o suivent, avec leur propre échéance. Sur Azure, Microsoft annonce un calendrier distinct et plus long, avec un retrait des cinq instantanés au 14 avril 2027.
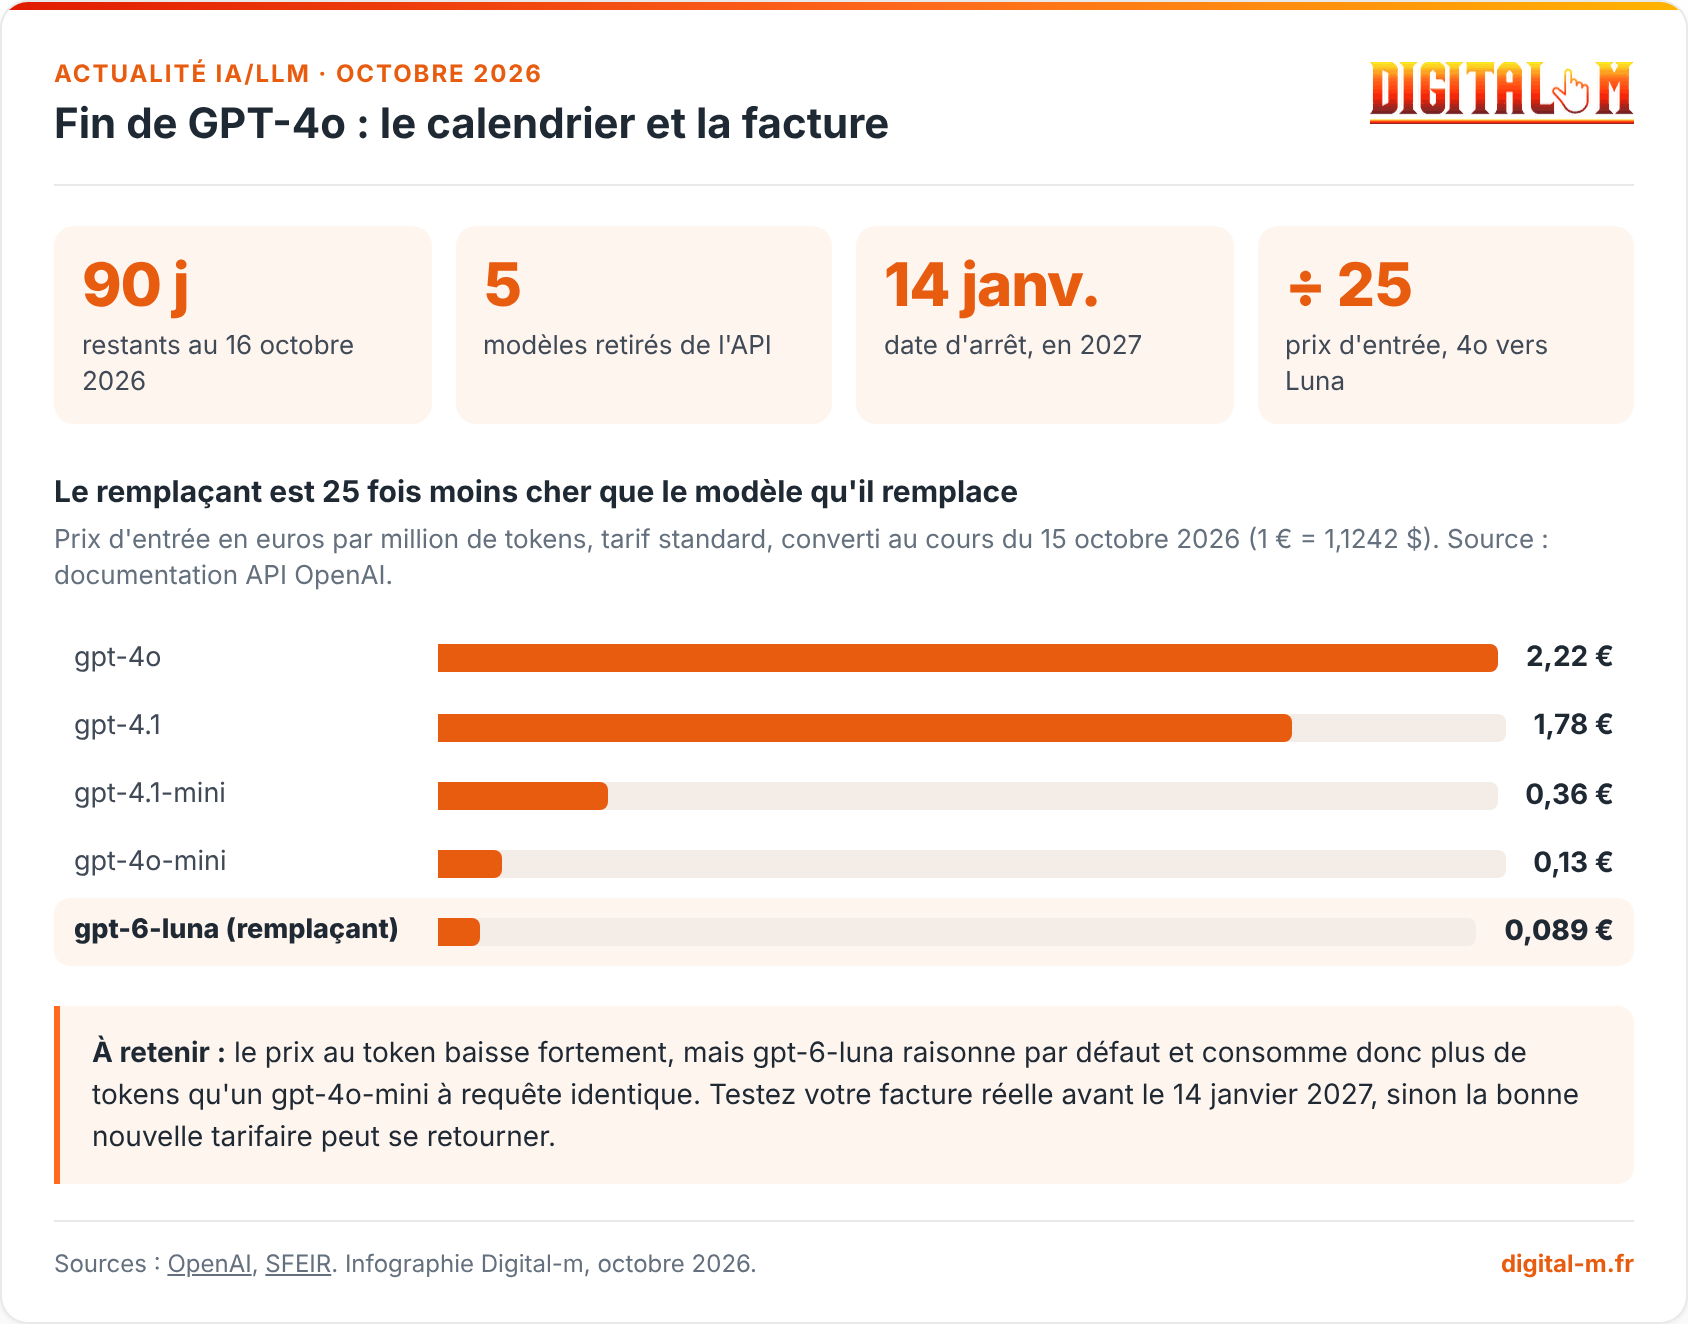
Fin de GPT-4o : le calendrier et la facture

- 90 j restants au 16 octobre 2026
- 5 modèles retirés de l'API
- 14 janv. date d'arrêt, en 2027
- ÷ 25 prix d'entrée, 4o vers Luna
Le remplaçant est 25 fois moins cher que le modèle qu'il remplace
Prix d'entrée en euros par million de tokens, tarif standard, converti au cours du 15 octobre 2026 (1 € = 1,1242 $). Source : documentation API OpenAI.
À retenir : le prix au token baisse fortement, mais gpt-6-luna raisonne par défaut et consomme donc plus de tokens qu'un gpt-4o-mini à requête identique. Testez votre facture réelle avant le 14 janvier 2027, sinon la bonne nouvelle tarifaire peut se retourner.
Télécharger l'infographie (PNG)
Combien coûte la migration vers gpt-6-luna ?
Sur le papier, la migration fait baisser la facture. Le tarif standard de gpt-6-luna est de 0,089 € par million de tokens en entrée et 0,44 € en sortie, contre 2,22 € et 8,90 € pour gpt-4o, soit un rapport de 25 à l'entrée et de 20 à la sortie. Les prix sont convertis depuis les tarifs en dollars au cours du 15 octobre 2026.
Voici le tableau complet, en euros par million de tokens, tarif standard.
| Modèle | Entrée | Sortie | Statut |
|---|---|---|---|
| gpt-4o | 2,22 € | 8,90 € | Retiré le 14/01/2027 |
| gpt-4.1 | 1,78 € | 7,12 € | Retiré le 14/01/2027 |
| gpt-4.1-mini | 0,36 € | 1,42 € | Retiré le 14/01/2027 |
| gpt-4o-mini | 0,13 € | 0,53 € | Retiré le 14/01/2027 |
| gpt-6-luna | 0,089 € | 0,44 € | Remplaçant recommandé |
Attention au piège arithmétique. Ces prix s'appliquent au token, l'unité de découpage du texte que facturent tous les fournisseurs, et pas à la tâche. Or gpt-6-luna raisonne par défaut au niveau « medium », c'est-à-dire qu'il produit une chaîne de réflexion interne avant de répondre, là où gpt-4o-mini répondait immédiatement. Une même requête peut donc générer trois à dix fois plus de tokens de sortie. Le prix unitaire chute, le volume monte, et le résultat net dépend entièrement de vos cas d'usage.
Deuxième piège : au-delà de 272 000 tokens d'entrée, gpt-6-luna facture le double en entrée et une fois et demie en sortie, sur l'intégralité de la requête. Si vous envoyez de gros documents en contexte, modélisez ce seuil avant de basculer. La question du prix réel des LLM en 2026 ne se règle jamais en comparant deux lignes de tarif.
Les quatre différences de comportement qui cassent une migration
Changer un identifiant de modèle dans un fichier de configuration ne suffit pas. Quatre écarts de comportement entre la famille GPT-4 et gpt-6-luna font échouer les migrations faites à la va-vite.
Le raisonnement est activé par défaut
gpt-6-luna raisonne au niveau « medium » si vous ne précisez rien. Les niveaux disponibles vont de « none » à « max ». Pour reproduire le comportement d'un gpt-4o-mini, réglez explicitement reasoning.effort sur « none ». Sans ce réglage, vos temps de réponse s'allongent et vos réponses changent de ton, ce qui se voit immédiatement sur un agent conversationnel en production.
L'appel d'outils dépend du mode de raisonnement
Sur l'ancien point d'entrée Chat Completions, le function calling, c'est-à-dire la capacité du modèle à déclencher vos propres fonctions, ne fonctionne avec gpt-6-luna que si l'effort de raisonnement est réglé sur « none ». Pour les outils intégrés, OpenAI recommande de passer à l'API Responses. Toute application qui combine outils et raisonnement doit donc changer de point d'entrée, pas seulement de modèle.
L'affinage n'existe pas sur Luna
C'est l'angle mort le plus coûteux. gpt-6-luna ne supporte pas le fine-tuning. Si vous avez investi dans un modèle affiné sur gpt-4o-mini, et des milliers de PME l'ont fait pour de la classification de tickets ou de l'extraction de données, il n'existe aucun équivalent direct. Il faudra soit basculer vers un autre modèle affinable de la gamme, soit reconstruire la tâche avec du prompt et de la récupération de contexte. Notre article sur le fine-tuning des LLM détaille les arbitrages.
La date de coupure des connaissances change
Passer de gpt-4o à gpt-6-luna déplace la date de coupure des connaissances du modèle. Tous vos prompts qui contiennent une formule du type « cette année » ou « la dernière version » produiront des réponses différentes. Chez Digital-m, nous auditons régulièrement des assistants clients dont la moitié des erreurs vient de ce décalage, jamais signalé dans les avis de dépréciation.
Comment savoir en dix minutes si vous êtes concerné
Trois contrôles suffisent pour cartographier votre exposition. Ils sont à faire aujourd'hui, pas en décembre.
- Chercher les identifiants dans tout le système : un simple git grep sur « gpt-4o » et « gpt-4.1 » ne suffit pas. Fouillez aussi les variables d'environnement, les fichiers de configuration, les drapeaux de fonctionnalité et les tables de base de données où un nom de modèle a pu être stocké.
- Interroger l'API elle-même : le point d'entrée de liste des modèles renvoie désormais un champ shutdown_date quand une échéance est publiée. Un script de quelques lignes vous sort la liste exacte des modèles condamnés que votre clé utilise.
- Bloquer l'intégration continue : ajoutez un test qui échoue si le modèle configuré porte une date d'arrêt. Et remplacez les alias génériques par des identifiants d'instantané datés, pour ne plus jamais être surpris par un basculement silencieux.
- Centraliser l'identifiant : un seul endroit dans votre configuration doit contenir le nom du modèle. Si vous le cherchez à trois endroits, c'est déjà trop.
- Évaluer avant de basculer : montez un jeu de tests de vingt à cinquante cas réels et comparez les sorties. L'avis d'OpenAI recommande un remplaçant, il ne garantit aucune équivalence de qualité.
Quels modèles considérer si Luna ne convient pas
Le remplaçant recommandé par OpenAI n'est pas le seul choix, et une dépréciation forcée est une bonne occasion de remettre son fournisseur en concurrence. Trois pistes se tiennent en octobre 2026.
Du côté de Google, Gemini 4 Argon est accessible à tous les clients payants depuis le 13 octobre 2026, à environ 1,78 € le million de tokens en entrée et 8,90 € en sortie, tarif promotionnel valable jusqu'au 30 novembre 2026, avant un passage à 3,56 € et 17,79 €. Google revendique la première place sur l'indice Vals, un classement d'éditeur qu'aucun tiers indépendant n'a répliqué à ce jour.
Du côté européen, Mistral Large 4 affiche 1,21 € le million de tokens pour 1 050 milliards de paramètres, mais se classe 32e sur 44 en évaluation indépendante. Du côté des modèles ouverts, Nvidia a annoncé le 15 octobre Nemotron 3.5 Bolt, 74 milliards de paramètres dont 9 actifs, quantifié en 2 bits pour tenir dans 24 Go de mémoire, ce qui le rend exploitable sur une seule carte graphique professionnelle. Pour les traitements sensibles, c'est une alternative crédible à l'API, et faire tourner un modèle en local devient une option sérieuse pour les traitements confidentiels.
Ce que ce calendrier dit du marché des LLM
La leçon de fond dépasse largement GPT-4o. Un modèle d'IA accessible par API n'est pas un logiciel que vous installez une fois : c'est un service qui peut disparaître avec trois mois de préavis. En 2026, OpenAI a publié deux vagues de dépréciation à six mois d'intervalle, et une troisième est déjà programmée pour le 1er avril 2027 avec gpt-5.1 et gpt-5.3-codex.
Concrètement, cela change deux choses dans la façon de construire. D'abord, isolez l'appel au modèle derrière une couche d'abstraction maison, pour que changer de fournisseur reste un travail d'une journée et non d'un trimestre. Ensuite, budgétez une ligne « migration de modèle » deux fois par an, comme vous budgétez les mises à jour de votre CMS.
Chez Digital-m, nous voyons passer beaucoup de projets où l'identifiant de modèle est codé en dur dans quatre fichiers différents, parfois dans un plugin WordPress que plus personne ne maintient. C'est précisément ce type de dette qui transforme un avis de dépréciation en panne de production. Si vous voulez faire le point sur votre dépendance aux API d'IA, notre équipe peut auditer votre stack et vous rendre une cartographie exploitable : parlons-en.
Ce qu'il faut retenir
La fin de GPT-4o dans l'API OpenAI est fixée au 14 janvier 2027, avec gpt-4o-mini, gpt-4.1, gpt-4.1-mini et toutes leurs versions affinées. Il reste 90 jours au 16 octobre 2026. Une échéance plus proche, le 23 octobre 2026, concerne gpt-3.5-turbo, gpt-4-turbo, gpt-4.1-nano, o1, o3-mini et o4-mini.
Le remplaçant recommandé, gpt-6-luna, coûte 0,089 € par million de tokens en entrée contre 2,22 € pour gpt-4o, mais il raisonne par défaut, ne supporte pas l'affinage, et change de comportement sur l'appel d'outils. La baisse de prix unitaire ne garantit donc aucune baisse de facture.
Les trois actions à mener cette semaine : recenser tous les endroits où un identifiant de modèle est écrit, interroger le champ shutdown_date de l'API, et monter un jeu d'évaluation avant tout basculement. Si votre site, votre chatbot ou vos automatisations reposent sur ces modèles, un audit technique de quelques heures vous évitera une panne en pleine période de janvier. Et si vous préférez monter vos équipes en compétence, nos formations certifiées Qualiopi couvrent l'intégration des LLM dans un environnement de production.
Et vous, savez-vous combien d'appels à gpt-4o tournent encore dans vos outils ? Dites-le nous en commentaire !Sources et références
- OpenAI - Deprecations, documentation officielle de l'API (consultée le 16 octobre 2026)
- SFEIR - IA : les brèves de la semaine du 8 au 15 octobre 2026
- ActuIA - Veille IA du 14 octobre 2026
- Gabriel Anhaia - GPT-4o and GPT-4.1 Leave OpenAI's API on January 14, 2027 (14 octobre 2026)
- VentureBeat - OpenAI releases GPT-6 Sol and Luna models, slashing API costs 50% or more
- Boursorama - Les craintes sur la dette liée à l'IA bousculent à nouveau les Bourses mondiales (15 octobre 2026), pour le cours EUR/USD de référence
Questions fréquentes sur la fin de GPT-4o
GPT-4o disparaît-il aussi de l'application ChatGPT ?
L'avis de dépréciation du 14 octobre 2026 porte sur l'API, c'est-à-dire l'accès programmatique utilisé par les développeurs et les intégrations. OpenAI gère séparément les modèles proposés dans l'interface grand public de ChatGPT, et n'a pas publié de calendrier identique pour celle-ci. Si vous utilisez ChatGPT dans votre navigateur, vous n'avez rien à migrer vous-même.
Que se passe-t-il concrètement le 14 janvier 2027 si je n'ai rien fait ?
Les appels vers les identifiants retirés renvoient une erreur et ne produisent plus de réponse. Concrètement, un chatbot cesse de répondre, une automatisation de classification s'arrête, un générateur de fiches produit renvoie une page blanche. Il n'y a pas de bascule automatique vers le modèle de remplacement : OpenAI recommande gpt-6-luna, mais c'est à vous de changer l'identifiant.
Mon modèle affiné sur gpt-4o-mini est-il perdu ?
Il suit le calendrier de son modèle de base, donc le 14 janvier 2027, et la création de nouveaux entraînements s'arrête dès le 6 janvier 2027. Comme gpt-6-luna ne supporte pas l'affinage, il n'existe pas de migration directe. Conservez votre jeu de données d'entraînement : c'est l'actif réutilisable, que ce soit pour affiner un autre modèle de la gamme OpenAI ou pour reconstruire la tâche avec de la récupération de contexte.
Faut-il profiter de cette migration pour changer de fournisseur ?
C'est le bon moment pour poser la question, puisque le travail d'intégration doit être refait de toute façon. Gemini 4 Argon, Mistral Large 4, Claude et les modèles ouverts comme Nemotron ou Qwen méritent un passage sur votre jeu d'évaluation. Le critère décisif n'est presque jamais le benchmark public, mais le coût réel sur vos propres requêtes et la stabilité du calendrier de dépréciation du fournisseur.
Comment éviter de revivre cette urgence dans six mois ?
Trois réflexes d'architecture suffisent : centraliser l'identifiant de modèle dans un seul fichier de configuration, utiliser des instantanés datés plutôt que des alias génériques, et ajouter un test automatisé qui lit le champ shutdown_date de l'API et fait échouer la chaîne d'intégration continue dès qu'une échéance apparaît. Une dépréciation devient alors une tâche planifiée, pas un incident.